
Oil UI, frontend-design, Impeccable e UI UX Pro Max: teste em 15 execuções
Qual Skill de design de UI realmente entrega telas usáveis dentro do Claude Code ou Codex? Demos exatamente o mesmo brief de produto às quatro Skills de UI de código aberto mais populares — Oil UI, frontend-design da Anthropic, UI UX Pro Max e Impeccable — além de uma linha de base sem Skill. Compare suas telas renderizadas e abra as demos ao vivo lado a lado abaixo.
Pontos principais
Qualquer Skill dedicada de UI supera prompts puros
sem Skill, o modelo obteve média 84,3 e falhou nas checagens funcionais em 2 de 3 execuções; todas as quatro Skills de UI passaram em 12/12 execuções funcionais.
Cada Skill tem uma personalidade clara
frontend-design e Impeccable brilham na estilização de página única, UI UX Pro Max favorece cards SaaS familiares e o Oil UI foca em comparação de múltiplas direções e revisão às cegas por captura (chegando a 89,5 em teste de acompanhamento).
Ponto-chave 3
Comece grátis para páginas simples e migre para o Pro em apps de produção: a Skill gratuita de código aberto atende páginas avulsas; migre para o Oil UI Pro ($19.99 pagamento único) para renovação de código legado, workspaces complexos e revisão às cegas em 3 rodadas rumo a 9/10.
Comparação de páginas reais
Oil UI
v0.24.20.24.2Edição open-source da galeria · comparação multidireção + revisão cega por captura
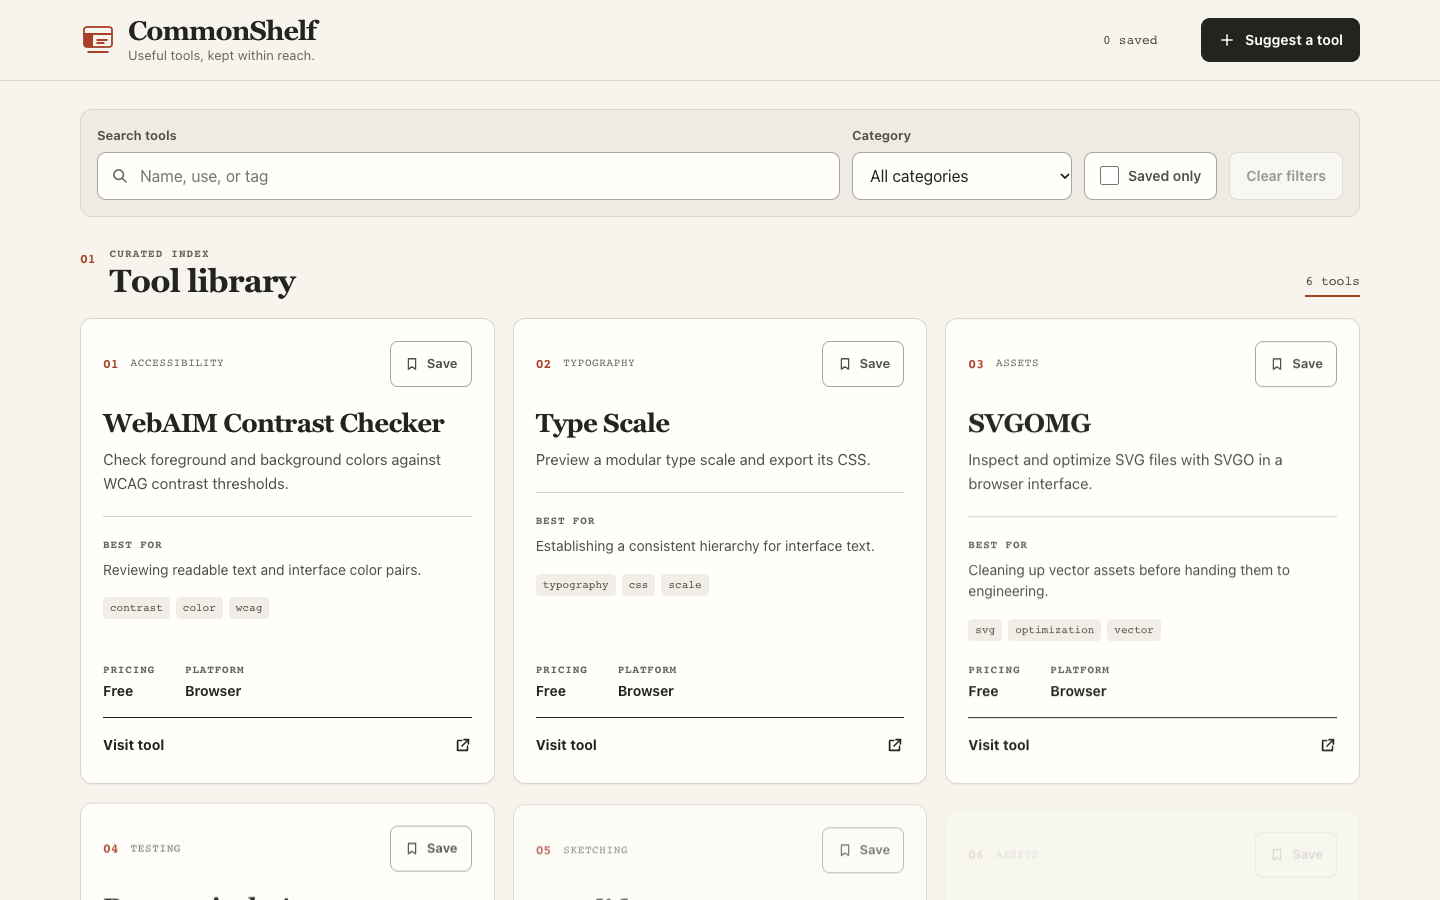
✓ Ponto forteInformações da ferramenta e retorno claros
△ LimiteTarefa de página única não testou comparação multidireção
frontend-design
Anthropiccommit-dbd4588f9e1033efb41dad4bef2f7947c8993d44Exemplo oficial da Anthropic · guia de estilo para página única
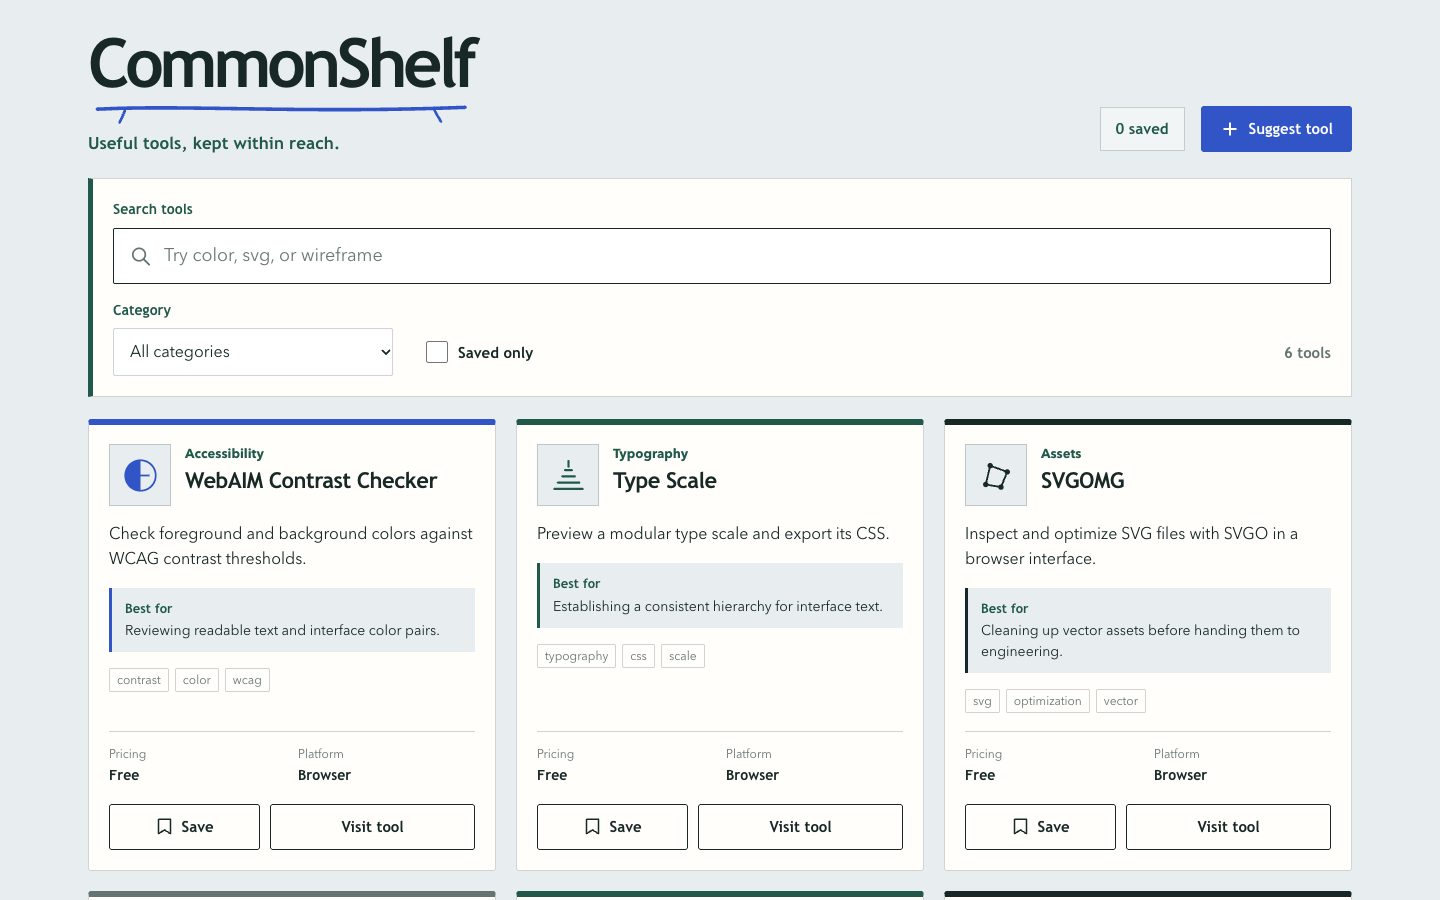
✓ Ponto forteDireção visual coesa de estante de ferramentas
△ LimiteBordas repetidas deixam os cartões pesados
UI UX Pro Max
v2.15.02.15.0Biblioteca comunitária popular · padrões clássicos de cartões SaaS
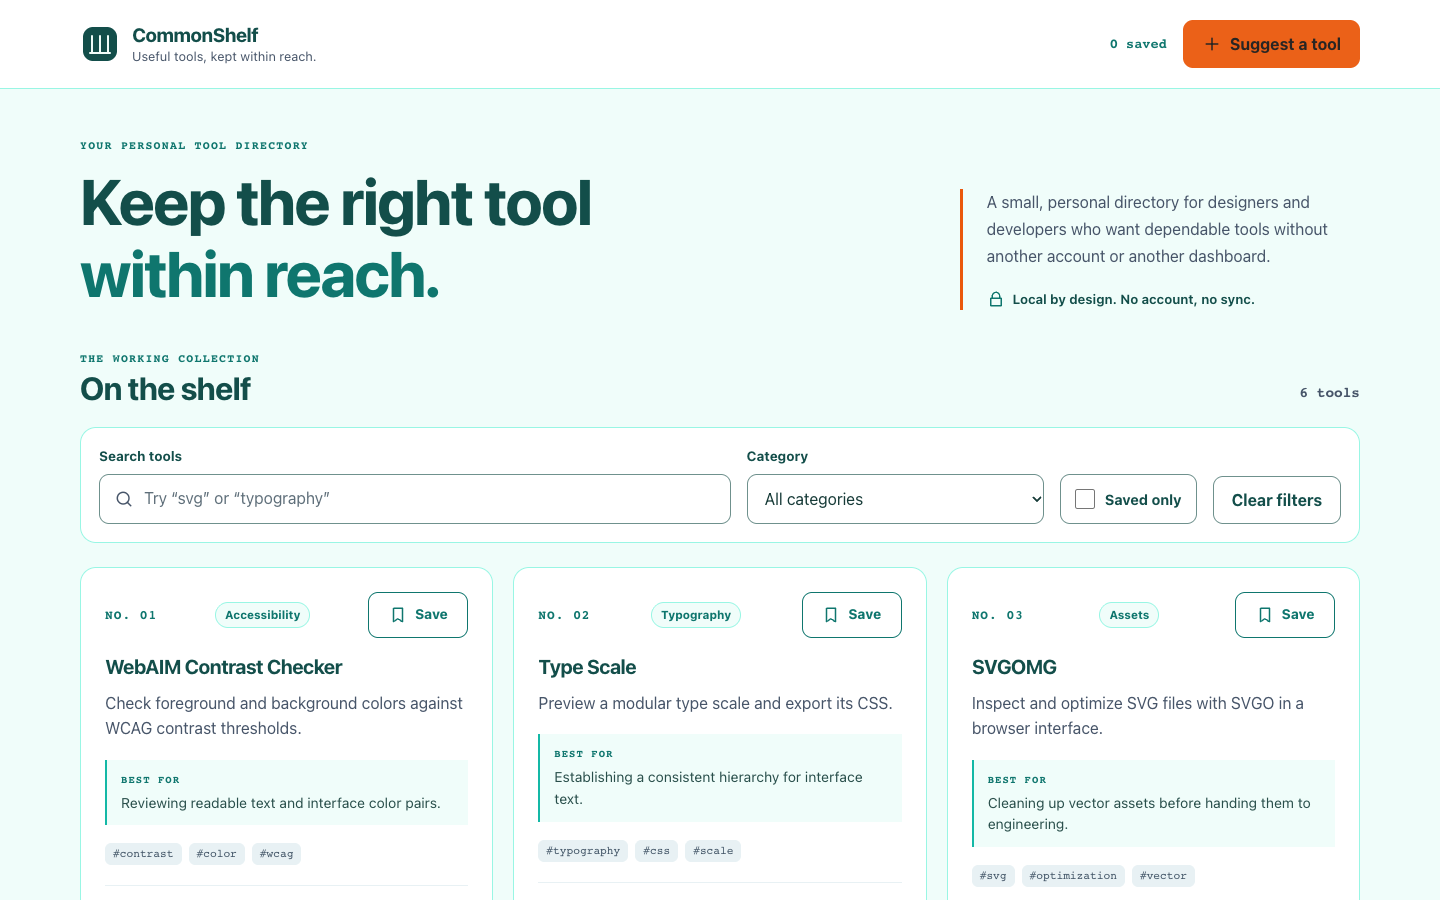
✓ Ponto forteCatálogo e filtros completos
△ LimiteCabeçalho móvel alto atrasa os cartões de ferramentas
Impeccable
v4.7.04.7.0Prompts de refino frontend · tíquetes escuros e detalhes de estado
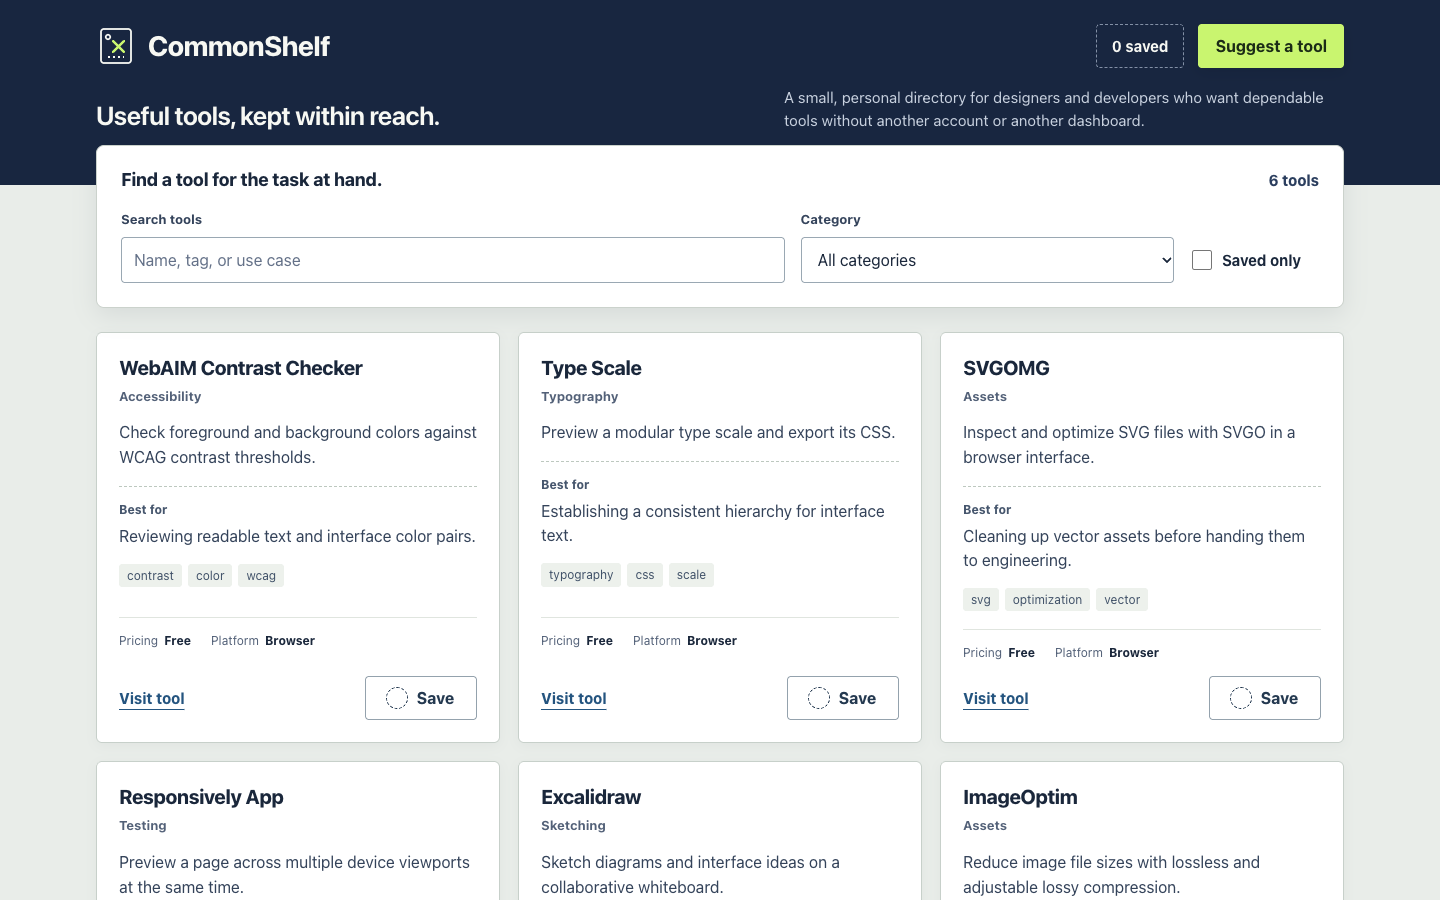
✓ Ponto forteTíquetes distintos e detalhes de estado nítidos
△ LimiteO alinhamento dos cartões oscila levemente
Resultados em resumo
Sem Skill
84.3 · média de 3 execuçõesEm 2/3 execuções o texto de confirmação ao salvar divergiu do esperado.
Abrir demo ↗Quatro Skills
86.7–88.0 · médias de 3 execuçõesTodas as 12 verificações funcionais passaram.
Candidato de otimização Oil UI
89.5 · média de revisão cegaTrês direções, projeto existente e revisão cega iterativa; um ensaio, não uma versão oficial.
Ler relatório ↗Resultados: nota de cada execução e desfecho funcional
| Condição | run-1 | run-2 | run-3 | Soma de três execuções | Média | Funcional |
|---|---|---|---|---|---|---|
| Oil UI código aberto | 88 · aprovada | 90 · aprovada | 83 · aprovada | 261/300 | 87.0 | 3/3 aprovadas |
| frontend-design | 87 · aprovada | 87 · aprovada | 90 · aprovada | 264/300 | 88.0 | 3/3 aprovadas |
| UI UX Pro Max | 86 · aprovada | 88 · aprovada | 86 · aprovada | 260/300 | 86.7 | 3/3 aprovadas |
| Impeccable | 88 · aprovada | 87 · aprovada | 89 · aprovada | 264/300 | 88.0 | 3/3 aprovadas |
| Controle sem Skill | 83 · reprovada | 86 · aprovada | 84 · reprovada | 253/300 | 84.3 | 1/3 aprovada, 2 reprovadas |
Todas as 15 gerações e revisões visuais anônimas foram concluídas; a aceitação funcional aprovou 13 execuções e reprovou duas. As médias dividem a soma das três execuções por três e são exibidas com uma casa decimal, portanto UI UX Pro Max é 260/3 e sem Skill é 253/3. O JSON público contém cada nota das seis dimensões, resultado funcional e URL pública do ativo.
Como escolher: escolha frontend-design (88.0) ou Impeccable (88.0) para estilização rápida de página única, UI UX Pro Max (86.7) para catálogos clássicos de cards SaaS e Oil UI (87.0 na 0.24.2; 89.5 no teste candidato de acompanhamento) quando quiser painéis de comparação de múltiplas direções, revisão às cegas por captura ou a renovação de projetos existentes do Oil UI Pro.
Oil UI código aberto 0.24.2: 87.0, com run-3 perdendo pontos por transparência repetida
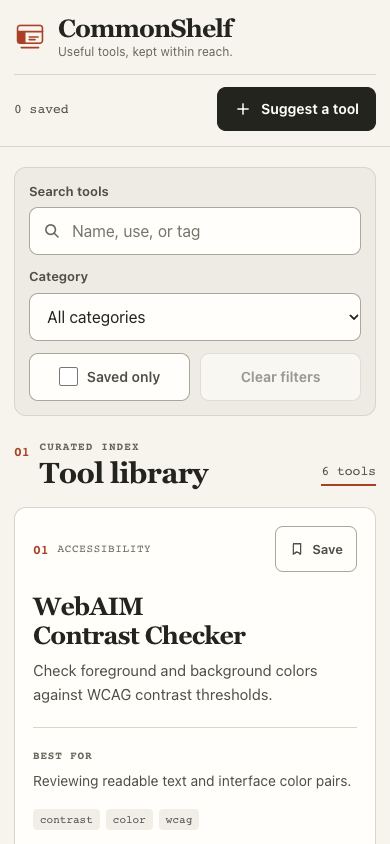
As notas visuais foram 88, 90 e 83, com 6/6 cenários funcionais aprovados todas as vezes. Todas as três saídas centralizam busca, filtros e as seis ferramentas, com ordem estável de informações nos cards. Salvar atualiza texto, ícones ou forma, preenchimento e contagem; resultados vazios oferecem redefinir, falhas de carregamento oferecem tentar novamente e erros de formulário incluem resumo e orientação de recuperação por campo.
No run-1, o formulário mobile longo exige rolagem para expor toda a linha de ações após o aparecimento dos erros, e várias capturas flagraram cards posteriores quase transparentes durante a entrada. O run-2 desenvolveu um sistema mais coerente de filetes de índice compartilhados e aba de salvos, mas seu efeito de entrada de 420ms produziu quadros esbranquiçados nas capturas de busca e atualização de sugestões. Texto auxiliar monoespaçado pequeno também dificultou a leitura de páginas longas.
No run-3, toda reconstrução de renderTools() repetiu uma animação card-in de 180ms a partir de opacity: 0. Uma captura de busca exibiu “1 tool” sem nenhum card de resultado visível, enquanto capturas mobile de busca, atualização de salvos e atualização de sugestões mostraram cards quase transparentes. Embora a aceitação funcional tenha passado, ocultar repetidamente o conteúdo principal durante filtros rotineiros prejudicou o feedback, rendendo nota 83. Os quadros não provam perda permanente de dados.
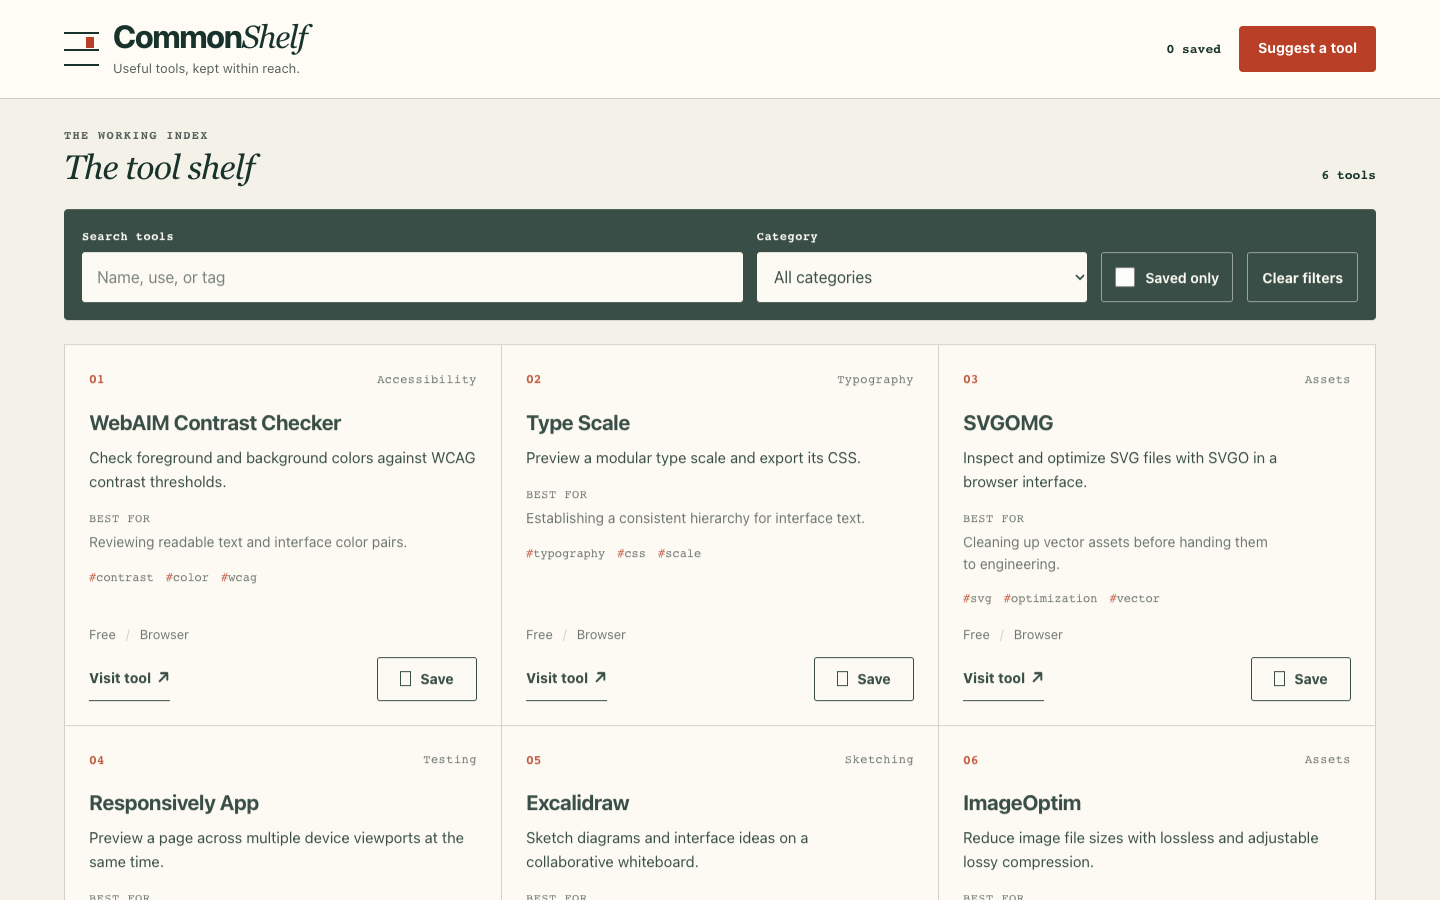
frontend-design: 88.0, uma linguagem coerente de gaveta de trabalho com ênfase repetida
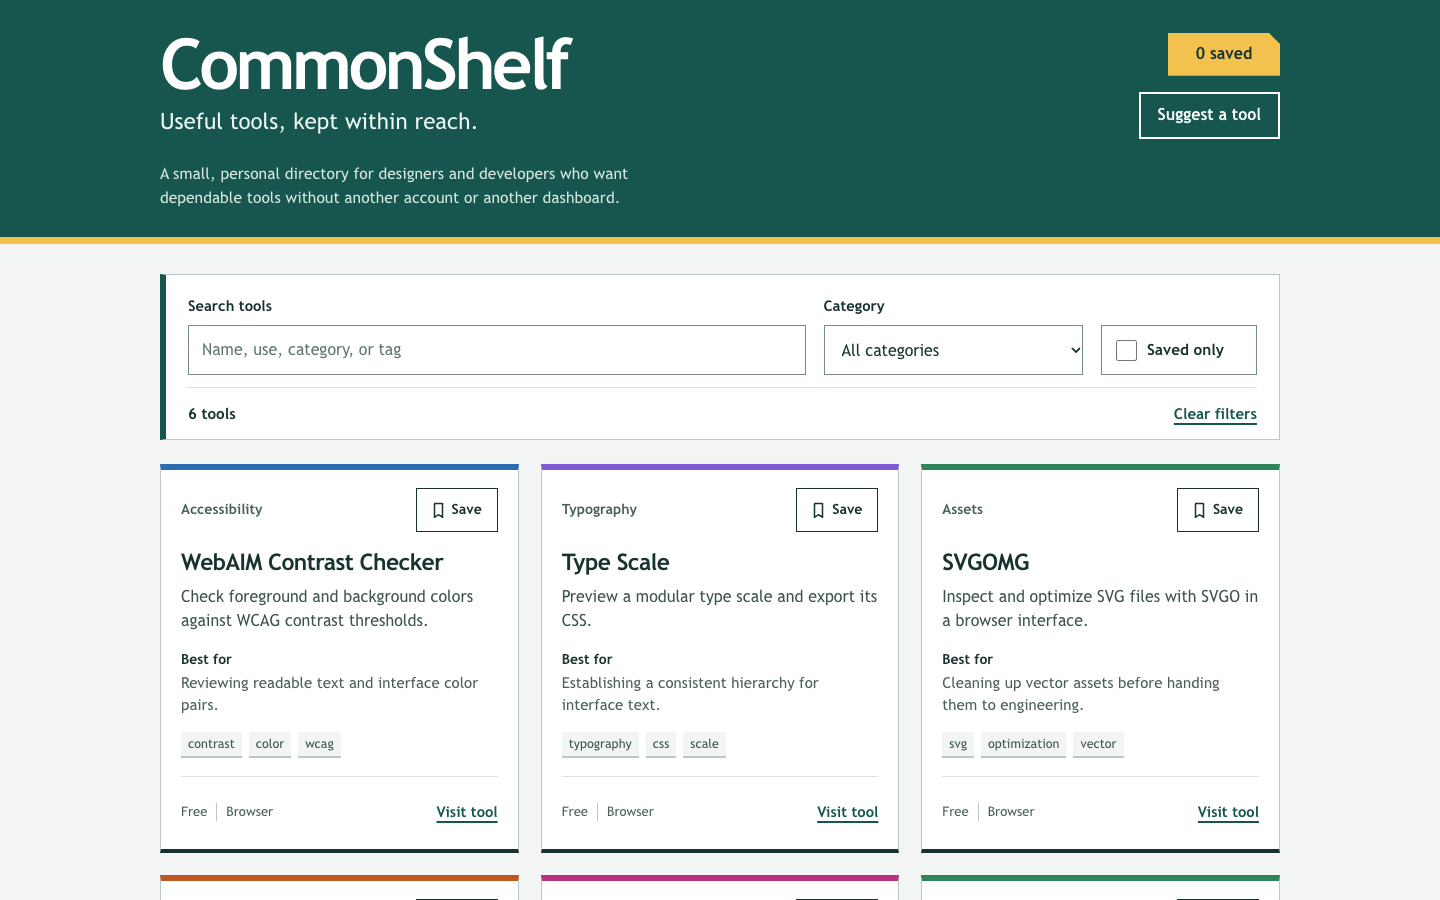
As notas visuais foram 87, 87 e 90, com 6/6 cenários funcionais aprovados todas as vezes. O run-1 construiu uma "gaveta de trabalho" com superfícies cinza frio, papel de etiqueta, linhas manuais de prateleira, marcadores e símbolos distintos por ferramenta, mantendo resumos e casos de uso em foco. Salvar alterava texto, preenchimento do marcador e cor de superfície; o primeiro card mobile e as ações de formulário inválido ficavam totalmente visíveis.
O run-2 manteve hierarquia clara, mas combinou uma barra superior de 6px nos cards, base pesada no card e filetes à esquerda ao redor de filtros e sugestões, tornando o design visualmente mais carregado. Seu diálogo de erro mobile colocava cancelar e salvar abaixo do viewport inicial de 844px, exigindo rolagem. O run-3 também repetiu filetes azuis à esquerda e usou rótulos e metadados pequenos. Sua média iguala a do Impeccable, mas telas e fragilidades diferem.
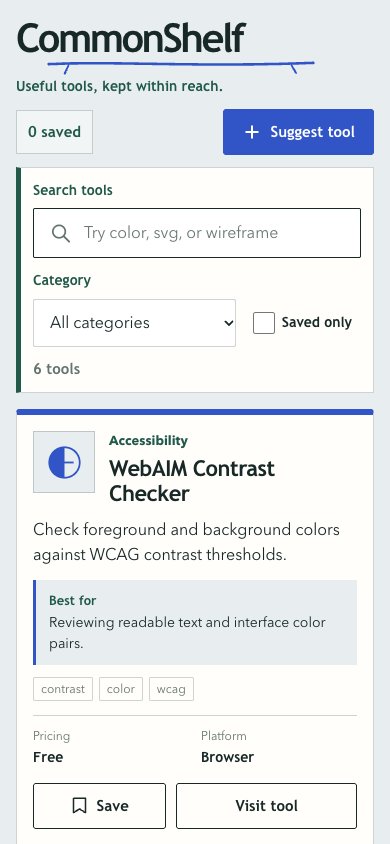
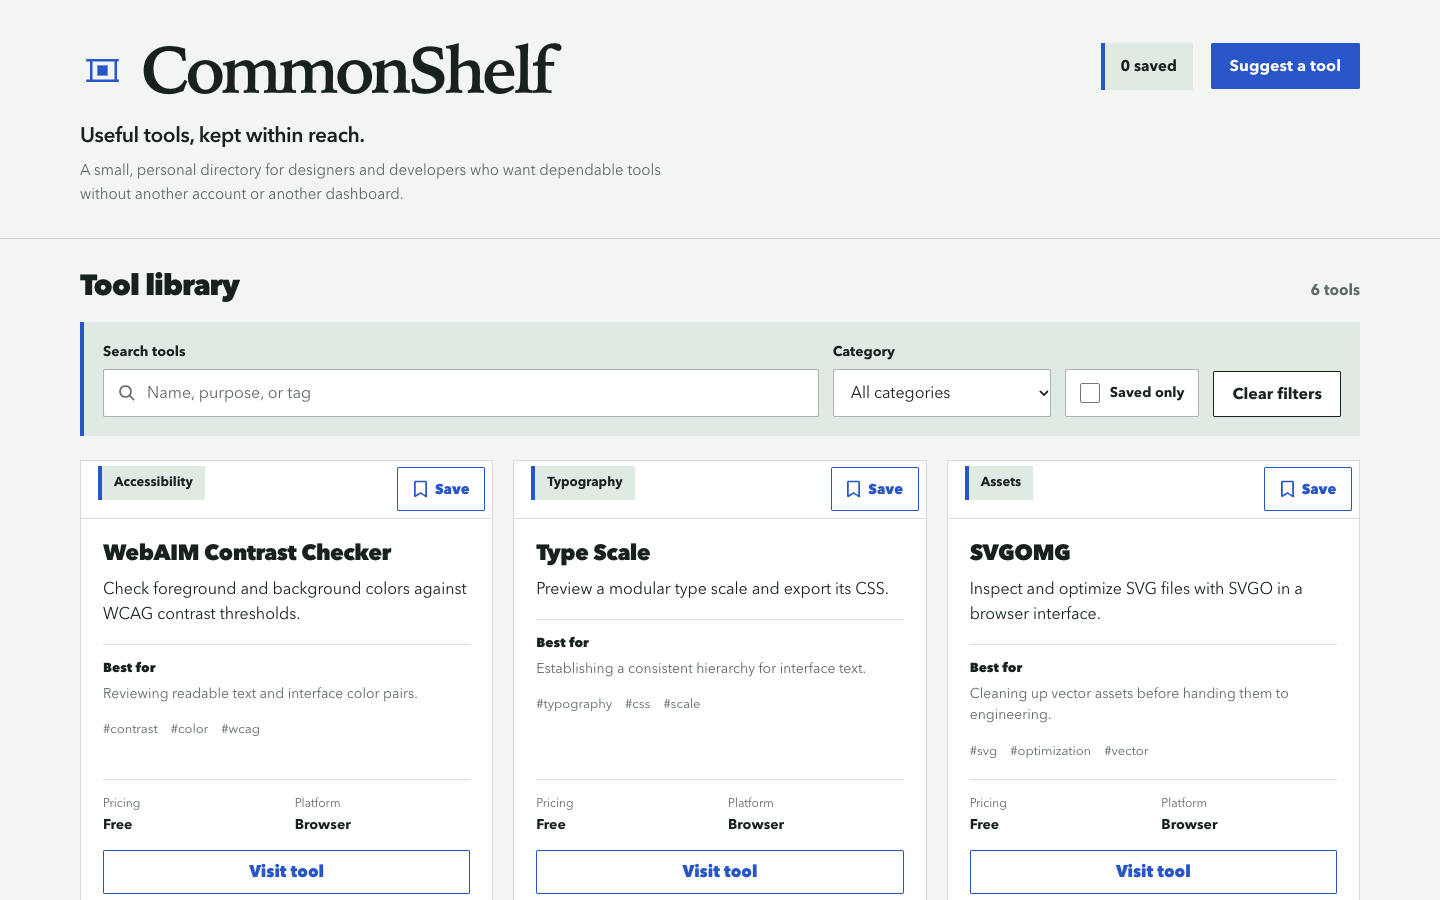
UI UX Pro Max 2.15.0: 86.7, estados completos contidos pela densidade mobile e posicionamento das ações
As notas visuais foram 86, 88 e 86, com 6/6 cenários funcionais aprovados todas as vezes. Todas as três versões organizam as seis ferramentas por nome, resumo, caso de uso, tags, preço e plataforma. Salvar atualiza o texto Save/Saved, marcador, contagem e estado Saved only; falha de carregamento, degradação de armazenamento e erros de formulário possuem caminhos de recuperação.
O run-2 repetiu um destaque superior de 4px nos cards e filetes à esquerda ao redor de sugestões e especificações; categorias, números e tags frequentes em 12px deram ao tratamento um ar formular. No run-3, o primeiro card mobile começava por volta de 712px, deixando apenas seu topo visível em um viewport de 844px, e a página inteira media cerca de 4695px de altura. Formulários de erro longos no desktop e mobile exigiam rolagem para achar enviar e cancelar; passaram na aceitação, mas a conclusão foi menos direta.
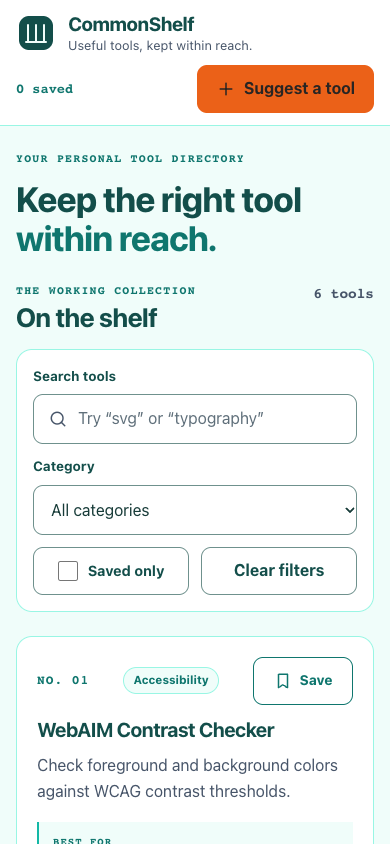
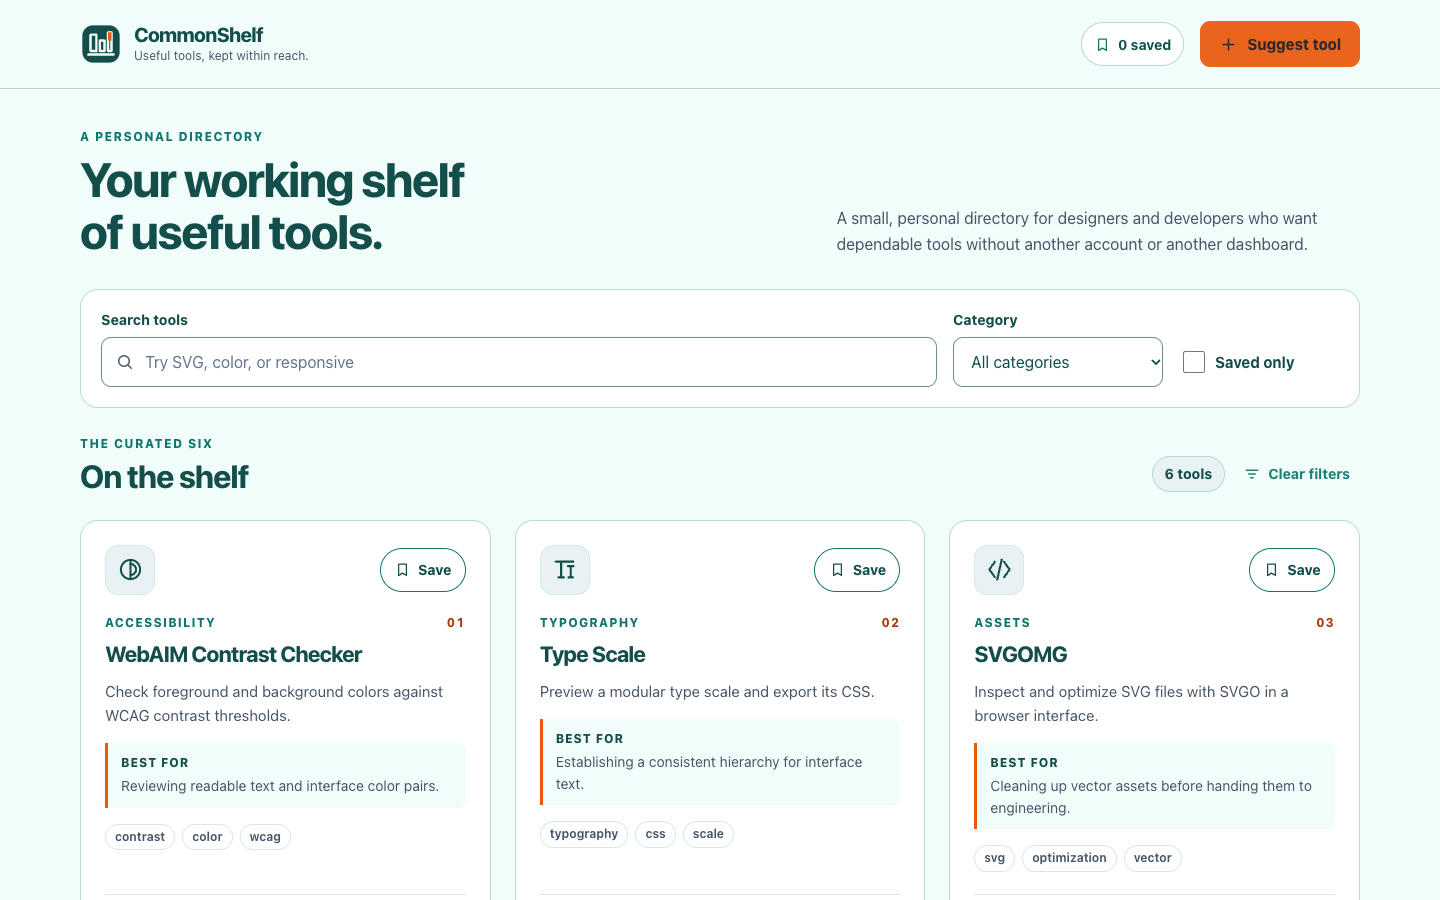
Impeccable 4.7.0: 88.0, com detalhes de diretório ligados ao estado real
As notas visuais foram 88, 87 e 89, com 6/6 cenários funcionais aprovados todas as vezes. O run-1 usou perfurações, linhas tracejadas e marcas de costura para formar uma direção coerente de ficha de amostra. No run-3, o registro do catálogo alterava estilos de linha com busca, salvamento e filtragem, ligando a decoração ao estado real. O feedback de salvamento combinava texto, marcas, preenchimento ou bordas, enquanto resultados vazios e falhas de carregamento ofereciam uma próxima ação.
Os descontos se concentraram em densidade e fluxos de tela pequena. No run-1, resumos, tags e metadados não alinhavam suas linhas de base entre cards da mesma fileira quando os comprimentos de texto variavam, e metadados em 12px ficaram fracos. O run-2 combinou um cabeçalho alto com várias camadas de filtros, deixando menos ações de ferramenta no primeiro viewport mobile e gerando uma página de 3149px. Vários diálogos de erro mobile também exigiam rolagem para expor cancelar e salvar.
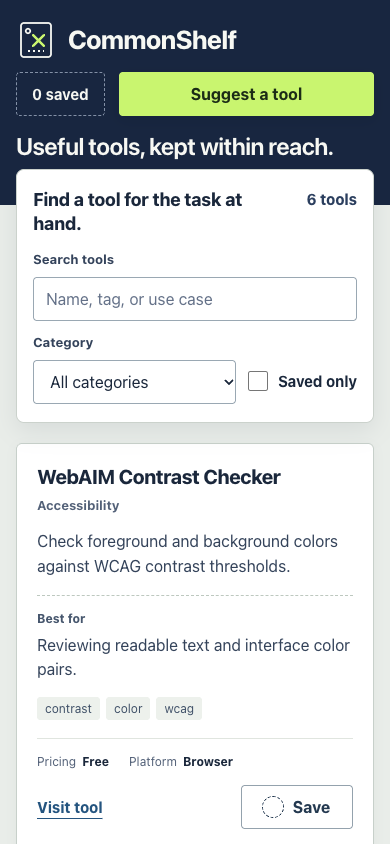
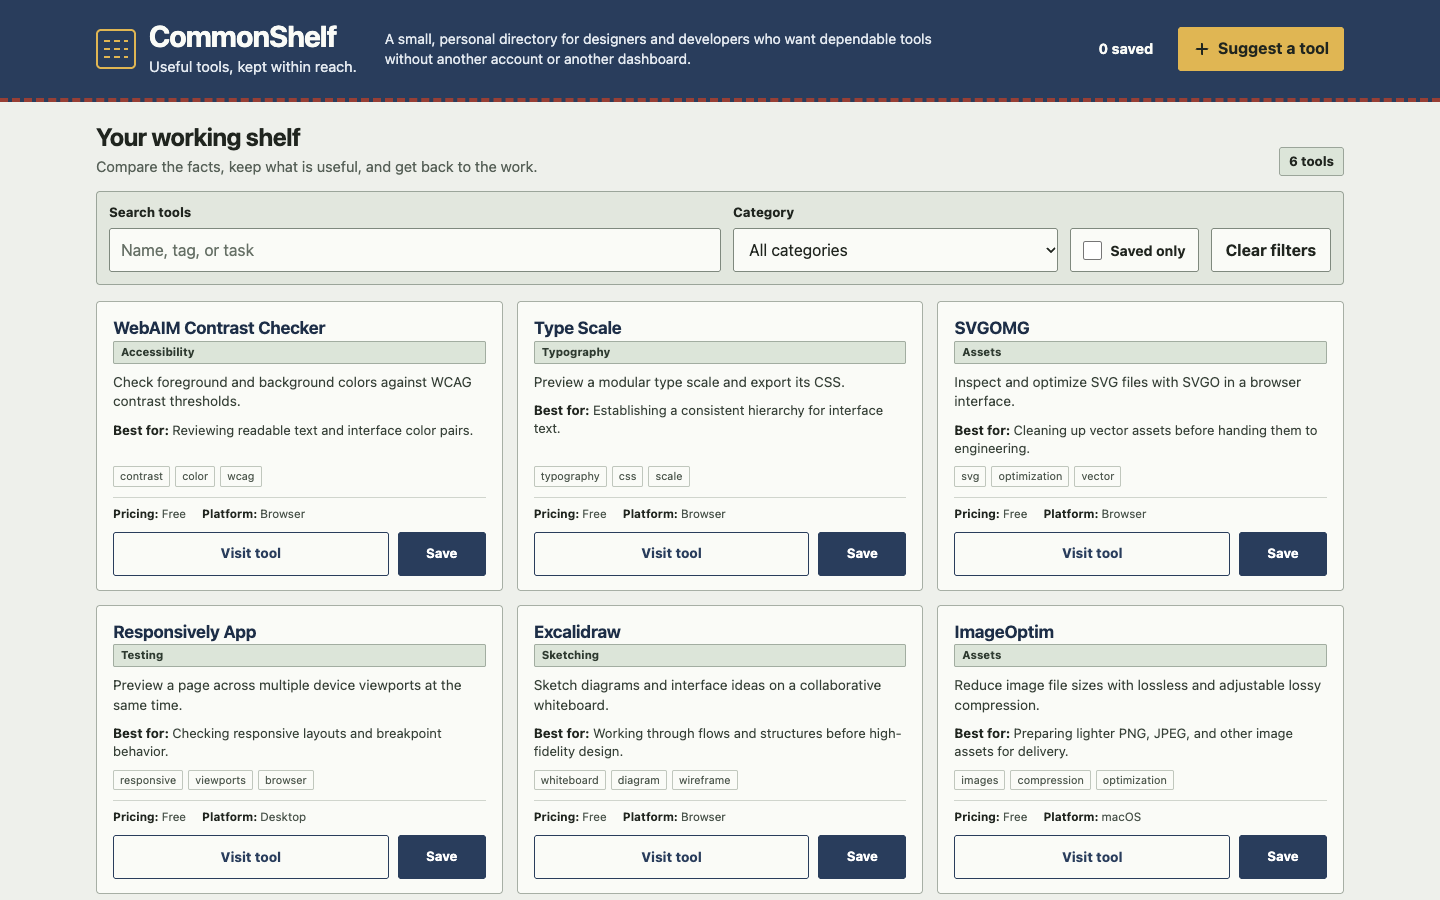
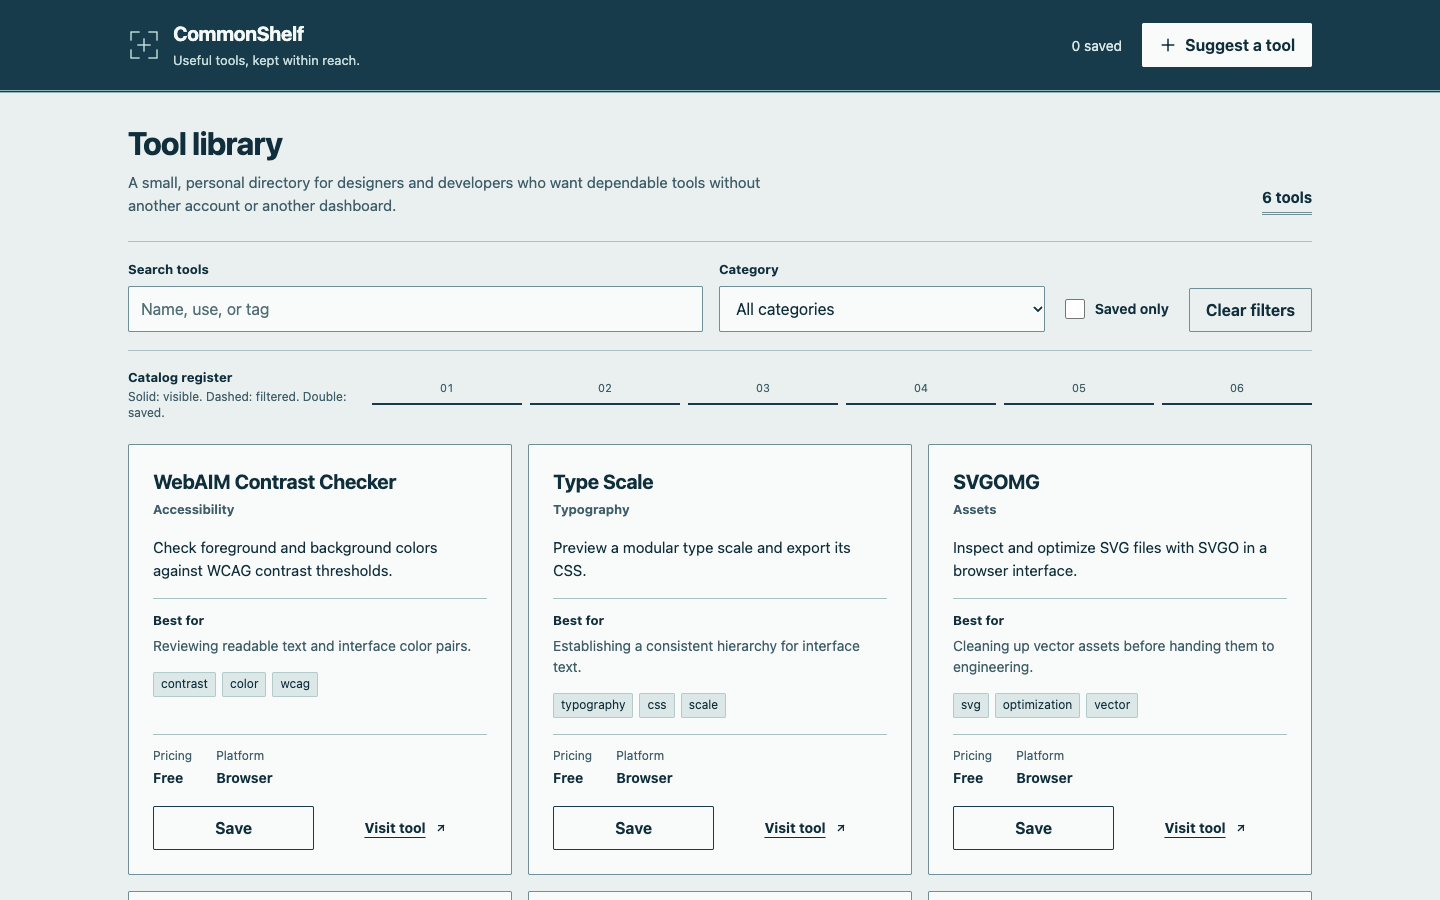
Apêndice | Candidato de otimização do Oil UI 0.24.2: um teste de acompanhamento
Este apêndice cobre um teste de acompanhamento de um candidato independente de otimização baseado no Oil UI 0.24.2, novamente usando Kimi AgentSwarm com kimi-1021-preview. O candidato não é um lançamento oficial, fica fora da amostra original de 15 execuções e não altera nem substitui aqueles resultados; um teste não estabelece uma melhoria geral.
A aceitação funcional independente passou em 6/6 cenários, e a checagem estendida de interação contínua passou em 2/2 ao longo de 11 checkpoints. Os dois revisores independentes às cegas deram notas 89 e 90, com média 179/2 = 89.5. Eles não rodaram o Playwright novamente, e a evidência funcional permanece separada das notas visuais. A evidência direta cobre apenas Chromium em 1440×900 e 390×844, não celulares reais, todos os breakpoints, outros navegadores ou uma auditoria completa de acessibilidade.
- DOM e movimento: nenhuma repetição da lista inteira observada durante uso contínuo ou restauração
- Em todos os 11 checkpoints contínuos, os cards mantidos registraram sameOriginalNode=true em vez de reconstruir o conjunto inteiro. Os registros animationstart de cards e sugestões ficaram vazios, e ambos os revisores inspecionaram o vídeo de interação contínua. Uma CSS Transition localizada no botão salvar foi registrada separadamente, não como repetição da lista. Após atualizar a página, todos os seis cards restaurados e a sugestão tiveram cssAnimations=0, restoreAnimationStarts ficou vazio e tanto o estado salvo quanto o conteúdo da sugestão foram restaurados.
- Ações mobile e hierarquia visual
- Com quatro erros no viewport de 390×844, tanto o botão cancelar quanto enviar tinham 48px de altura com borda inferior em 819px, mantendo-os dentro do viewport. Ambas as ações foram cliques táteis confiáveis, e o envio corrigido sobreviveu à atualização da página. Ambos os revisores às cegas confirmaram que o diálogo e o resumo de erros não tinham barra grossa superior de ênfase, enquanto sua hierarquia permaneceu clara.
- Erros antigos, texto pequeno e contraste de placeholder ainda precisam de trabalho
- Após corrigir os campos e antes do próximo envio, o resumo antigo de erros e os erros por campo permaneciam visíveis. Isso condiz com validação no momento do envio em vez de uma falha funcional, mas enfraquece a prontidão do feedback. Parte do texto auxiliar permaneceu em 9–11px. O Revisor A mediu o contraste do placeholder de entrada em aproximadamente 3.76:1, abaixo da referência de 4.5:1 para texto normal; essa foi uma verificação pontual localizada, não uma auditoria completa de contraste.
Controle sem Skill: 84.3, interfaces completas ao lado de duas falhas que continuam visíveis
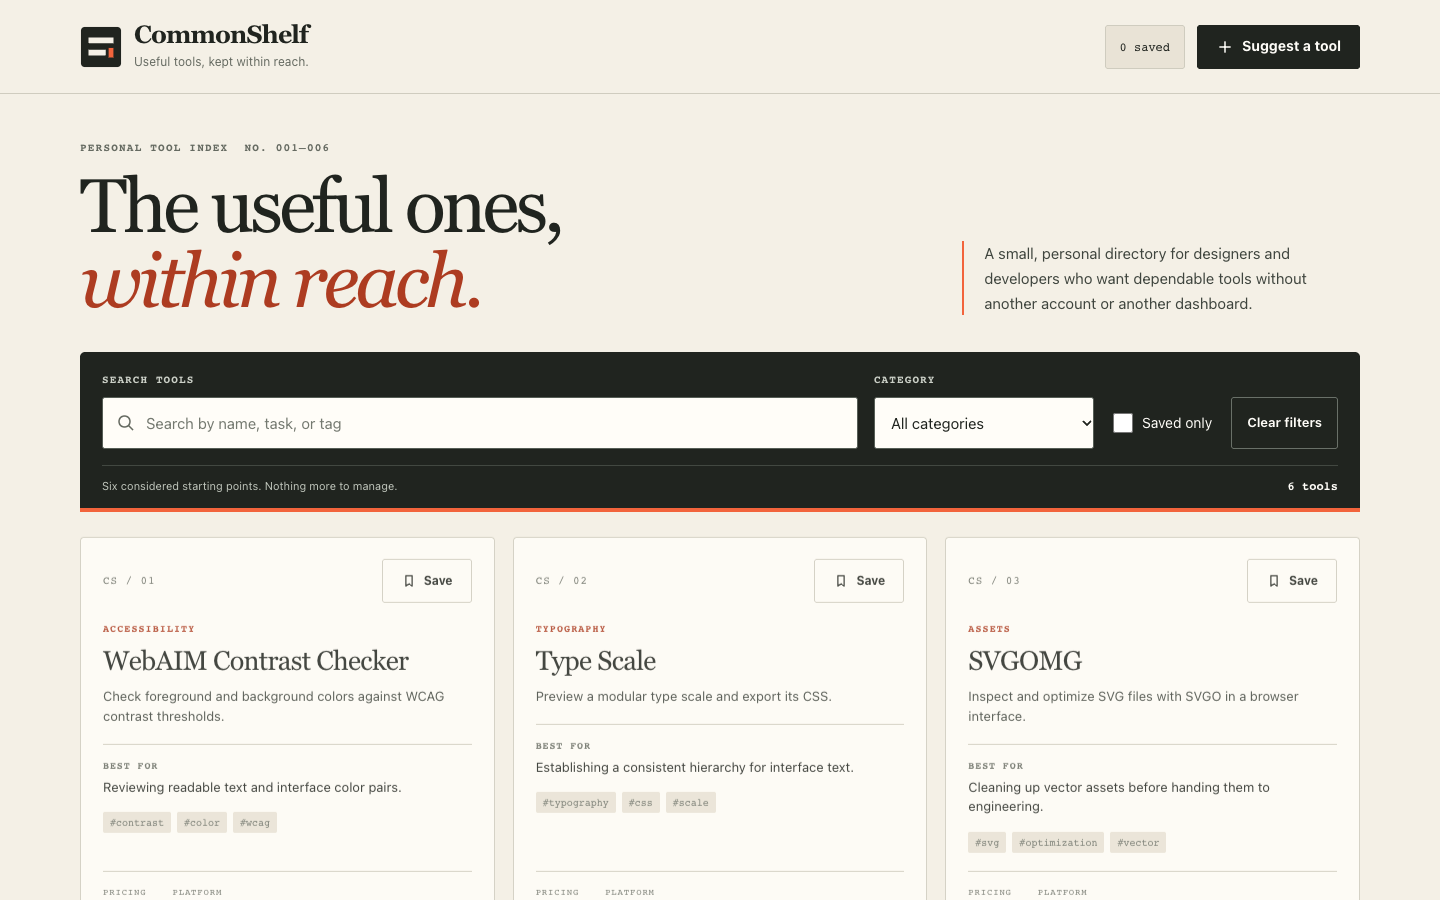
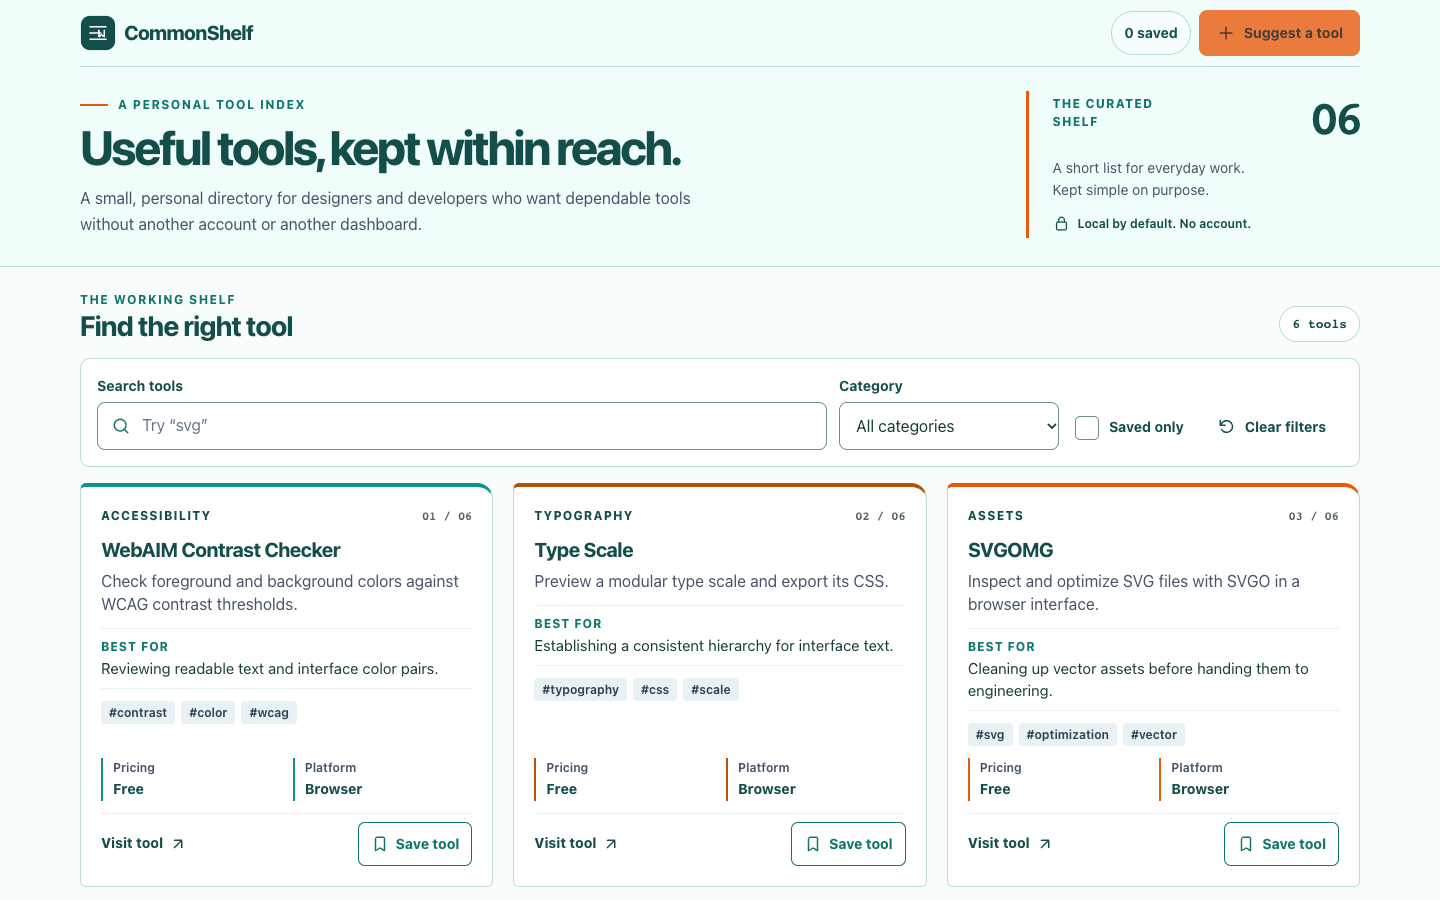
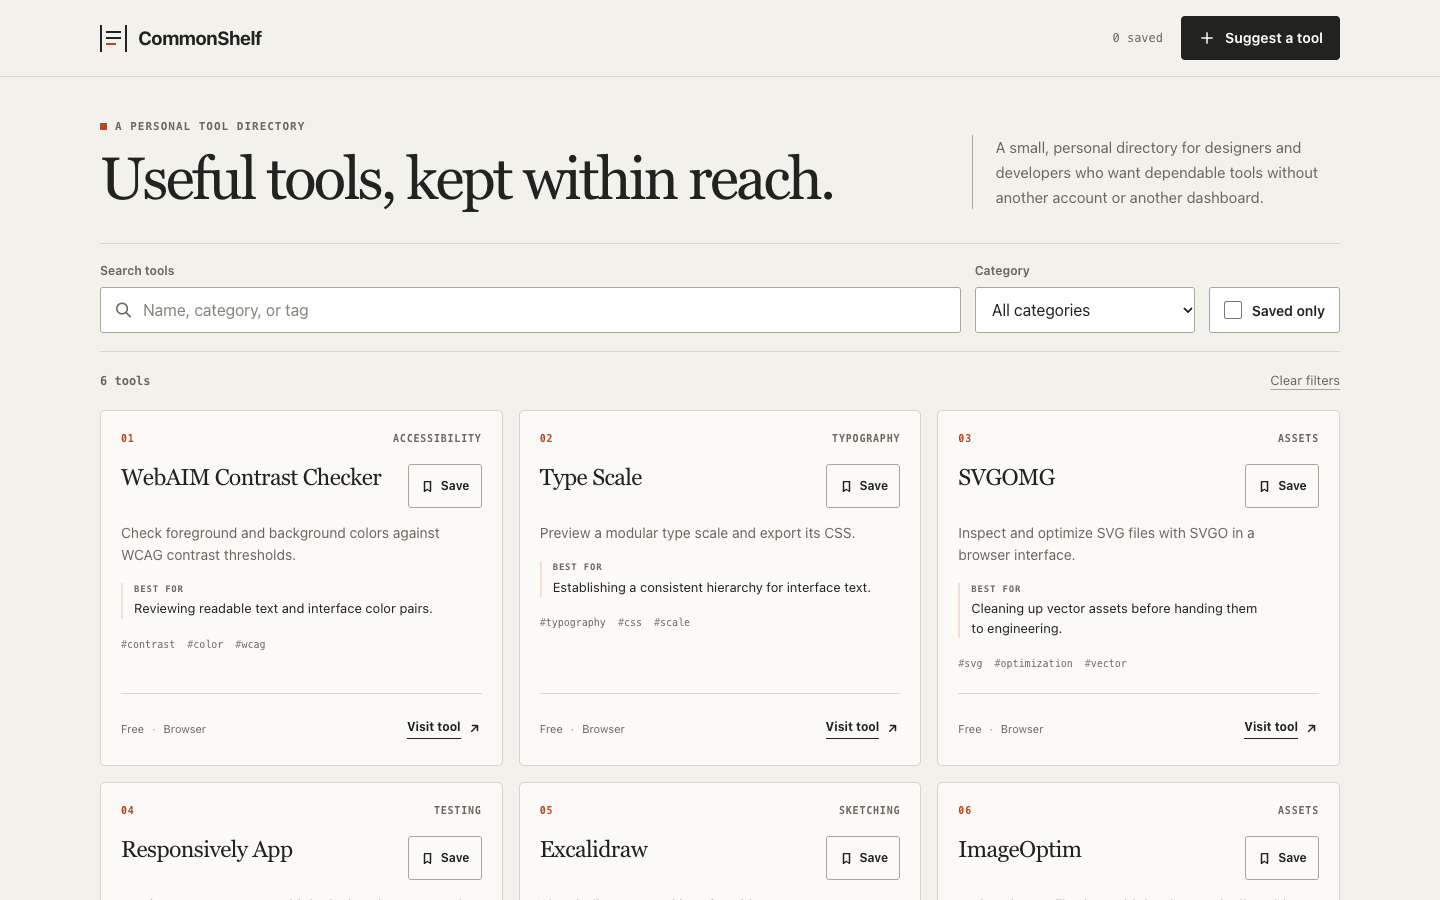
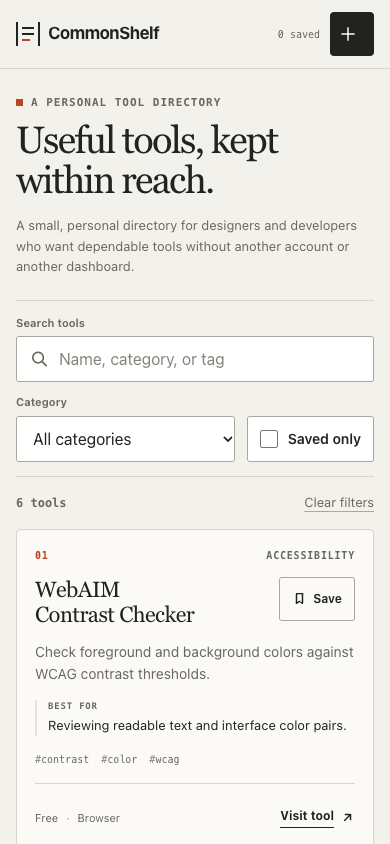
As notas visuais foram 83, 86 e 84. Papel quente, numeração e linhas de índice formaram diretórios de ferramentas coerentes, com layouts em três colunas no desktop e coluna única no mobile amplamente claros; salvamento e estados vazios frequentemente usavam mais do que apenas cor. O modelo subjacente já consegue produzir interfaces completas sem uma Skill, portanto avaliações precisam de comparações concretas em vez de presumir nota zero.
O run-1 e o run-3 falharam na asserção exata de texto do Toast em interaction-and-persistence: o contrato esperava “Suggestion saved.” enquanto o texto real adicionava um sinal de visto e espaço em branco. No run-3, esse visto estava com aria-hidden no HTML, de modo que o resultado não estabelece que sugestões ou persistência estivessem totalmente quebradas. Sob o contrato fixo, ambas as execuções permanecem reprovadas em 5/6, e passos após a asserção com falha não podem ser contados como aceitos.
Texto auxiliar era repetidamente pequeno ou apagado demais. No run-3, cálculos de cor amostrados encontraram contraste fraco para números de ferramenta e placeholders, e apenas a borda superior das ações inferiores do diálogo de erro mobile ficava inicialmente visível. No run-1, introdução e filtros ocupavam a maior parte da primeira tela mobile.
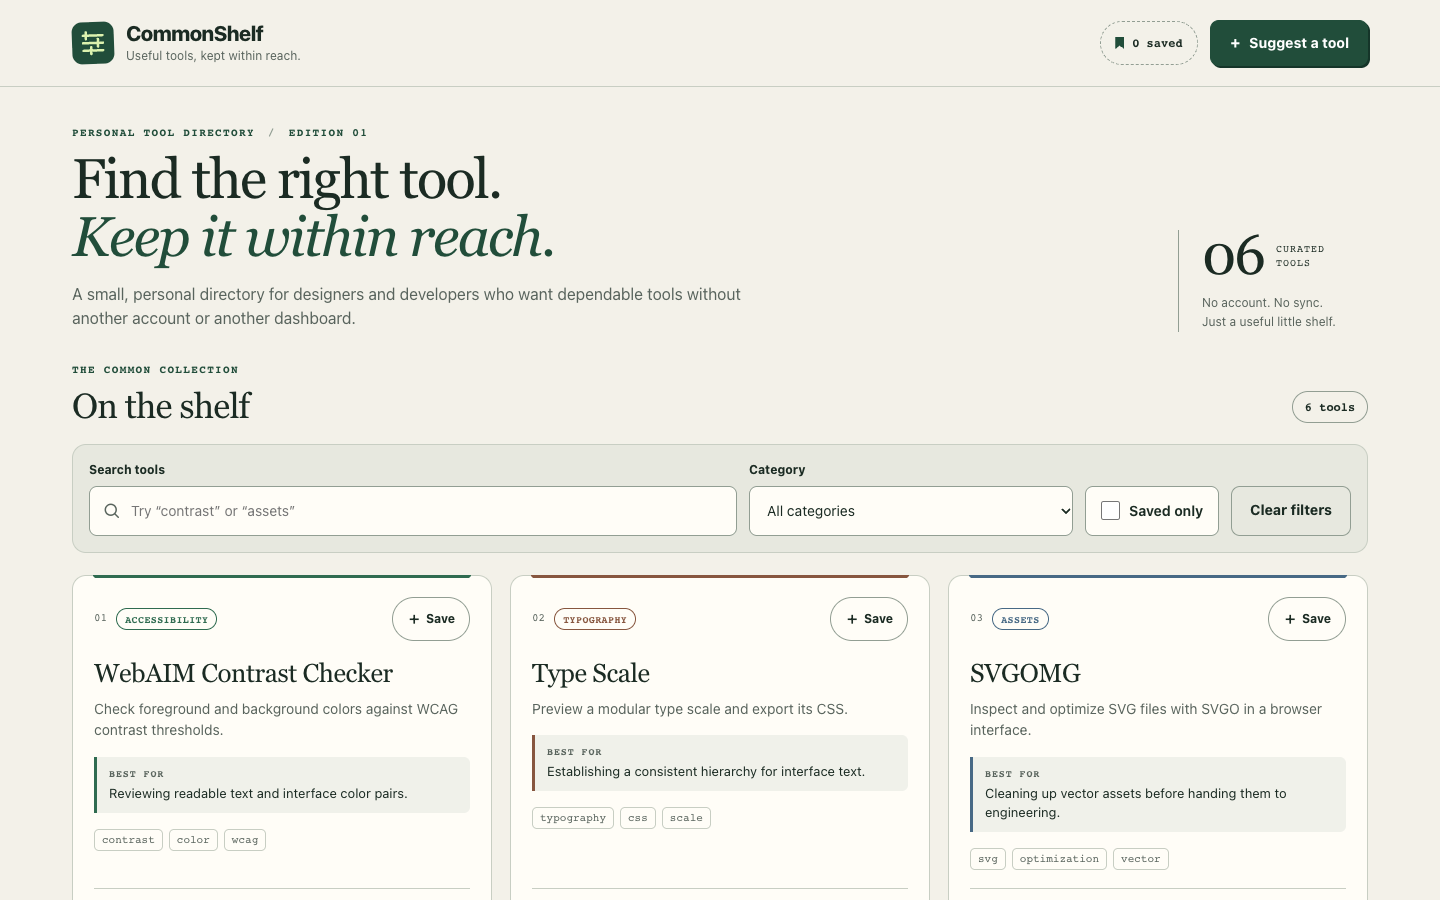
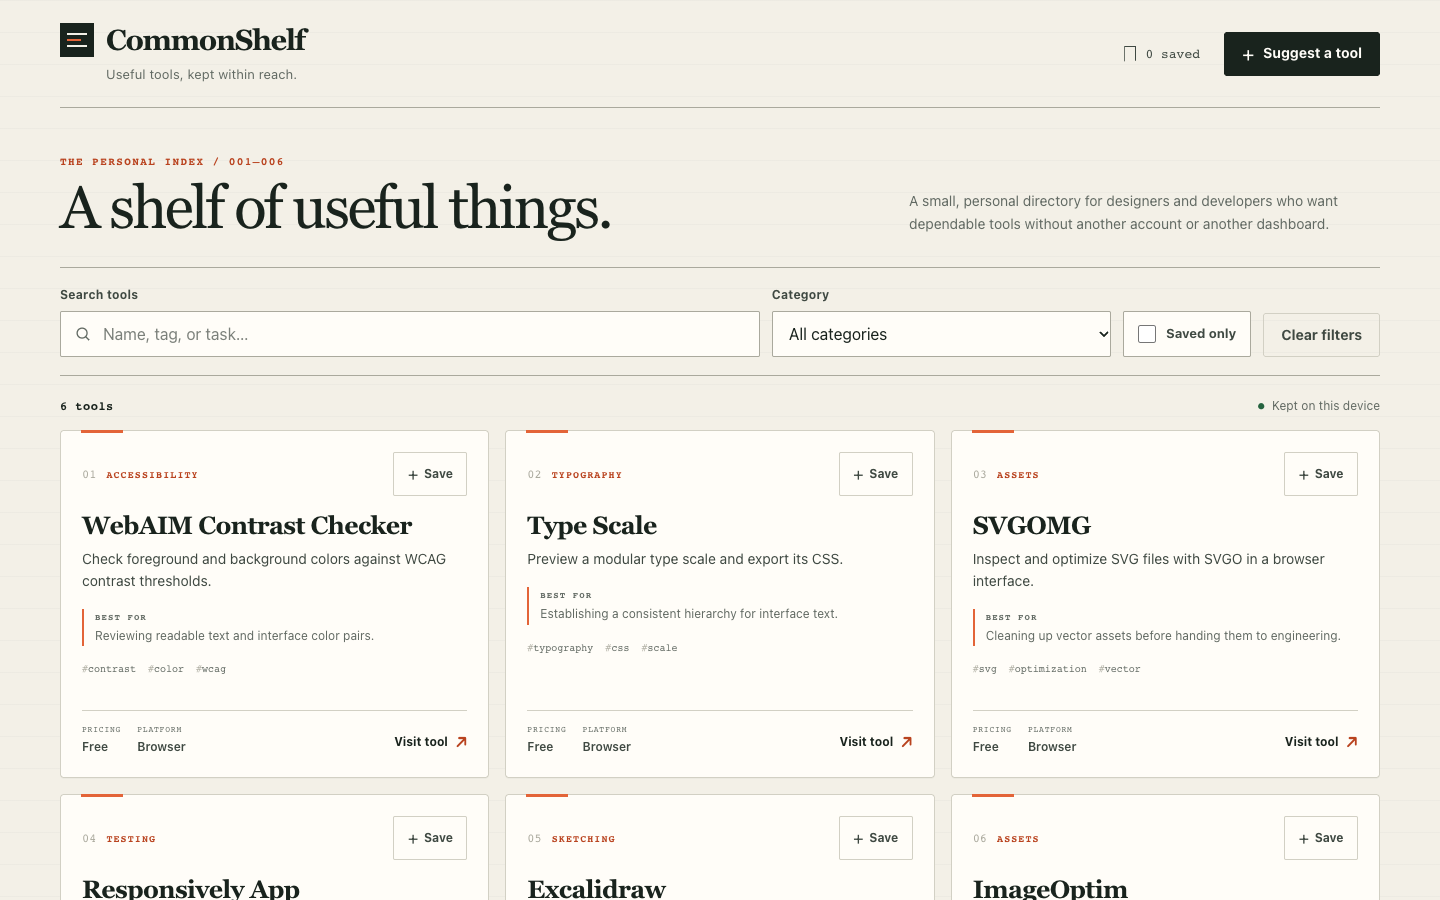
Tarefa e versões: um único brief CommonShelf
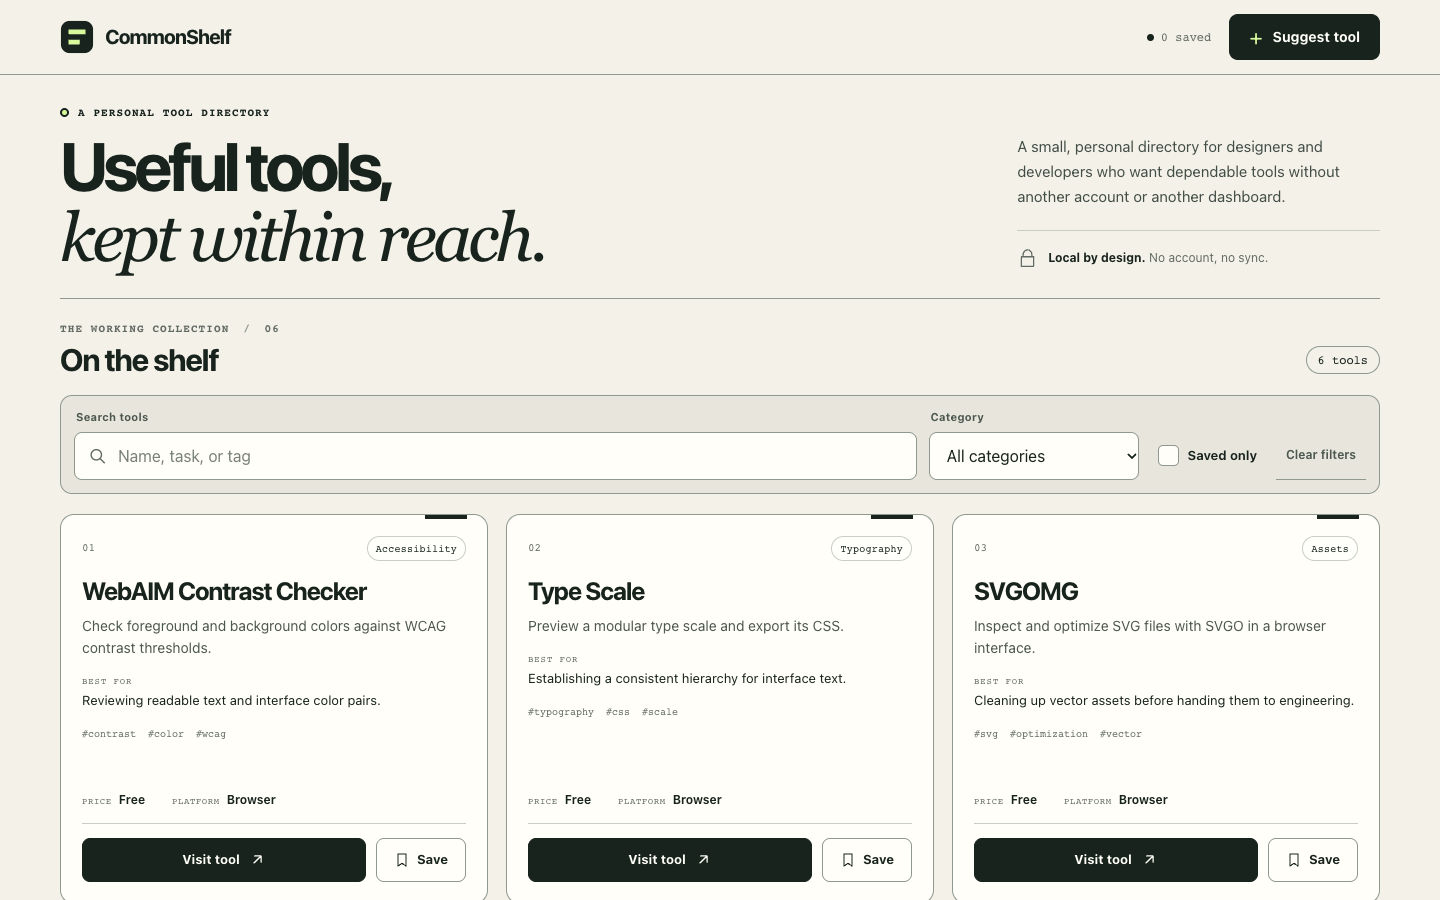
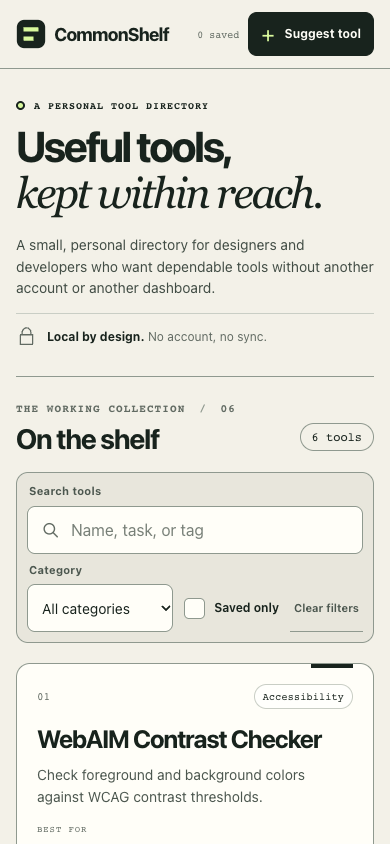
CommonShelf é um diretório pessoal de ferramentas sem fluxo de conta. O brief fornece seis registros fixos de ferramentas e exige implementações em HTML, CSS e JavaScript puros para busca, filtros de categoria e estado salvo, salvamento de ferramentas, um formulário de sugestão validado e um FAQ operável por teclado. Exceto por um link oficial ativado pela pessoa usuária, a página não faz requisições externas em tempo de execução. Cada agente entrega uma única direção em vez de gerar várias e escolher uma.
Cada condição com Skill lê apenas seu SKILL.md designado uma única vez; o controle não lê nenhum. As versões são fixadas antes da geração, não substituídas por edições globais ou pagas, e as licenças são listadas com as fontes.
| Condição | Versão fixada | Licença |
|---|---|---|
| Oil UI código aberto | 0.24.2 (tag v0.24.2) | MIT |
| frontend-design | commit-dbd4588f9e1033efb41dad4bef2f7947c8993d44 | Apache-2.0 |
| UI UX Pro Max | 2.15.0 (tag v2.15.0) | MIT |
| Impeccable | 4.7.0 (tag skill-v4.7.0) | Apache-2.0 |
| Controle sem Skill | Sem Skill ou versão upstream | Nenhuma licença upstream fornecida |
Método: 15 gerações independentes, mantendo separadas as evidências funcionais e visuais
Cada geração usou um agente novo no Kimi AgentSwarm com kimi-1021-preview e esforço de raciocínio no máximo. As condições podiam rodar em paralelo, mas run-1, run-2 e run-3 dentro de cada condição rodaram em sequência. Cada execução começou em um workspace novo, não podia ler páginas, capturas ou conversas de outra execução e não substituiu saídas mais fracas. Agendamento e recuperação afetam o tempo decorrido, portanto o tempo não foi comparado.
Após a geração, um executor independente em Playwright 1.64.1 verificou seis grupos de cenários no Chromium: linha de base desktop, linha de base mobile, interação e persistência, conteúdo indisponível, armazenamento indisponível e movimento reduzido, em 1440×900 e 390×844. A aceitação não alimentou correções de volta ao artefato gerado, e notas visuais não foram tratadas como aprovações funcionais.
A revisão visual usou 15 pacotes anonimizados com identidades das condições e registros do processo de geração retidos, enquanto arquivos de execução, capturas e status de aceitação permaneceram disponíveis. Cada pacote recebeu uma revisão. Seis notas de dimensão foram somadas para cada execução e depois calculadas as médias entre as três execuções; as dimensões somam 100, sem ponderação extra nem escolha de execução de nota maior para representar as outras.
| Dimensão | Máximo |
|---|---|
| Hierarquia visual e legibilidade | 20 |
| Adequação ao produto e originalidade | 20 |
| Comportamento responsivo | 15 |
| Interação e feedback de estado | 20 |
| Acessibilidade | 15 |
| Detalhe e movimento | 10 |
Limitações: o que esta evidência estabelece e o que não estabelece
O teste cobre um brief estático de CommonShelf em inglês, um modelo e três amostras finais por condição. A rubrica de seis dimensões ainda envolve julgamento: uma revisão corresponde a um pacote anonimizado, não a pesquisa de usuários em larga escala ou experimento de significância estatística. Outra tarefa, idioma de conteúdo, framework ou modelo poderia alterar o resultado.
A aceitação funcional cobriu seis grupos de cenários predefinidos no Chromium, não uma auditoria completa de produto. Layouts comuns de tablet tiveram evidência em folha de estilos, mas nenhuma captura dedicada. Safari, Firefox, dispositivos táteis reais, leitores de tela, zoom de 200% e checagens completas de WCAG não foram concluídos. Capturas estáticas não conseguem descrever a temporização contínua de animação: os quadros transparentes do run-3 do Oil UI estabelecem um problema de feedback, mas não a qualidade do quadro assentado após a animação.
As demos públicas preservam as páginas reais pós-geração e as falhas funcionais. Interrupções técnicas e recuperação ligada a protocolo não foram contadas como falhas funcionais candidatas nem usadas para comparar tempo decorrido; elas são distintas da aceitação independente pós-geração.
Reproduzir: inspecione as evidências e execute sua própria comparação
Use as 15 demos, 20 imagens iniciais e o results.json acima para conferir este artigo. Para uma reexecução comparável, mantenha o mesmo brief, versões fixadas e modelo; inicie um agente novo a cada vez; mantenha todas as três saídas; e execute aceitação independente após a geração. O arquivo público de conteúdo é idêntico byte a byte à cópia servida com a demo. O prompt abaixo é um brief condensado para reexecução, não o arquivo original congelado da tarefa.
O comando de instalação de código aberto instala a versão que resolver no momento da execução, não necessariamente a 0.24.2. Para uma comparação estrita, registre a versão instalada e use os commits fixados na tabela. Trate uma versão mais nova como um novo teste em vez de sobrescrever estes números.
Instale o Oil UI de código aberto e registre a versão
Teste a Skill de código aberto na sua própria tarefa primeiro. O Oil UI Pro não foi usado neste comparativo.
npx skills add oil-oil/oil-uiExecute três gerações independentes por condição
Mantenha o modelo e os dados de conteúdo fixos. Comece cada execução com um agente e workspace novos, entregue uma direção e nunca importe ou conserte a página de outra execução nem substitua saídas mais fracas.
Separe aceitação funcional da revisão visual anônima
Verifique os seis grupos de cenários em 1440×900 e 390×844 e retenha toda aprovação ou falha. Oculte identidades das condições na revisão visual, aplique as mesmas seis dimensões e publique todo resultado, não apenas as médias.
Build one complete CommonShelf static web app with plain HTML, CSS and JavaScript. Use the supplied content.json unchanged. Make one coherent direction without asking for a selection. At 1440×900 and 390×844, the first viewport must help a visitor find, understand and save tools. Implement combined search, category and saved-only filters; local-storage saves; a validated suggestion dialog; exactly three keyboard-operable FAQ items; actionable content-unavailable and storage-unavailable states; visible focus; and reduced motion. Keep suggestions outside the curated tool grid. Make no external requests except user-activated official links. Do not import another run or replace a weak result. Preserve every failure, then independently verify the actual page and review anonymized screenshots and runtime files.Este é um brief condensado para uma reexecução comparável. A reprodução estrita também exige as versões fixadas acima, os seis grupos de cenários de aceitação e a mesma rubrica de pontuação.
Exemplos funcionais e prompts da galeria
Explorar coleção →
Comece com código aberto gratuito; migre para o Oil UI Pro para apps em produção e renovação de legado
Este comparativo testou apenas a linha de base gratuita de código aberto em modo de geração única. Quando você precisar de seleção de direção lado a lado, renovação segura em 3 camadas de bases de código existentes, 10 templates complexos de workspace e até 3 rodadas de revisão às cegas visando qualidade 9/10, migre para o Oil UI Pro ($19.99 pagamento único, atualizações vitalícias).
Explorar o Oil UI Pro →npx github:oil-oil/oil-cli install oil-ui-proPerguntas frequentes
Esta comparação pode decidir qual Skill eu devo instalar?
Não decida apenas pelas médias. Compare hierarquia de catálogo, ações mobile, movimento, falhas funcionais e licenças-fonte, depois abra as demos que correspondem às suas prioridades.
Por que o run-3 do Oil UI teve nota visual 83 se todo cenário funcional passou?
A aceitação confirma que os comportamentos especificados funcionam; a revisão visual também examina o feedback. Toda reconstrução de cards nessa execução repetia uma animação a partir da transparência, deixando áreas de resultado quase em branco em várias capturas de busca, salvamento e sugestão. Esse defeito visível de feedback justifica a nota 83, mas não prova perda permanente de dados.
As duas falhas sem Skill significam que salvar estava totalmente quebrado?
Não. Ambas as execuções falharam em uma asserção exata de texto do Toast porque o texto real adicionava um sinal de visto e espaço em branco. Isso não estabelece falha total de salvamento ou persistência, mas falha no contrato predeterminado, então ambas as execuções permanecem reprovadas em 5/6.
Como posso verificar os números e telas deste artigo?
Baixe o results.json para cada nota das seis dimensões, total e resultado funcional, depois abra as três imagens iniciais desktop, uma imagem mobile e três demos funcionais de cada candidato. Toda imagem mobile vem do run-1; nenhuma execução de nota maior foi substituída, e nenhuma captura de formulário serve como visual principal.