
Oil UI, frontend-design, Impeccable et UI UX Pro Max : test sur 15 exécutions
Quel Skill de design UI livre vraiment des écrans exploitables dans Claude Code ou Codex ? Nous avons confié exactement le même brief produit aux quatre Skills UI open source les plus populaires — Oil UI, frontend-design d'Anthropic, UI UX Pro Max et Impeccable — plus un groupe témoin sans Skill. Comparez leurs écrans rendus et ouvrez les démos en direct côte à côte ci-dessous.
Points clés à retenir
N'importe quel Skill UI dédié bat le prompt brut
sans Skill, le modèle a obtenu une moyenne de 84,3 et échoué aux tests fonctionnels dans 2 essais sur 3 ; les quatre Skills UI ont réussi 12/12 essais fonctionnels.
Chaque Skill a une personnalité nette
frontend-design et Impeccable excellent sur la mise en style d'une page unique, UI UX Pro Max privilégie les cartes SaaS classiques, et Oil UI mise sur la comparaison multi-directions et la revue à l'aveugle sur captures (atteignant 89,5 lors d'un essai de suivi).
À retenir 3
Commencez gratuitement pour des pages isolées, passez à Pro pour les apps en production : le skill open source gratuit gère les pages autonomes ; passez à Oil UI Pro ($19.99 en achat unique) pour la rénovation de code existant, les espaces de travail complexes et la revue à l'aveugle en 3 cycles visant 9/10.
Comparaison de pages réelles
Oil UI
v0.24.20.24.2Édition open source de la galerie · comparaison multidirection + revue à l'aveugle
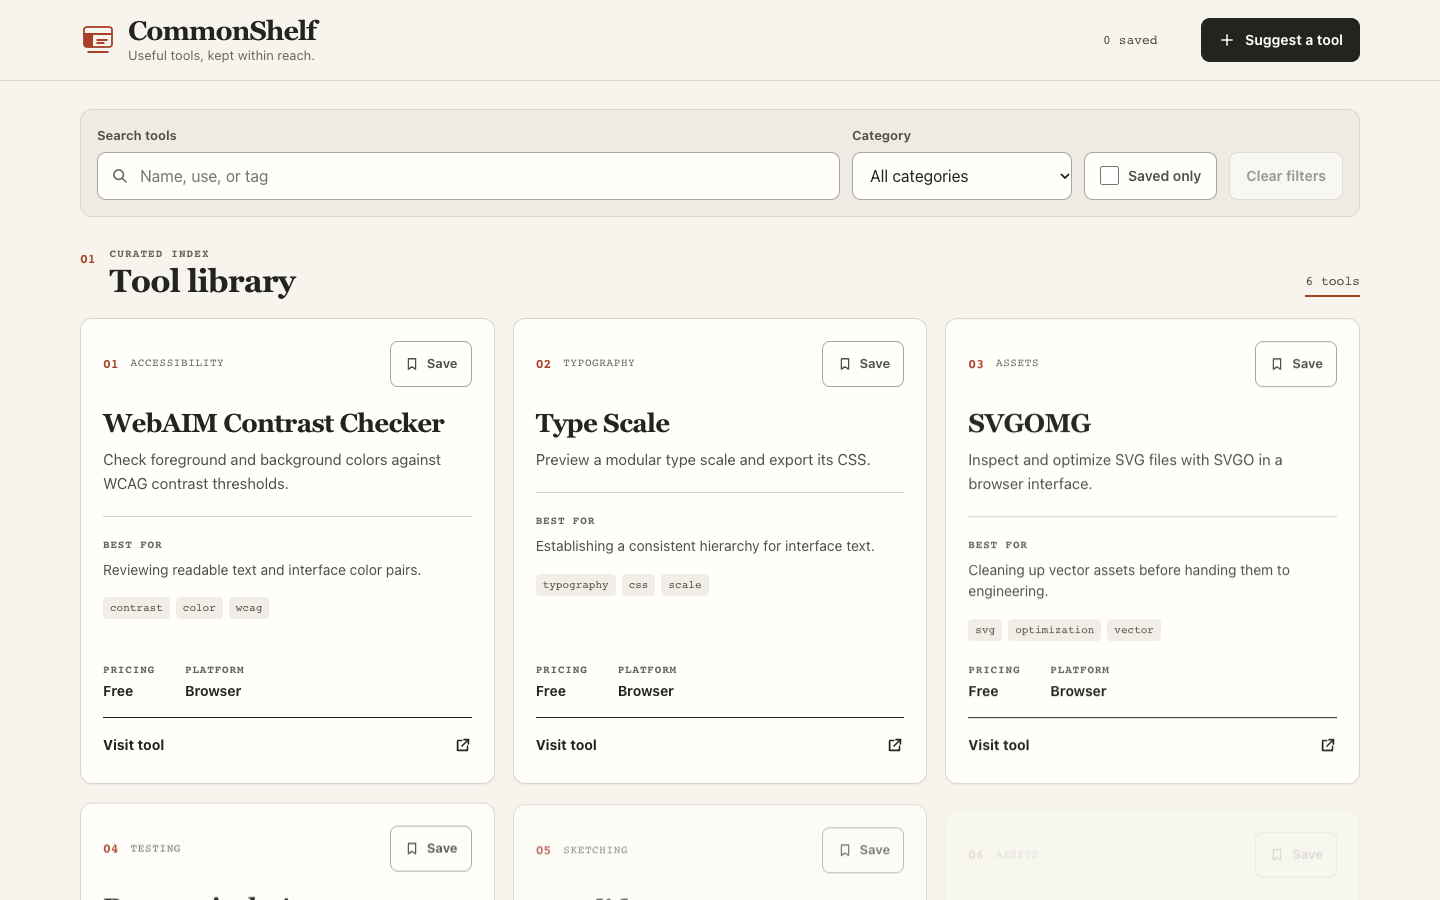
✓ Point fortInformations d'outil et retours d'état clairs
△ LimiteLa tâche sur une page n'a pas testé le volet multidirection
frontend-design
Anthropiccommit-dbd4588f9e1033efb41dad4bef2f7947c8993d44Exemple officiel d'Anthropic · guide de style pour page unique
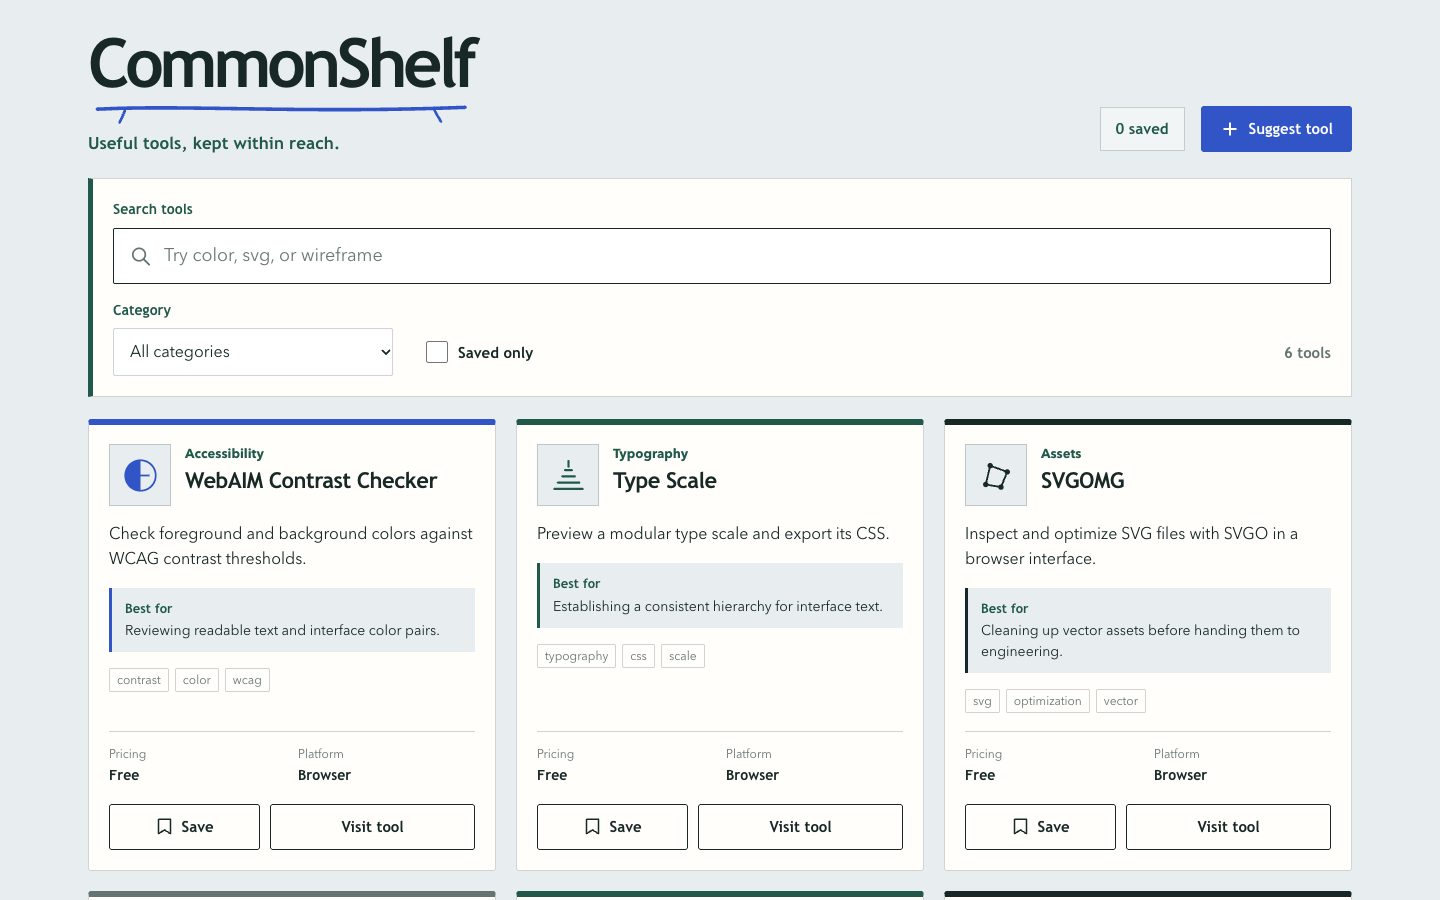
✓ Point fortDirection visuelle cohérente d'établi d'outils
△ LimiteLes bordures répétées alourdissent les cartes
UI UX Pro Max
v2.15.02.15.0Bibliothèque communautaire populaire · modèles de cartes SaaS standards
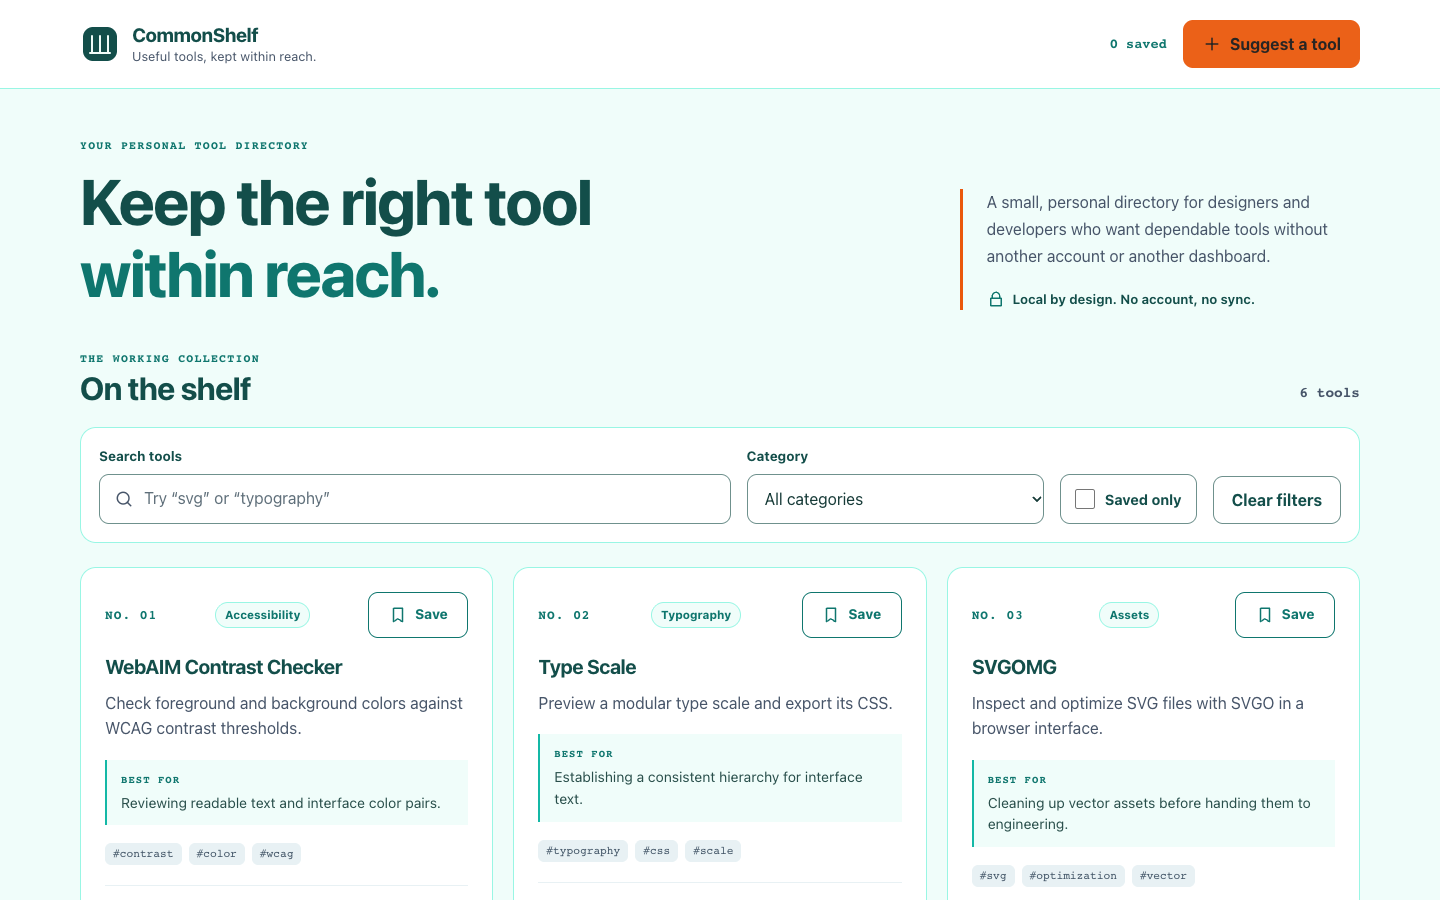
✓ Point fortCatalogue et filtres complets
△ LimiteL'en-tête mobile élevé retarde l'affichage des cartes
Impeccable
v4.7.04.7.0Prompts de finition frontend · tickets sombres et détails d'état
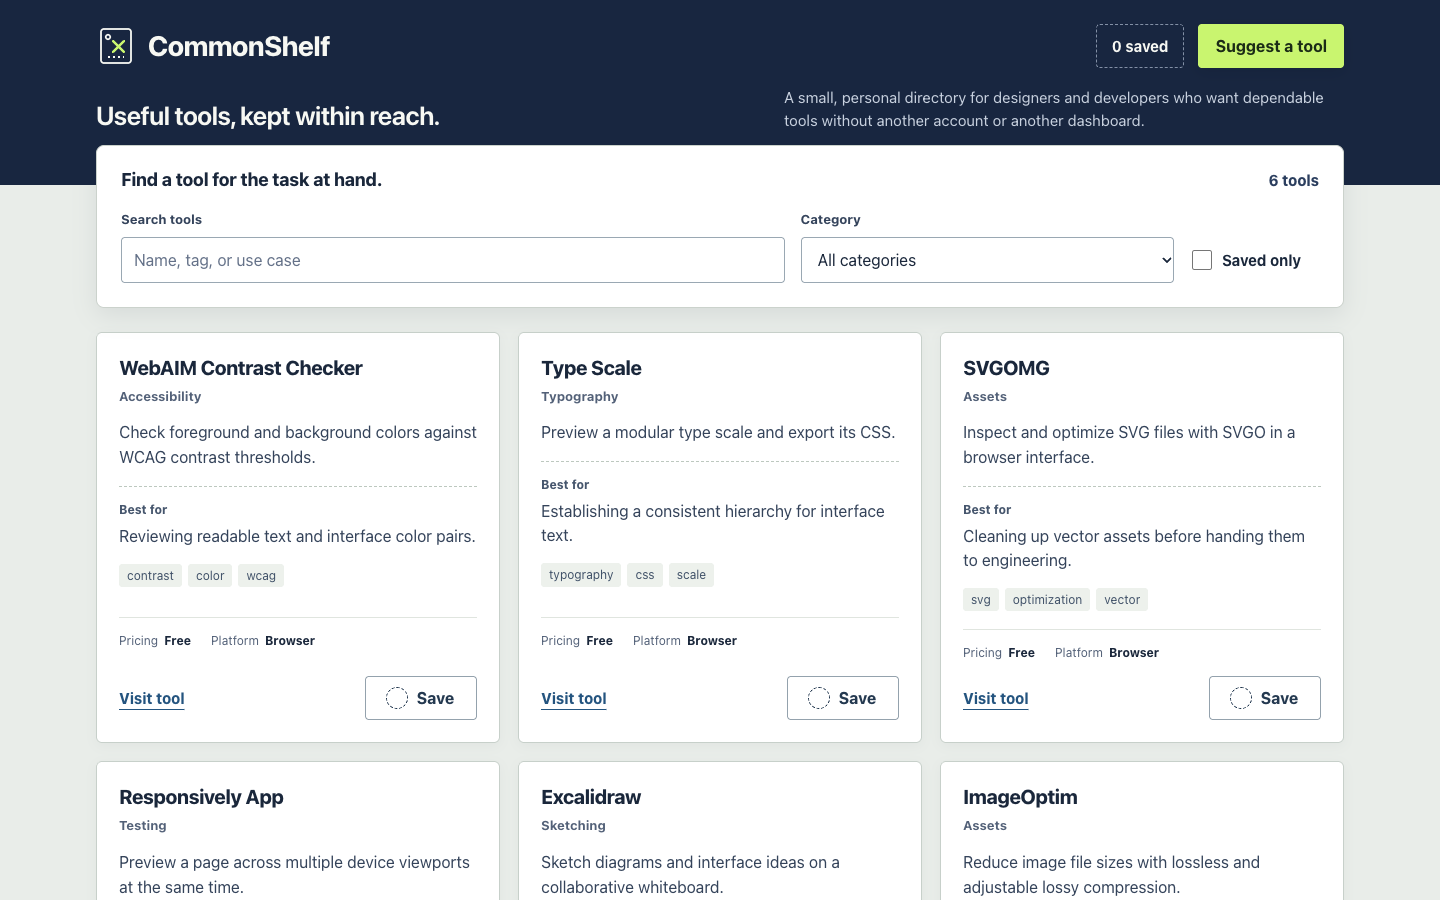
✓ Point fortTickets distinctifs et détails d'état soignés
△ LimiteL'alignement des cartes dévie légèrement
Résultats en un coup d'œil
Sans Skill
84.3 · moyenne sur 3 essaisDans 2/3 essais, le message de sauvegarde ne correspondait pas au texte attendu.
Ouvrir démo ↗Quatre Skills
86.7–88.0 · moyennes sur 3 essaisLes 12 contrôles fonctionnels ont réussi.
Candidat d'optimisation Oil UI
89.5 · moyenne à l'aveugleTrois directions, projet existant et revue itérative à l'aveugle ; essai isolé, pas une mise à jour officielle.
Lire rapport ↗Résultats : score de chaque essai et bilan fonctionnel
| Condition | run-1 | run-2 | run-3 | Somme des 3 essais | Moyenne | Fonctionnel |
|---|---|---|---|---|---|---|
| Oil UI open source | 88 · réussi | 90 · réussi | 83 · réussi | 261/300 | 87.0 | 3/3 réussis |
| frontend-design | 87 · réussi | 87 · réussi | 90 · réussi | 264/300 | 88.0 | 3/3 réussis |
| UI UX Pro Max | 86 · réussi | 88 · réussi | 86 · réussi | 260/300 | 86.7 | 3/3 réussis |
| Impeccable | 88 · réussi | 87 · réussi | 89 · réussi | 264/300 | 88.0 | 3/3 réussis |
| Témoin sans Skill | 83 · échoué | 86 · réussi | 84 · échoué | 253/300 | 84.3 | 1/3 réussi, 2 échoués |
Les 15 générations et revues visuelles anonymes ont été menées à terme ; la validation fonctionnelle a réussi sur 13 essais et échoué sur deux. Les moyennes divisent la somme des trois essais par trois et sont affichées à une décimale : ainsi UI UX Pro Max vaut 260/3 et sans Skill vaut 253/3. Le JSON public contient chaque score sur les six dimensions, le résultat fonctionnel et les URL publiques des ressources.
Comment choisir : optez pour frontend-design (88,0) ou Impeccable (88,0) pour styliser rapidement une page unique, UI UX Pro Max (86,7) pour des catalogues SaaS classiques, et Oil UI (87,0 en 0.24.2 ; 89,5 lors du test candidat de suivi) lorsque vous souhaitez des planches comparatives multi-directions, une revue à l'aveugle sur captures ou la rénovation de projets existants avec Oil UI Pro.
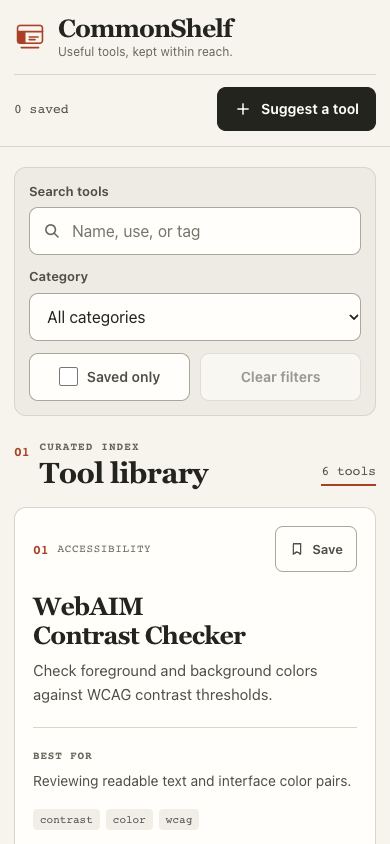
Oil UI open source 0.24.2 : 87,0, avec une perte de points sur run-3 due à une transparence répétée
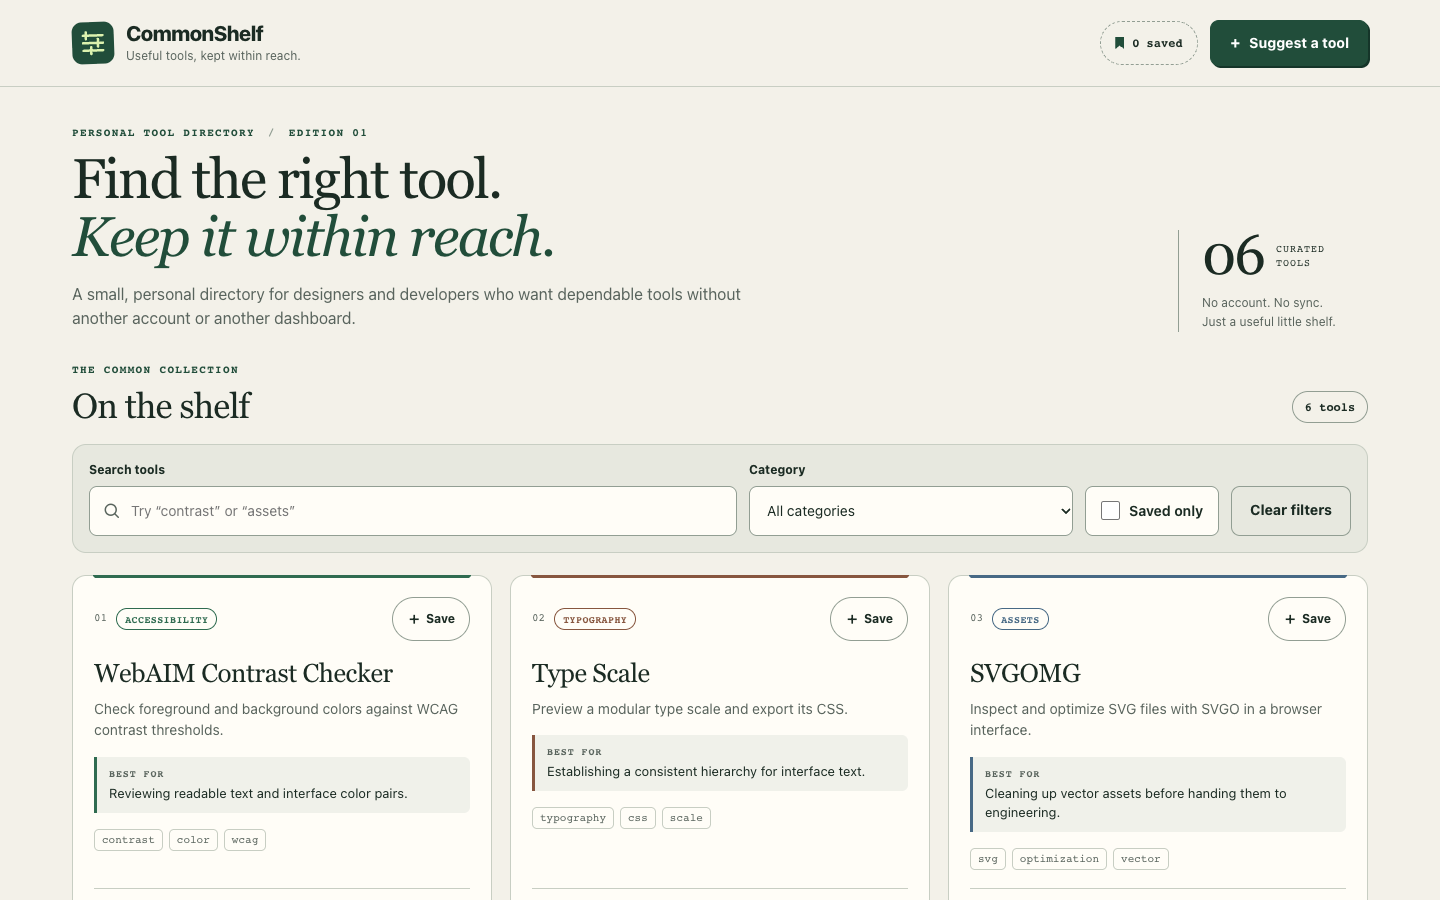
Les notes visuelles ont été de 88, 90 et 83, avec 6/6 scénarios fonctionnels réussis à chaque fois. Les trois rendus centrent la recherche, les filtres et les six outils, avec un ordre d'information stable sur les cartes. Enregistrer met à jour le texte, les icônes ou la forme, le remplissage et le compteur ; les résultats vides proposent une réinitialisation, les échecs de chargement un nouvel essai, et les erreurs de formulaire incluent un résumé et des indications de reprise par champ.
Sur run-1, le long formulaire mobile oblige à défiler pour exposer toute la rangée d'actions après l'apparition des erreurs, et plusieurs captures ont saisi les cartes suivantes presque transparentes à l'entrée. Run-2 a développé un système plus cohérent de filets d'index partagés et d'onglets enregistrés, mais son effet d'entrée de 420ms a produit des images délavées lors des captures de recherche et d'actualisation des suggestions. Un petit texte d'appoint en chasse fixe rendait aussi les pages longues plus difficiles à lire.
Sur run-3, chaque reconstruction via renderTools() rejouait une animation card-in de 180ms depuis opacity: 0. Une capture de recherche affichait « 1 tool » sans aucune carte visible, tandis que les captures mobiles de recherche, d'actualisation des favoris et de suggestions montraient des cartes quasi transparentes. Bien que l'acceptation fonctionnelle ait réussi, masquer de manière répétée le contenu principal lors du filtrage courant perturbait le retour visuel, d'où une note de 83. Ces images ne prouvent pas une perte définitive de données.
frontend-design : 88,0, un langage cohérent de tiroir d'atelier avec des accents répétés
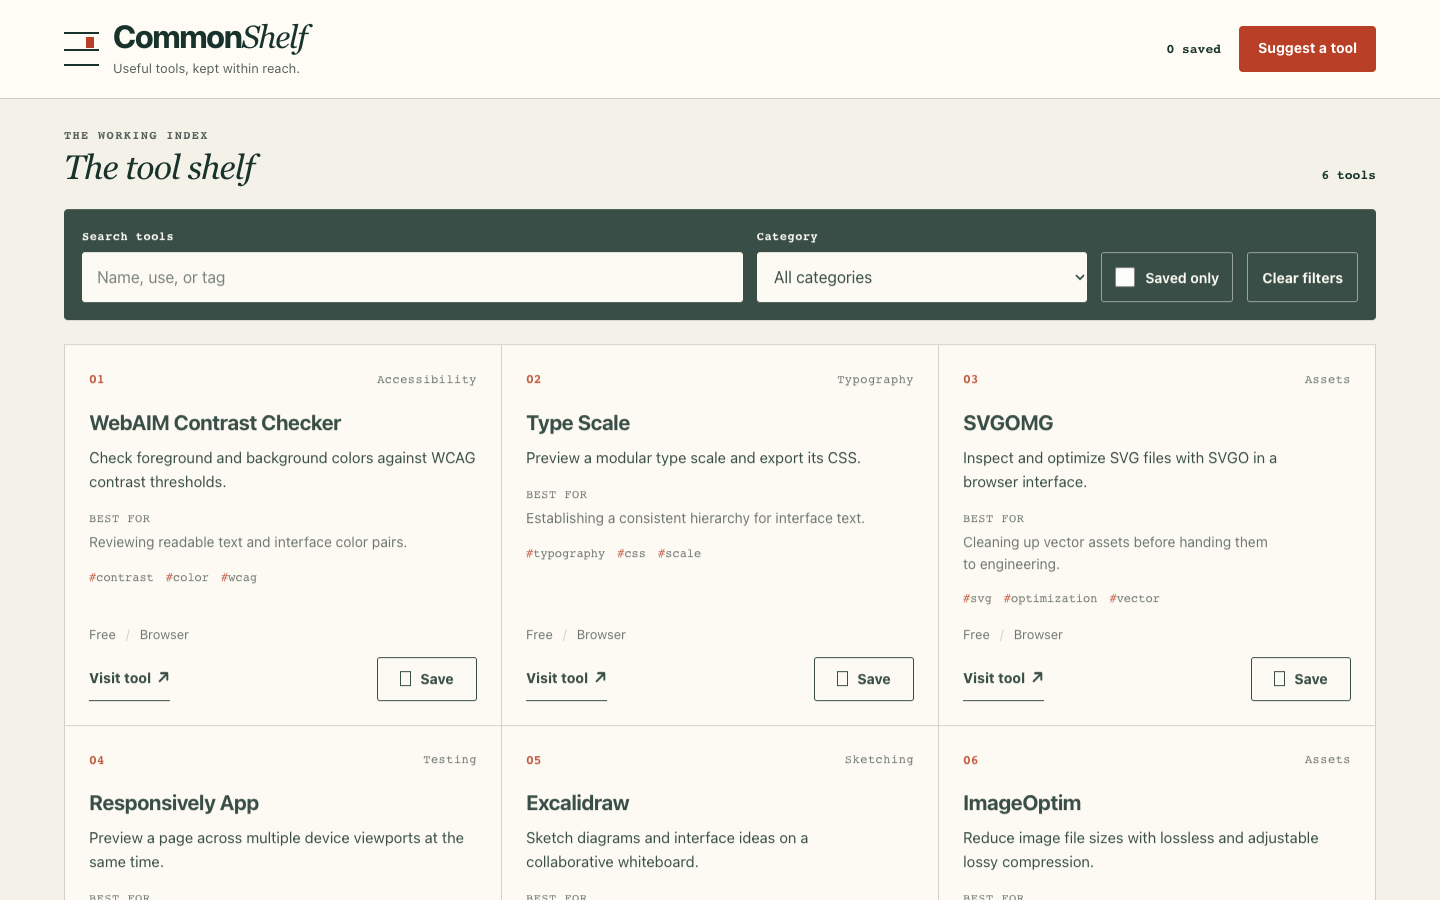
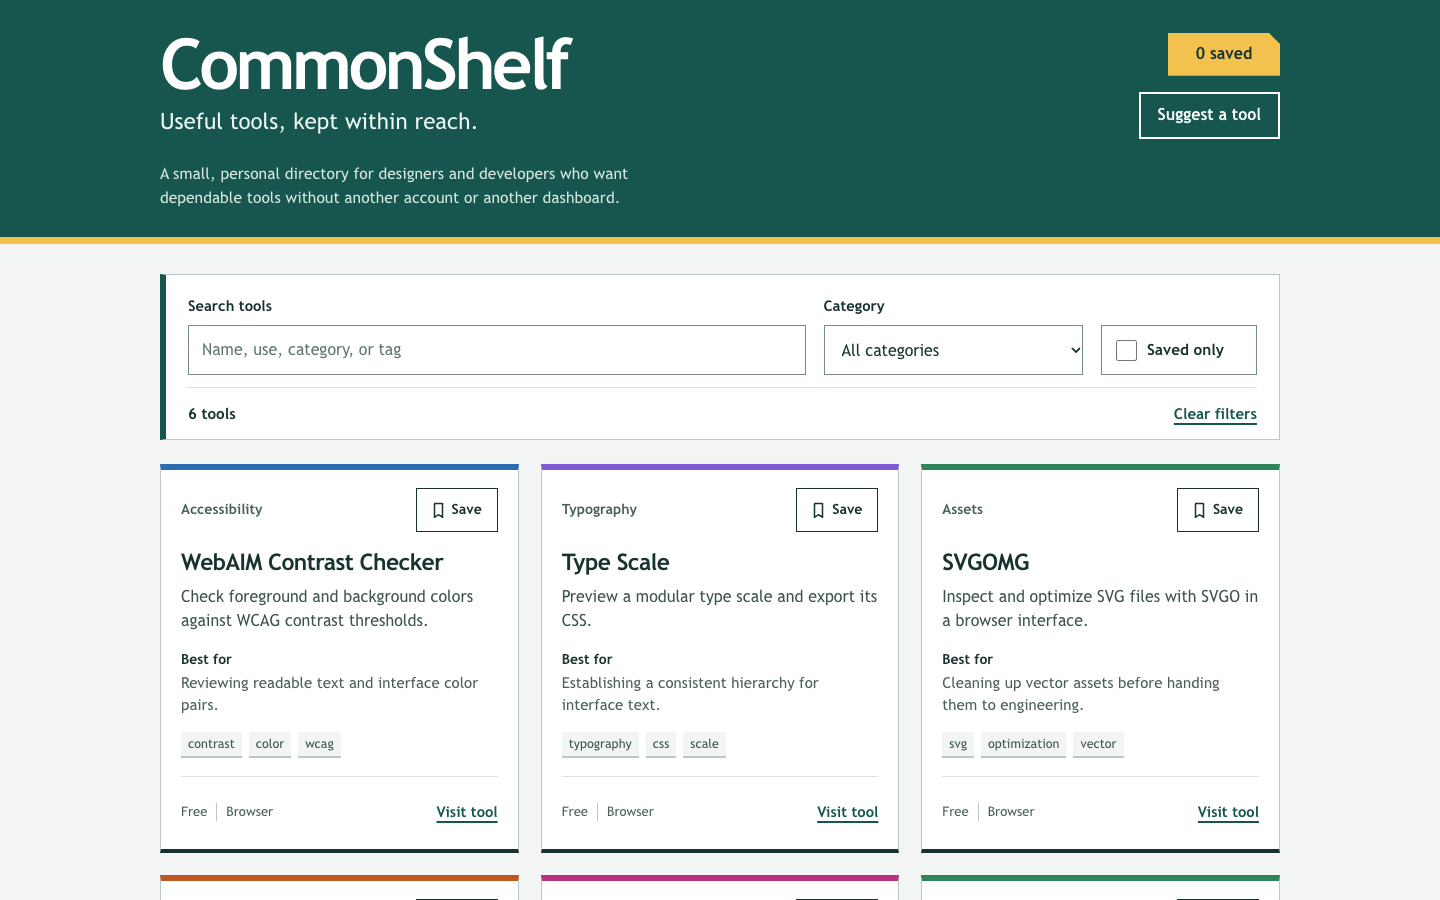
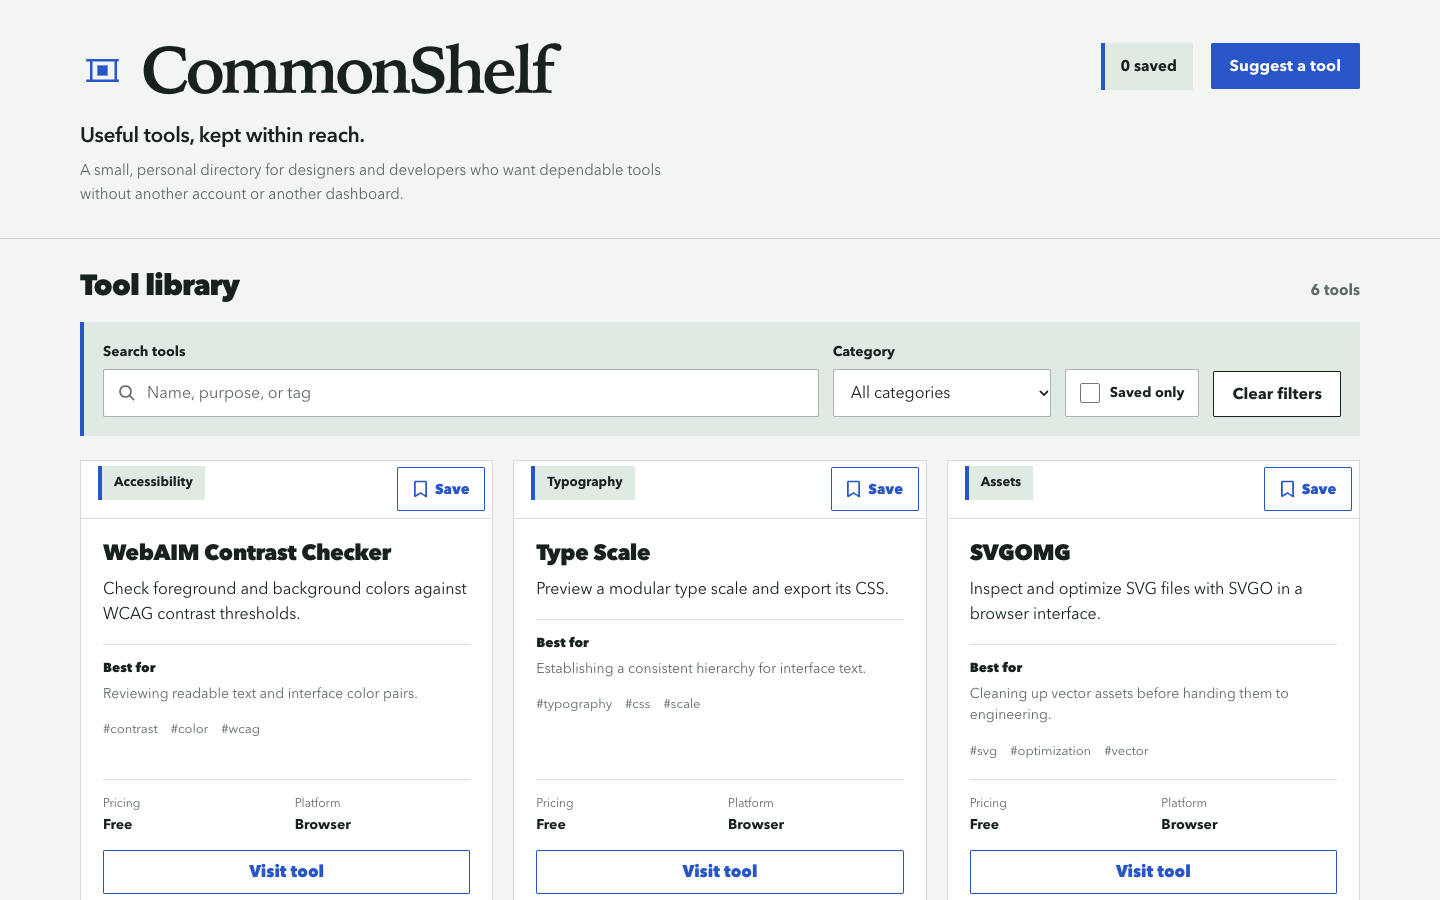
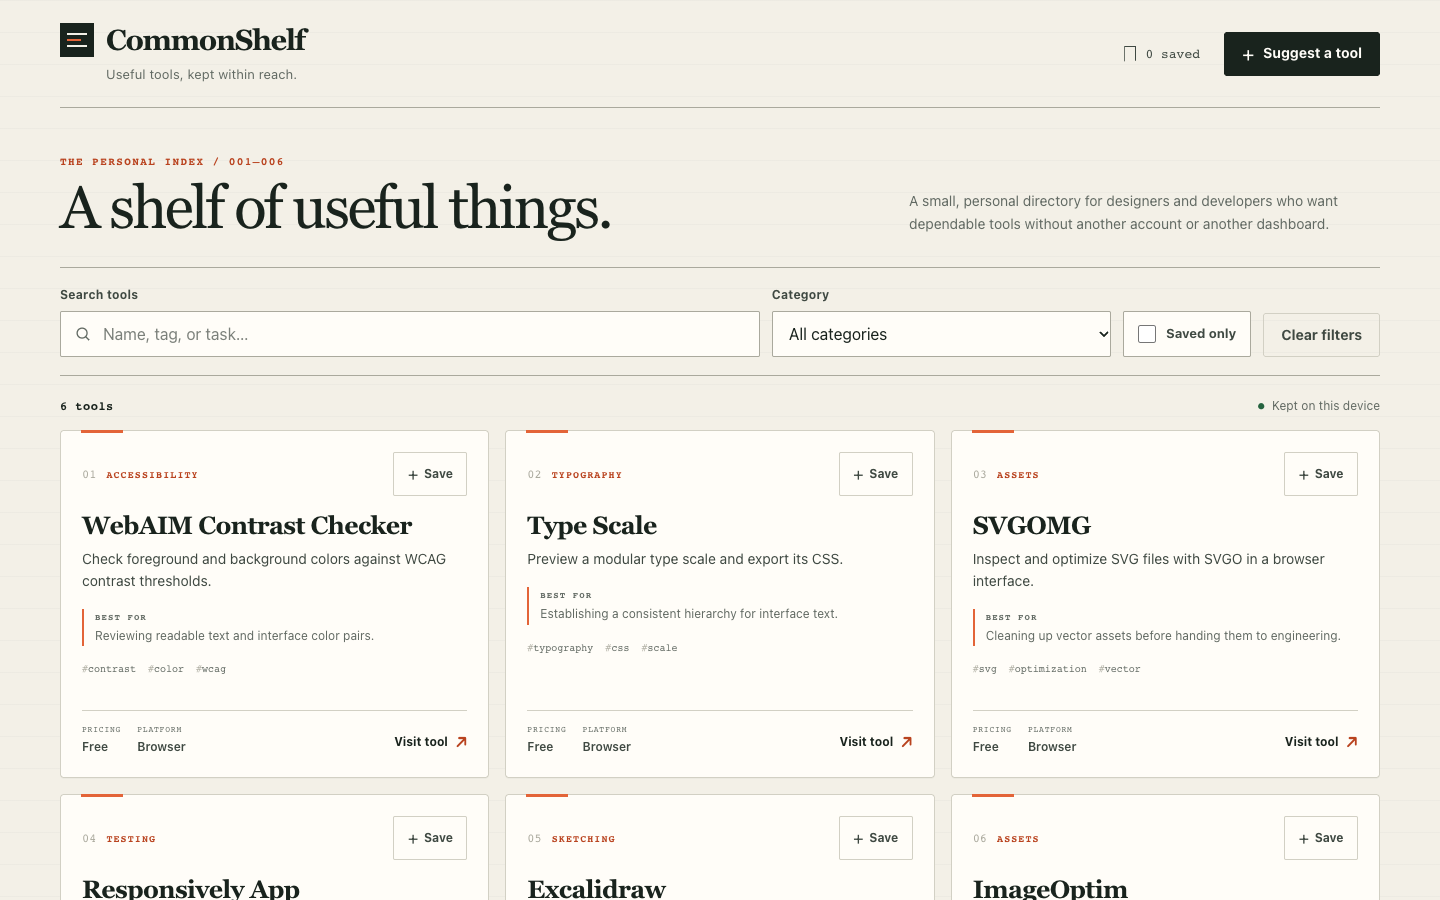
Les notes visuelles ont été de 87, 87 et 90, avec 6/6 scénarios fonctionnels réussis à chaque fois. Run-1 a construit un « tiroir d'atelier » fait de surfaces gris froid, papier d'étiquette, filets d'étagère tracés à la main, signets et symboles d'outils distincts, en gardant résumés et cas d'usage bien en vue. Enregistrer modifiait le texte, le remplissage du signet et la couleur de surface ; la première carte mobile et les actions du formulaire invalide étaient pleinement visibles.
Run-2 conservait une hiérarchie claire mais cumulait une barre supérieure de 6px sur les cartes d'outils, une ligne de base épaisse et des filets gauches autour des filtres et suggestions, alourdissant visuellement l'ensemble. Sa boîte de dialogue d'erreur mobile plaçait Annuler et Enregistrer sous le viewport initial de 844px, obligeant à défiler. Run-3 répétait également des filets gauches bleus et utilisait de petits libellés et métadonnées. Sa moyenne rejoint celle d'Impeccable, mais les écrans et points faibles diffèrent.
UI UX Pro Max 2.15.0 : 86,7, des états complets freinés par la densité mobile et le placement des actions
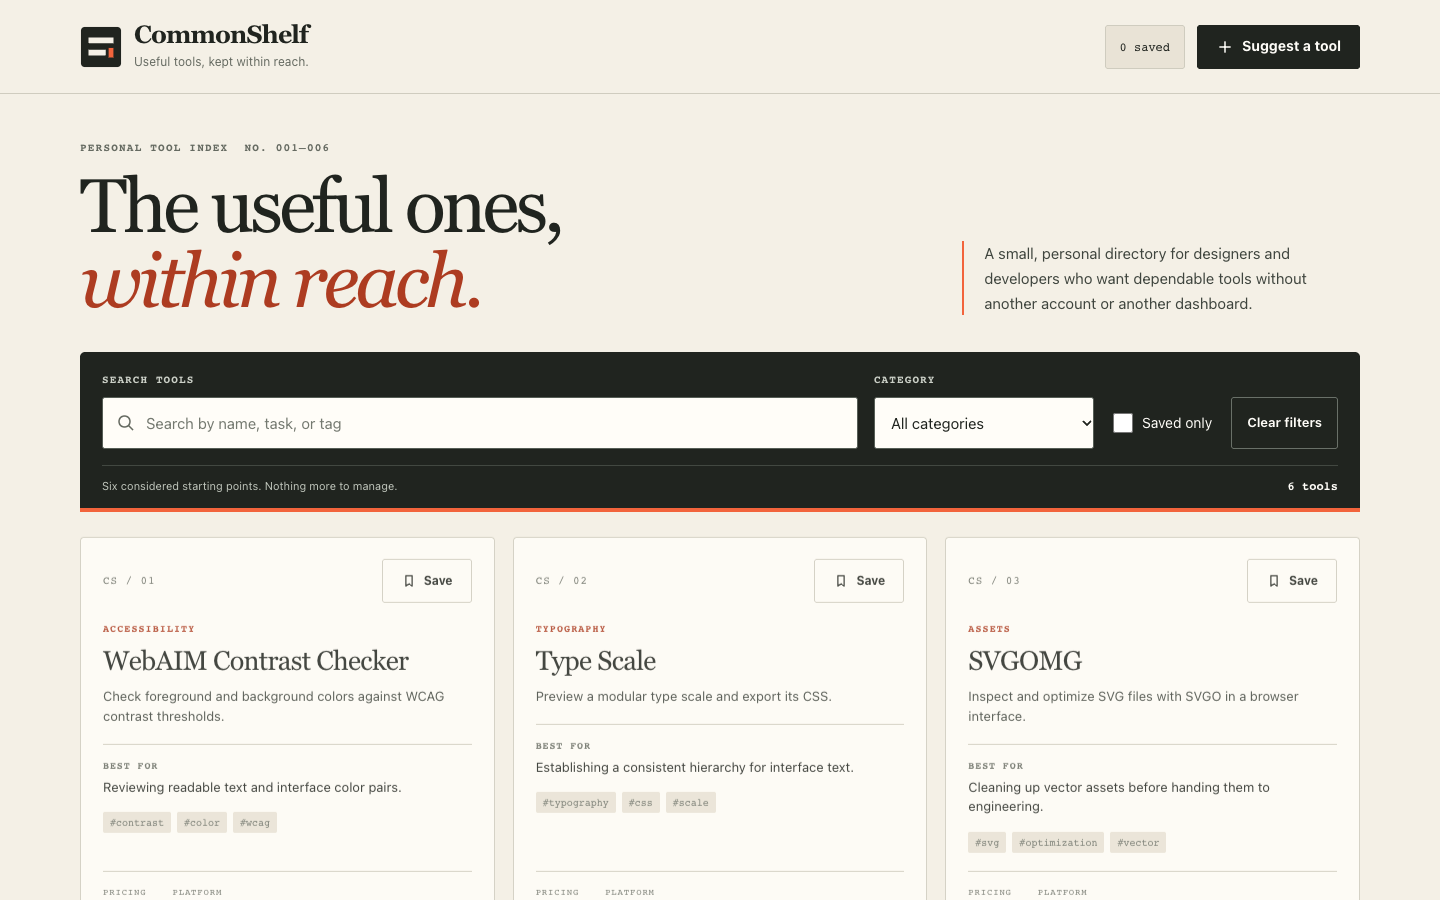
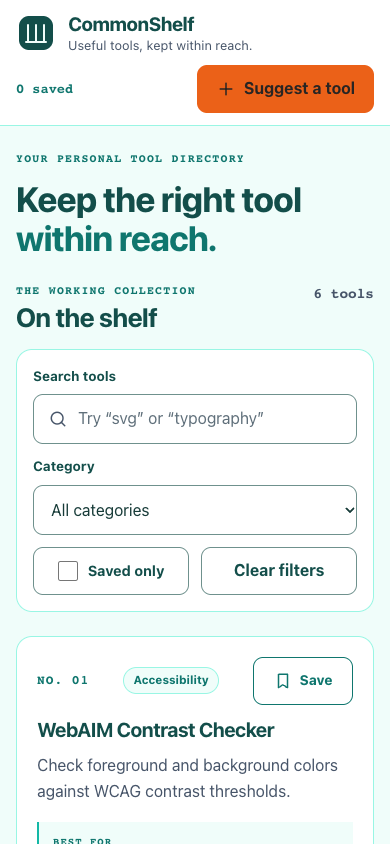
Les notes visuelles ont été de 86, 88 et 86, avec 6/6 scénarios fonctionnels réussis à chaque fois. Les trois versions organisent les six outils par nom, résumé, cas d'usage, tags, tarif et plateforme. Enregistrer met à jour le texte Save/Saved, le signet, le compteur et l'état Saved only ; échec de chargement, dégradation du stockage et erreurs de formulaire disposent tous de voies de récupération.
Run-2 répétait un accent supérieur de 4px sur les cartes d'outils et des filets gauches autour des suggestions et spécifications ; la fréquence des catégories, chiffres et tags en 12px donnait un traitement un peu systématique. Sur run-3, la première carte mobile commençait vers 712px, ne laissant que son sommet visible dans un viewport de 844px, et la page entière mesurait environ 4695px de haut. Les longs formulaires d'erreur sur bureau et mobile obligeaient à défiler pour trouver soumettre et annuler ; ils ont passé la validation, mais l'aboutissement était moins direct.
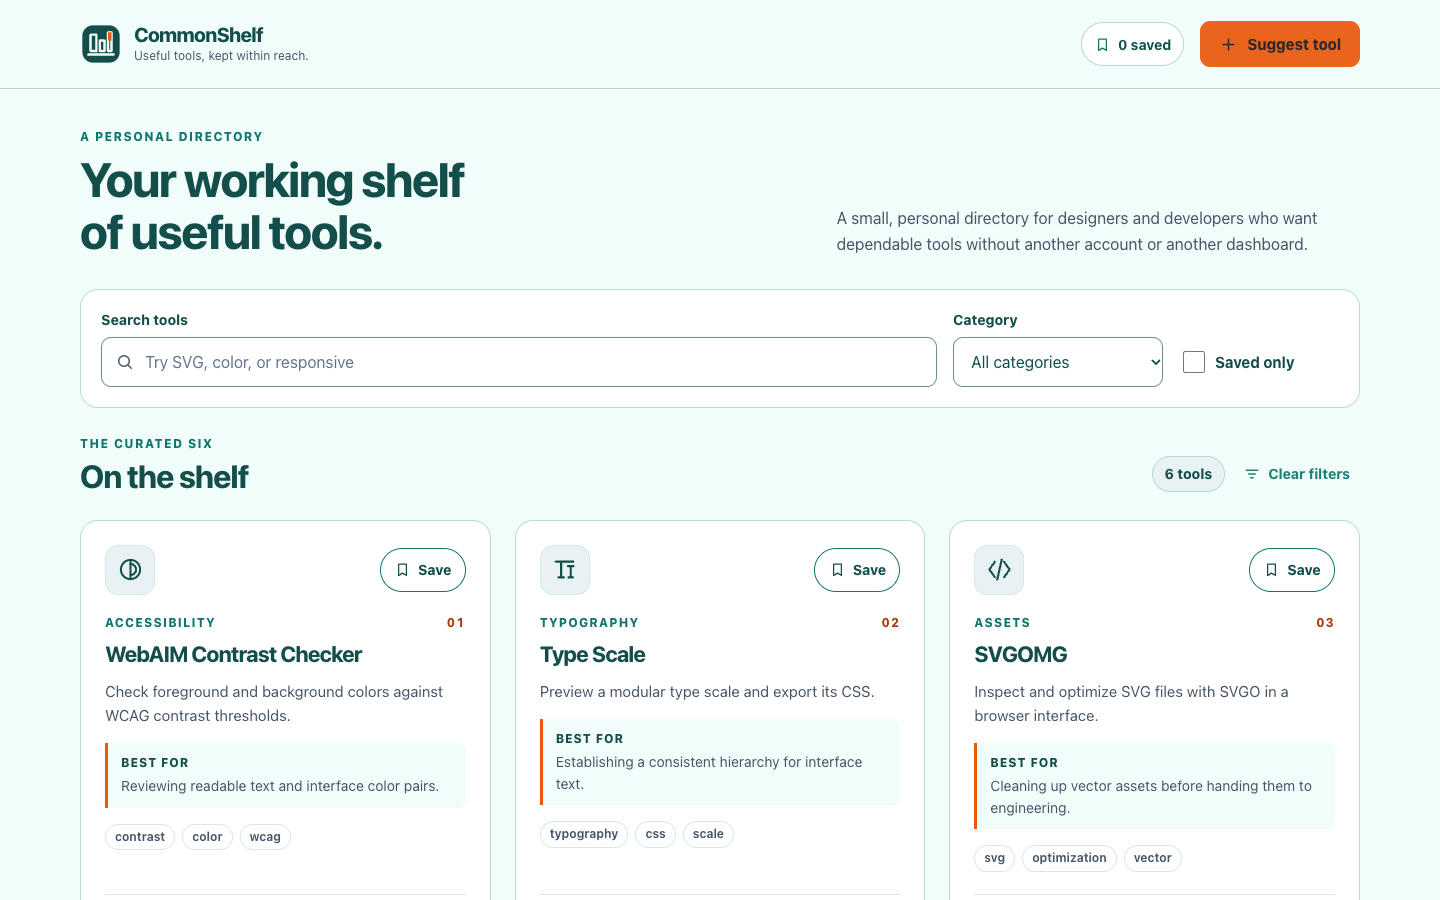
Impeccable 4.7.0 : 88,0, avec des détails de répertoire liés à l'état réel
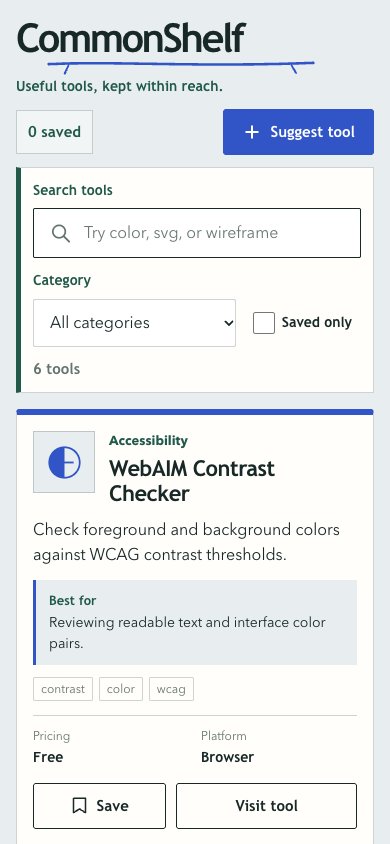
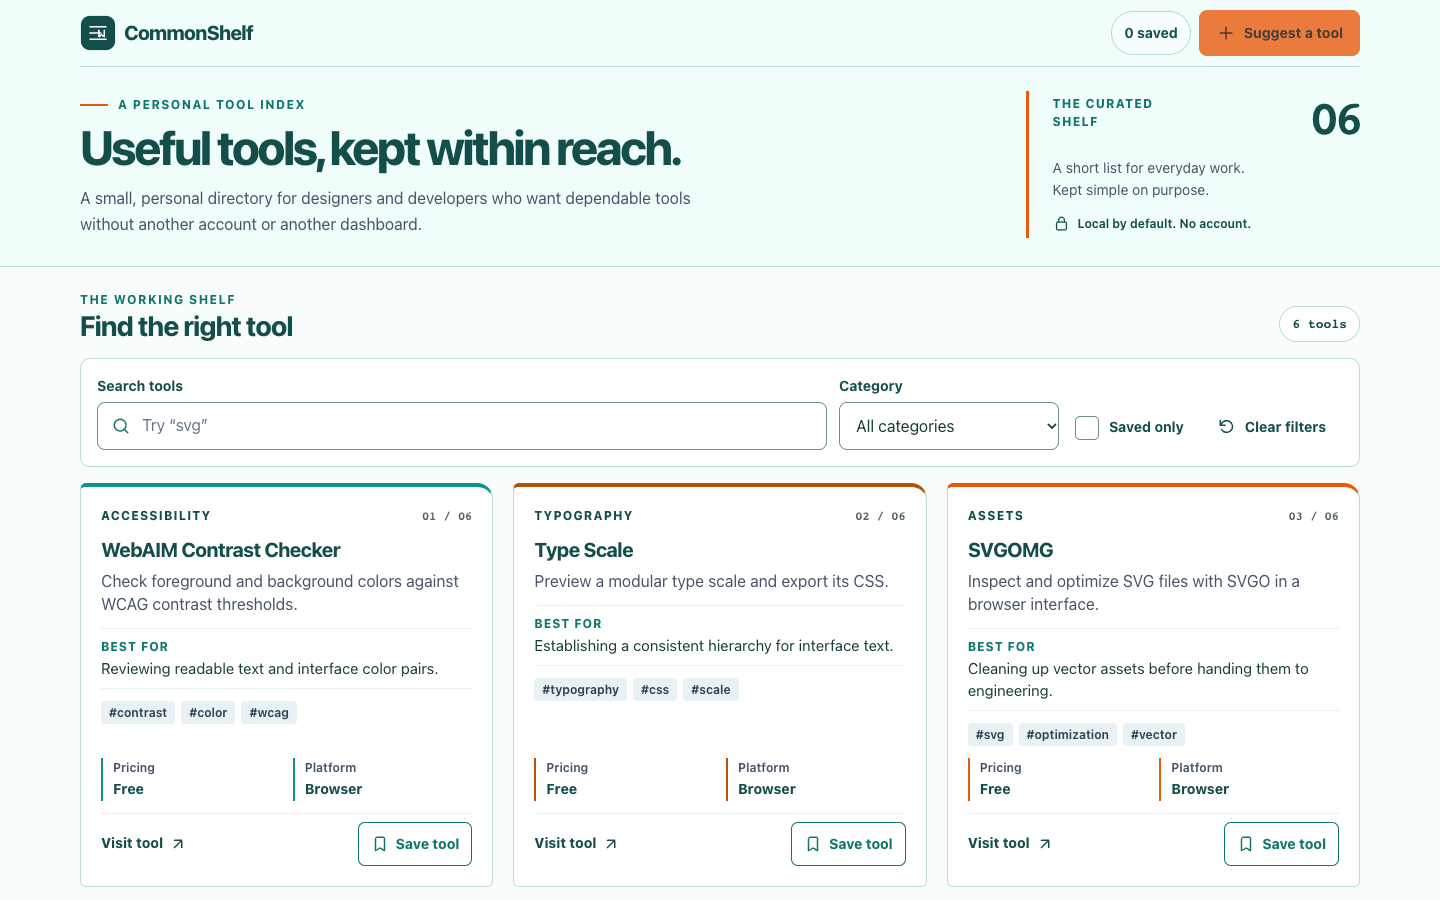
Les notes visuelles ont été de 88, 87 et 89, avec 6/6 scénarios fonctionnels réussis à chaque fois. Run-1 utilisait perforations, pointillés et marques de piqûre pour former une direction cohérente d'échantillons de tickets. Sur run-3, le registre Catalog changeait le style des filets selon la recherche, l'enregistrement et le filtrage, reliant la décoration à l'état réel. Le retour d'enregistrement associait texte, repères, remplissage ou bordures, tandis que résultats vides et échecs de chargement proposaient une action suivante.
Les points retirés portaient sur la densité et les parcours sur petit écran. Sur run-1, résumés, tags et métadonnées ne partageaient pas les mêmes lignes de base entre cartes d'une même rangée lorsque les longueurs variaient, et les métadonnées en 12px étaient faibles. Run-2 associait un en-tête haut à plusieurs niveaux de filtres, laissant moins d'actions visibles dans le premier viewport mobile et produisant une page de 3149px. Plusieurs dialogues d'erreur mobiles obligeaient aussi à défiler pour exposer annuler et enregistrer.
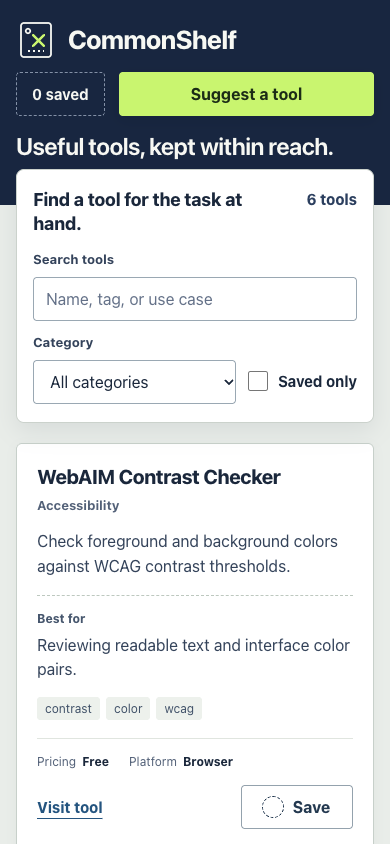
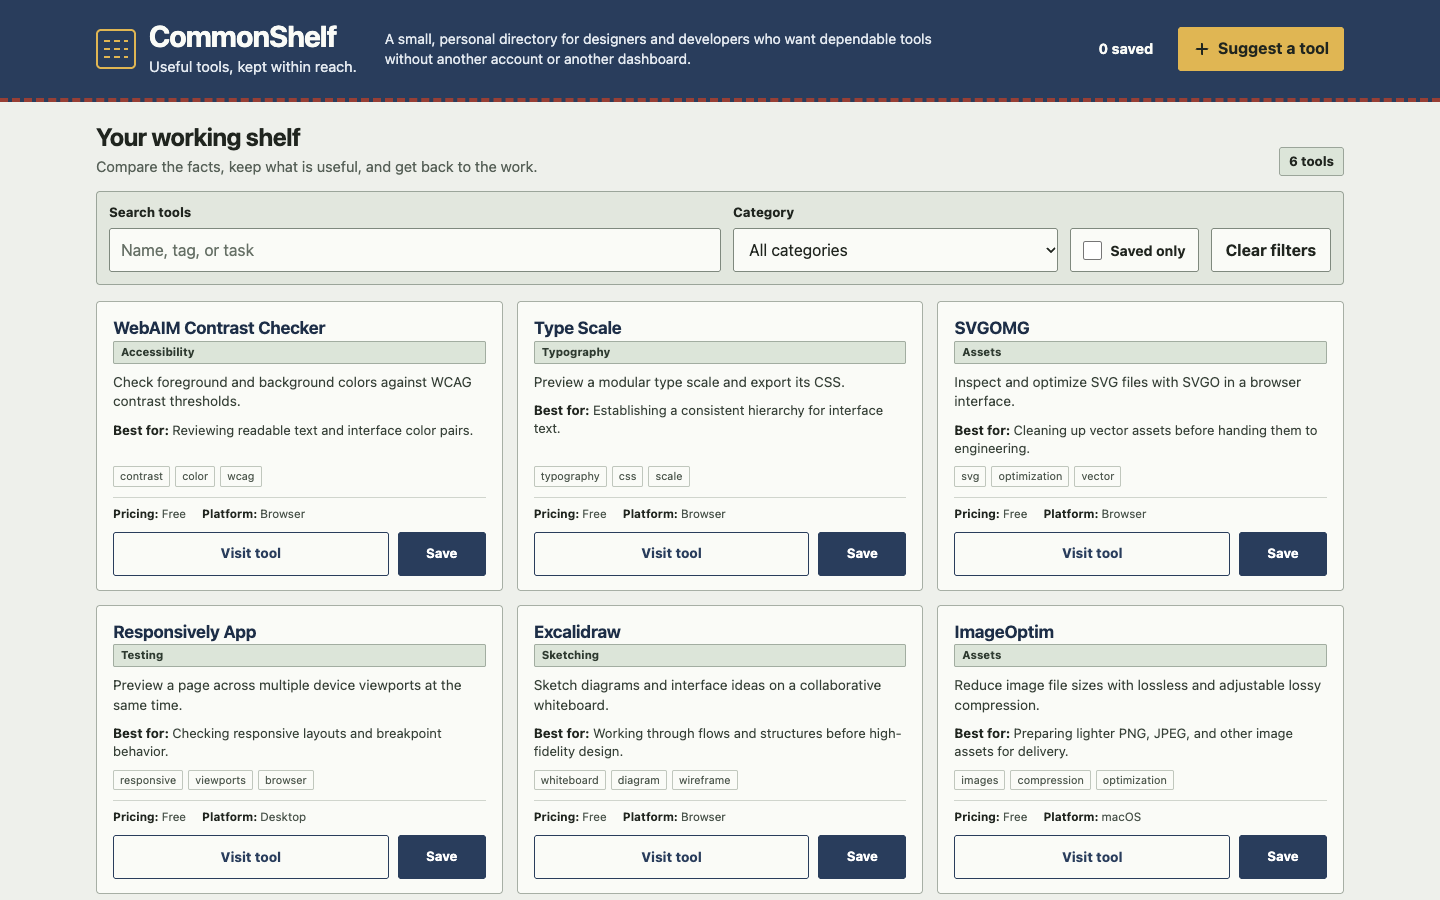
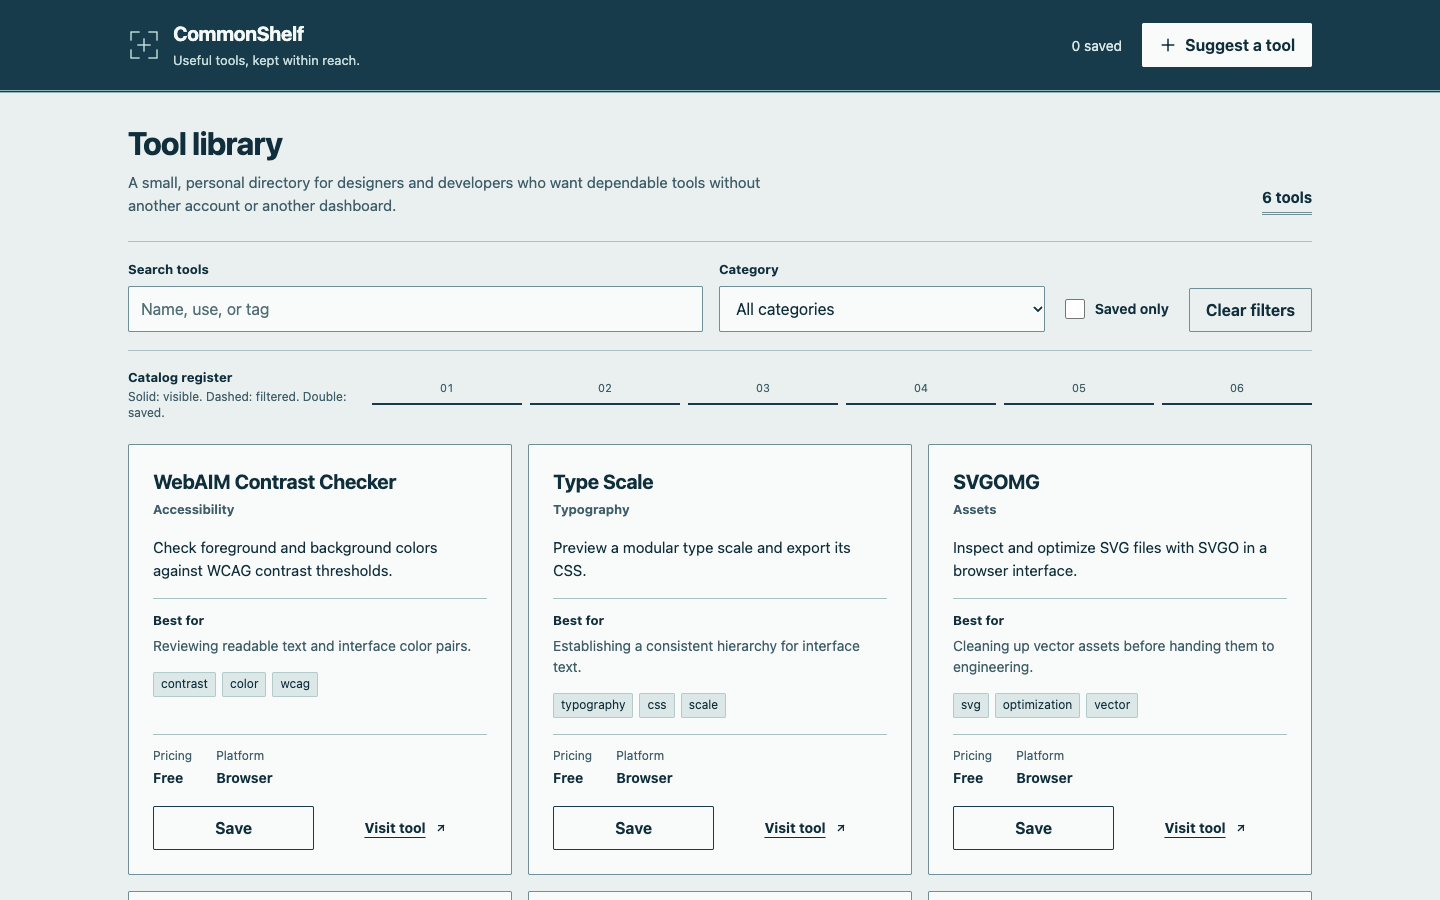
Annexe | Candidat d'optimisation Oil UI 0.24.2 : un essai de suivi
Cette annexe porte sur un essai de suivi d'un candidat d'optimisation indépendant basé sur Oil UI 0.24.2, toujours avec Kimi AgentSwarm et kimi-1021-preview. Ce candidat n'est pas une version officielle, se situe en dehors de l'échantillon initial de 15 essais et ne modifie ni ne remplace ces résultats ; un seul essai ne démontre pas une amélioration générale.
La validation fonctionnelle indépendante a réussi 6/6 scénarios, et la vérification étendue d'interaction continue a réussi 2/2 sur 11 points de contrôle. Les deux relecteurs indépendants à l'aveugle ont attribué 89 et 90, soit une moyenne de 179/2 = 89.5. Ils n'ont pas relancé Playwright, et les preuves fonctionnelles restent distinctes des notes visuelles. Les preuves directes ne couvrent que Chromium en 1440×900 et 390×844, pas de vrais téléphones, ni tous les points de rupture, ni d'autres navigateurs ni un audit complet d'accessibilité.
- DOM et mouvement : aucune relecture de liste complète observée en usage continu ou restauration
- Sur l'ensemble des 11 points de contrôle continus, les cartes conservées ont enregistré sameOriginalNode=true plutôt que de reconstruire toute la série. Les journaux animationstart des cartes et suggestions étaient vides, et les deux relecteurs ont inspecté la vidéo d'interaction continue. Une transition CSS localisée sur le bouton d'enregistrement a été relevée séparément, non comme une relecture de liste. Après rechargement, les six cartes restaurées et la suggestion affichaient cssAnimations=0, restoreAnimationStarts était vide, et état enregistré comme contenu de suggestion étaient restaurés.
- Actions mobiles et hiérarchie visuelle
- Avec quatre erreurs dans le viewport 390×844, les boutons annuler et soumettre mesuraient 48px de haut avec un bord inférieur à 819px, restant donc dans le viewport. Les deux actions étaient de vrais clics tactiles fiables, et l'envoi corrigé a survécu au rechargement. Les deux relecteurs à l'aveugle ont confirmé que le dialogue et le résumé d'erreur n'avaient pas d'épaisse barre d'accent supérieure tout en conservant une hiérarchie nette.
- Anciennes erreurs, petit texte et contraste des placeholders restent à améliorer
- Une fois les champs corrigés et avant le nouvel envoi, l'ancien résumé d'erreur et les erreurs par champ restaient visibles. Cela correspond à une validation à la soumission plutôt qu'à une panne fonctionnelle, mais réduit la réactivité du retour. Certains textes d'appoint restaient à 9–11px. Le relecteur A a mesuré le contraste du placeholder de saisie à environ 3,76:1, sous la référence de 4,5:1 pour le texte courant ; il s'agissait d'un contrôle ponctuel localisé, non d'un audit complet des contrastes.
Témoin sans Skill : 84,3, des interfaces complètes mais deux échecs qui restent visibles
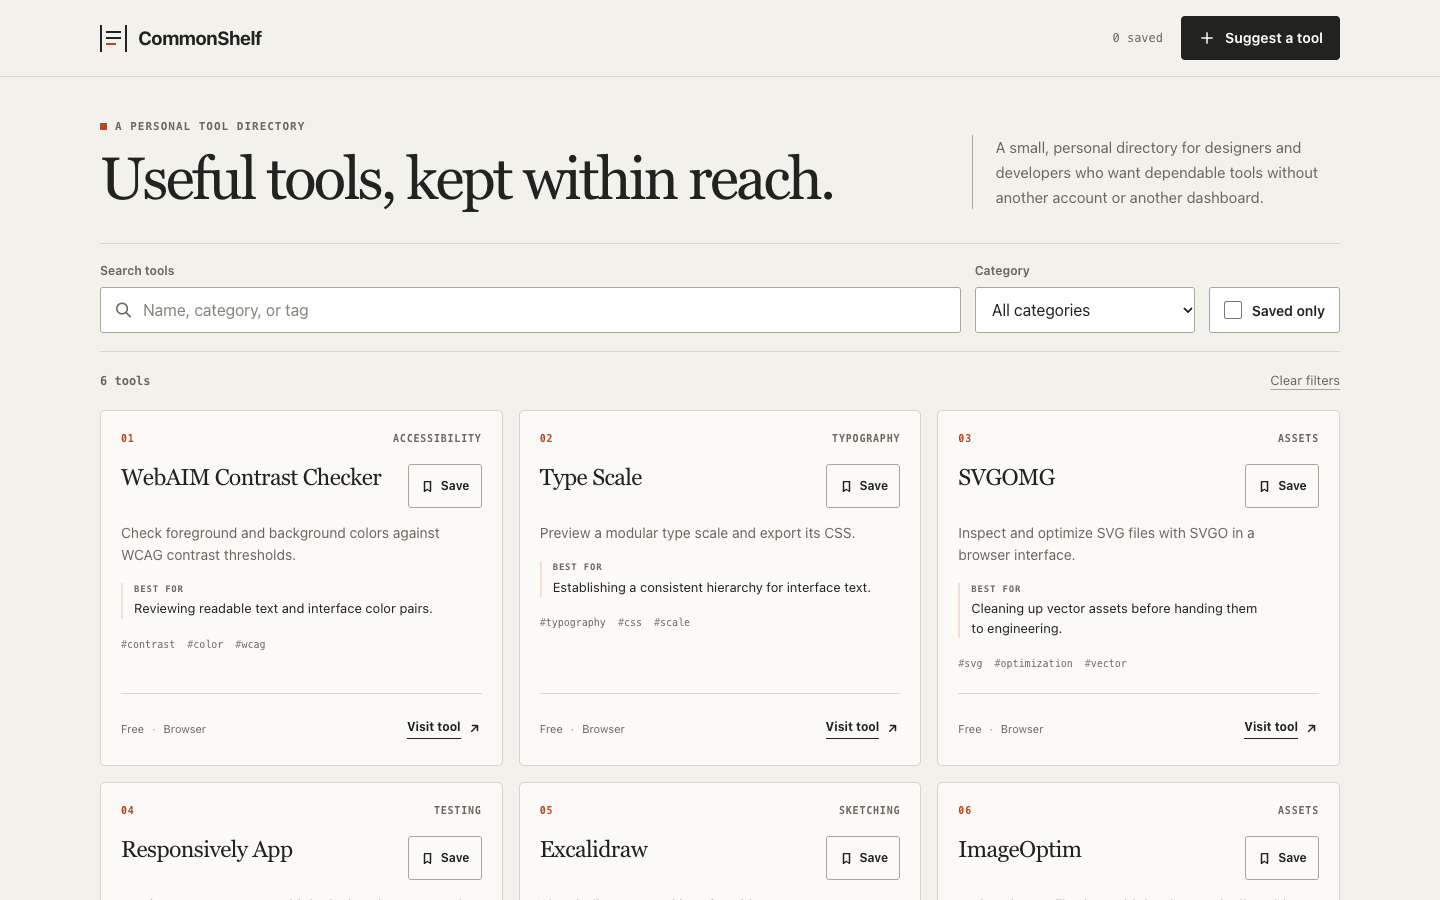
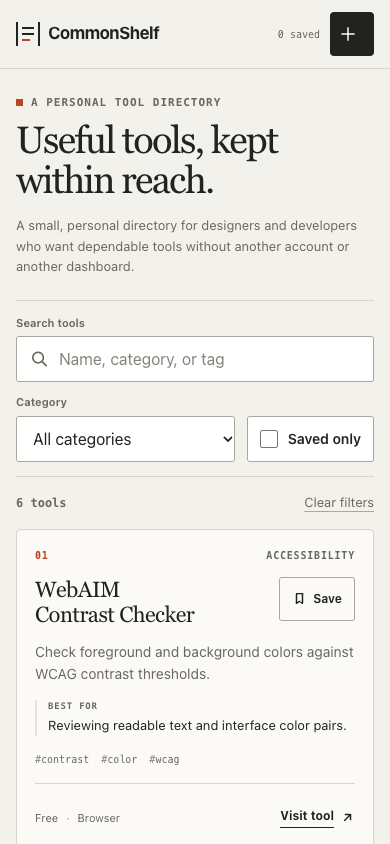
Les notes visuelles ont été de 83, 86 et 84. Papier chaud, numérotation et filets d'index formaient aussi des répertoires cohérents, avec des mises en page à trois colonnes sur bureau et une colonne sur mobile globalement nettes ; enregistrement et états vides s'appuyaient souvent sur plus que la couleur seule. Le modèle sous-jacent sait déjà produire des interfaces complètes sans Skill : les évaluations exigent donc des comparaisons concrètes plutôt qu'une hypothèse de score nul.
Run-1 et run-3 ont échoué sur l'assertion de texte exact du Toast dans interaction-and-persistence : le contrat attendait « Suggestion saved. » alors que le texte réel ajoutait une coche et des espaces. Sur run-3, cette coche portait aria-hidden dans le HTML, si bien que le résultat ne prouve pas que suggestions ou persistance étaient totalement cassées. Selon le contrat figé, les deux essais restent en échec à 5/6, et les étapes après l'assertion échouée ne peuvent être comptées comme acceptées.
Le texte d'appoint était régulièrement trop petit ou trop pâle. Sur run-3, des calculs de couleur échantillonnés ont relevé un contraste faible sur les numéros d'outils et les placeholders, et seul le bord supérieur des boutons bas du dialogue d'erreur mobile était visible d'emblée. Sur run-1, l'introduction et les filtres occupaient la majeure partie du premier écran mobile.
Tâche et versions : un seul brief CommonShelf
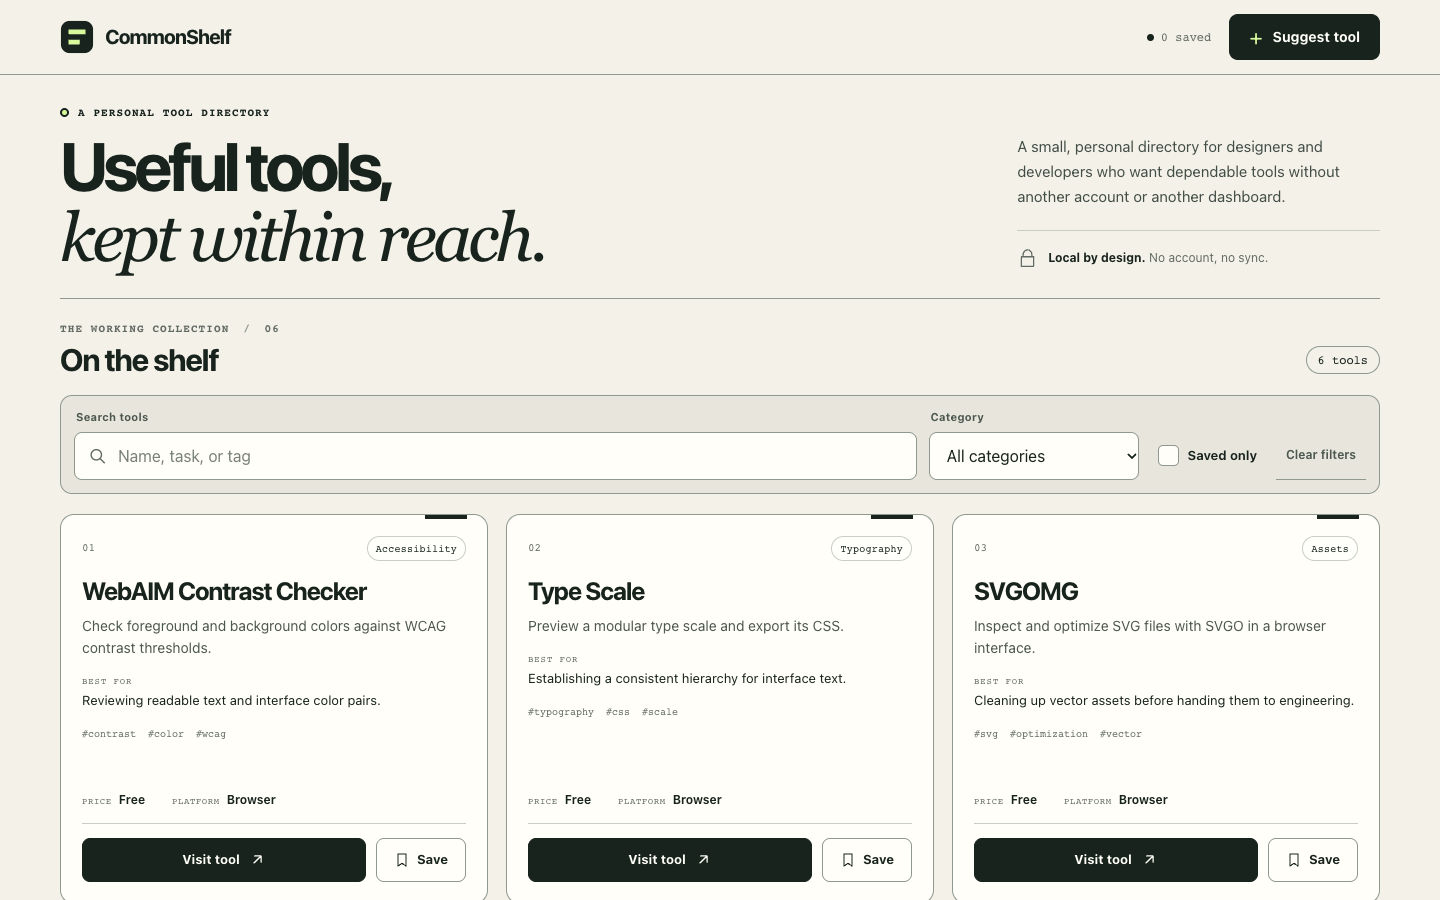
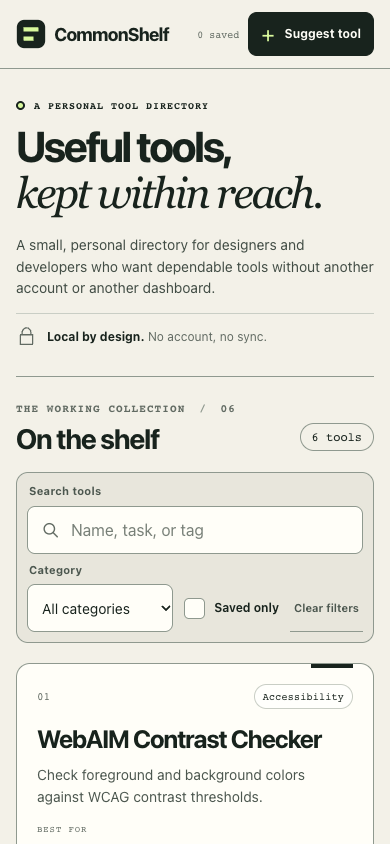
CommonShelf est un répertoire personnel d'outils sans parcours de compte. Le brief fournit six fiches d'outils fixes et impose d'implémenter en HTML, CSS et JavaScript purs la recherche, les filtres par catégorie et par état enregistré, l'enregistrement d'outils, un formulaire de suggestion validé et une FAQ utilisable au clavier. Hormis un lien officiel déclenché par l'utilisateur, la page n'émet aucune requête externe à l'exécution. Chaque agent livre une seule direction plutôt que d'en générer plusieurs pour en choisir une.
Chaque condition avec Skill ne lit qu'une fois son fichier SKILL.md assigné ; le témoin n'en lit aucun. Les versions sont figées avant la génération, sans remplacement par des éditions globales ou payantes, et les licences sont indiquées avec leurs sources.
| Condition | Version figée | Licence |
|---|---|---|
| Oil UI open source | 0.24.2 (tag v0.24.2) | MIT |
| frontend-design | commit-dbd4588f9e1033efb41dad4bef2f7947c8993d44 | Apache-2.0 |
| UI UX Pro Max | 2.15.0 (tag v2.15.0) | MIT |
| Impeccable | 4.7.0 (tag skill-v4.7.0) | Apache-2.0 |
| Témoin sans Skill | Aucun Skill ni version upstream | Aucune licence upstream fournie |
Méthode : 15 générations indépendantes, preuves fonctionnelles et visuelles séparées
Chaque génération a utilisé un agent neuf dans Kimi AgentSwarm avec kimi-1021-preview et l'effort de réflexion réglé au maximum. Les conditions pouvaient tourner en parallèle, mais run-1, run-2 et run-3 au sein d'une même condition ont été exécutés séquentiellement. Chaque exécution démarrait dans un espace de travail vierge, ne pouvait lire ni les pages, ni les captures, ni la conversation d'une autre exécution, et ne remplaçait pas une sortie plus faible. L'ordonnancement et la reprise influençant la durée écoulée, le temps n'a pas été comparé.
Après la génération, un exécuteur indépendant Playwright 1.64.1 a vérifié six groupes de scénarios dans Chromium : base bureau, base mobile, interaction et persistance, contenu indisponible, stockage indisponible et mouvement réduit, en 1440×900 et 390×844. La validation n'a renvoyé aucun correctif vers l'artefact généré, et les notes visuelles n'ont pas été assimilées à des validations fonctionnelles.
La revue visuelle a porté sur 15 dossiers anonymisés dont l'identité de condition et les traces de génération étaient masquées, tout en conservant fichiers d'exécution, captures et statuts d'acceptation. Chaque dossier a reçu une évaluation. Six scores de dimension ont été additionnés pour chaque exécution puis moyennés sur les trois essais ; les dimensions totalisent 100 points, sans pondération supplémentaire ni sélection d'un meilleur essai pour représenter les autres.
| Dimension | Maximum |
|---|---|
| Hiérarchie visuelle et lisibilité | 20 |
| Adéquation produit et originalité | 20 |
| Comportement responsive | 15 |
| Interaction et retour d'état | 20 |
| Accessibilité | 15 |
| Détail et mouvement | 10 |
Limites : ce que ces preuves établissent et ce qu'elles n'établissent pas
Le test couvre un brief statique CommonShelf en anglais, un modèle et trois échantillons finaux par condition. La grille en six dimensions comporte encore une part d'appréciation : une revue correspond à un dossier anonymisé, pas à une étude utilisateurs à grande échelle ni à une expérience de significativité statistique. Une autre tâche, langue de contenu, framework ou modèle pourrait modifier le résultat.
La validation fonctionnelle couvrait six groupes de scénarios prédéfinis sous Chromium, pas un audit produit complet. Les mises en page tablette disposaient de règles CSS mais pas de captures dédiées. Safari, Firefox, vrais appareils tactiles, lecteurs d'écran, zoom à 200 % et vérifications WCAG complètes n'ont pas été réalisés. Des captures statiques ne rendent pas compte du rythme d'une animation continue : les images transparentes d'Oil UI run-3 établissent un défaut de retour visuel, mais pas la qualité de l'état stabilisé après animation.
Les démos publiques conservent les vraies pages post-génération et les échecs fonctionnels. Les interruptions techniques et reprises imposées par le protocole n'ont pas été comptées comme échecs fonctionnels des candidats ni utilisées pour comparer les durées ; elles restent distinctes de l'acceptation indépendante post-génération.
Reproduire : inspectez les preuves, puis lancez votre propre comparaison
Appuyez-vous sur les 15 démos, les 20 images initiales et results.json ci-dessus pour vérifier cet article. Pour une réexécution comparable, gardez le même brief, les versions figées et le modèle ; démarrez un agent neuf à chaque fois ; conservez les trois sorties ; et exécutez une validation indépendante après génération. Le fichier de contenu public est identique octet pour octet à la copie servie avec la démo. Le prompt ci-dessous est un brief condensé de réexécution, pas le fichier de tâche figé d'origine.
La commande d'installation open source installe la version qu'elle résout au moment de l'exécution, pas nécessairement la 0.24.2. Pour une comparaison stricte, notez la version installée et utilisez les commits figés du tableau. Traitez toute version plus récente comme un nouveau test plutôt que d'écraser ces chiffres.
Installer Oil UI open source et noter la version
Essayez d'abord le Skill open source sur votre propre tâche. Oil UI Pro n'a pas été utilisé dans ce benchmark.
npx skills add oil-oil/oil-uiLancer trois générations indépendantes par condition
Gardez le modèle et les données de contenu fixes. Démarrez chaque essai avec un agent et un espace de travail neufs, livrez une seule direction, et n'importez ni ne réparez jamais la page d'un autre essai ni ne remplacez un résultat plus faible.
Séparer la validation fonctionnelle de la revue visuelle anonyme
Vérifiez les six groupes de scénarios en 1440×900 et 390×844 et conservez chaque réussite ou échec. Masquez l'identité des conditions pour la revue visuelle, appliquez les mêmes six dimensions et publiez chaque résultat, pas seulement les moyennes.
Build one complete CommonShelf static web app with plain HTML, CSS and JavaScript. Use the supplied content.json unchanged. Make one coherent direction without asking for a selection. At 1440×900 and 390×844, the first viewport must help a visitor find, understand and save tools. Implement combined search, category and saved-only filters; local-storage saves; a validated suggestion dialog; exactly three keyboard-operable FAQ items; actionable content-unavailable and storage-unavailable states; visible focus; and reduced motion. Keep suggestions outside the curated tool grid. Make no external requests except user-activated official links. Do not import another run or replace a weak result. Preserve every failure, then independently verify the actual page and review anonymized screenshots and runtime files.Il s'agit d'un brief condensé pour une réexécution comparable. Une reproduction stricte exige aussi les versions figées ci-dessus, les six groupes de scénarios de validation et la même grille de notation.
Exemples fonctionnels et prompts de la galerie
Parcourir la collection →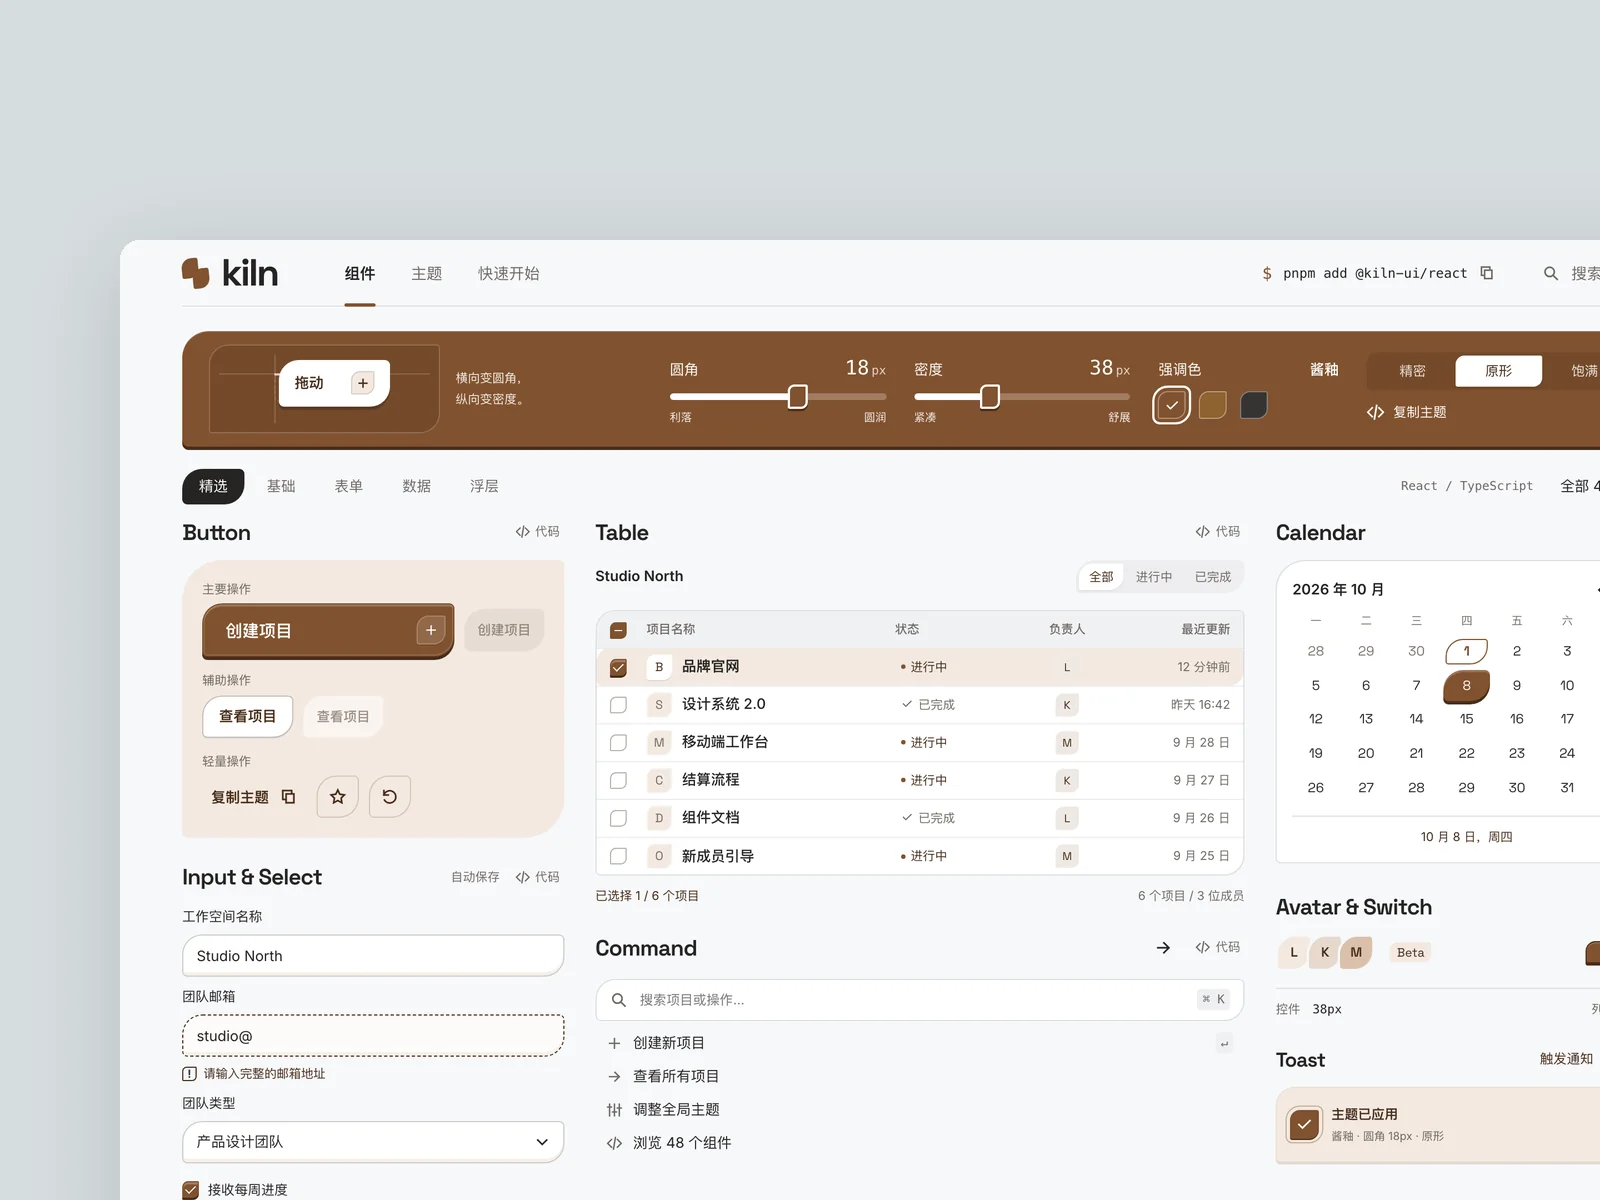
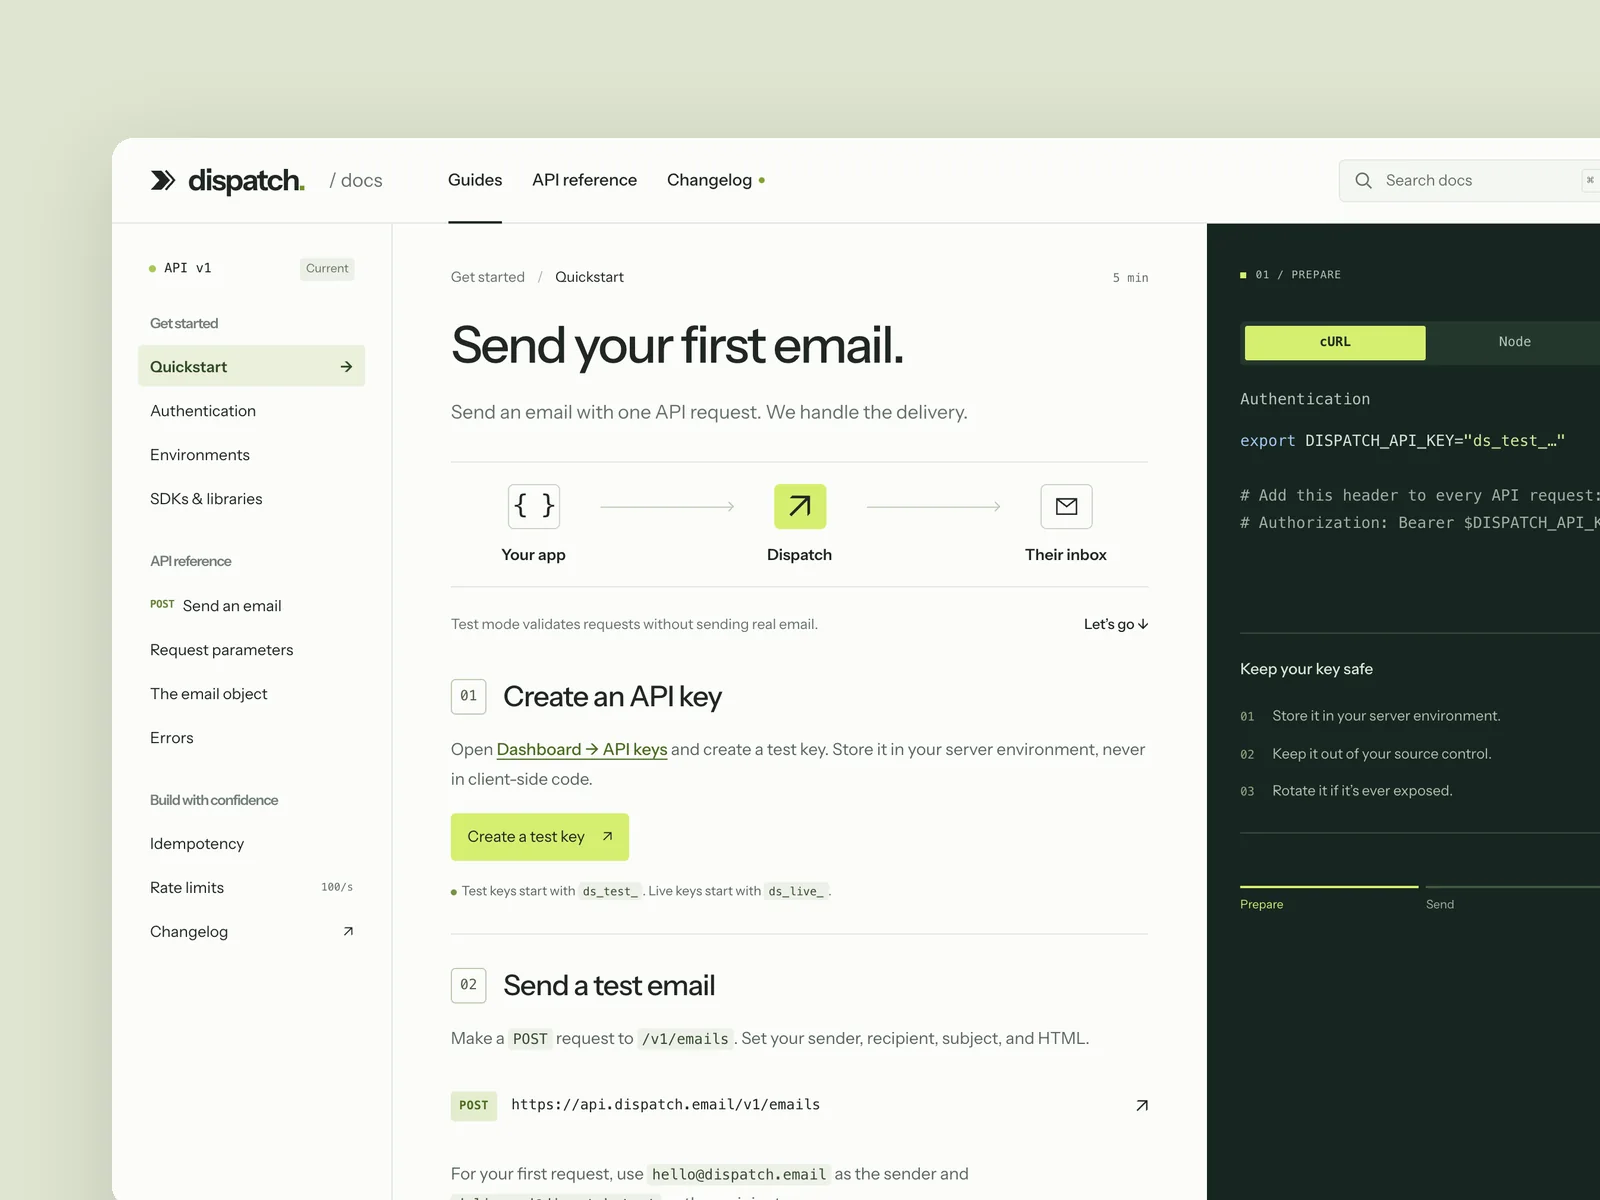
Commencer avec l'open source gratuit ; passer à Oil UI Pro pour les apps en production et la rénovation de code existant
Ce benchmark n'a testé que la base open source gratuite en mode un seul jet. Lorsque vous avez besoin de sélection de directions côte à côte, d'une rénovation sûre en 3 paliers de bases de code existantes, de 10 modèles d'espaces de travail complexes et de jusqu'à 3 cycles de revue à l'aveugle visant 9/10, passez à Oil UI Pro ($19.99 en achat unique, mises à jour à vie).
Découvrir Oil UI Pro →npx github:oil-oil/oil-cli install oil-ui-proQuestions fréquentes
Ce comparatif peut-il décider quel Skill je dois installer ?
Ne décidez pas uniquement d'après les moyennes. Comparez hiérarchie du catalogue, actions mobiles, mouvement, échecs fonctionnels et licences des sources, puis ouvrez les démos qui correspondent à vos priorités.
Pourquoi Oil UI run-3 a-t-il obtenu 83 en visuel si tous les scénarios fonctionnels ont réussi ?
L'acceptation confirme que les comportements spécifiés fonctionnent ; la revue visuelle examine aussi le retour visuel. Chaque reconstruction de carte de cet essai rejouait une animation depuis la transparence, laissant les zones de résultats presque vides dans plusieurs captures de recherche, d'enregistrement et de suggestion. Ce défaut de retour visible justifie la note de 83, mais ne prouve pas une perte de données permanente.
Les deux échecs sans Skill signifient-ils que l'enregistrement était totalement cassé ?
Non. Les deux essais ont échoué sur une assertion de texte exact du Toast parce que le texte réel ajoutait une coche et des espaces. Cela n'établit pas une panne totale d'enregistrement ou de persistance, mais contrevient au contrat fixé d'avance, si bien que les deux essais restent comptés en échec à 5/6.
Comment puis-je vérifier les chiffres et écrans de cet article ?
Téléchargez results.json pour consulter chaque score sur les six dimensions, le total et le bilan fonctionnel, puis ouvrez les trois images initiales bureau, l'image mobile et les trois démos fonctionnelles de chaque candidat. Chaque image mobile provient de run-1 ; aucun essai mieux noté n'a été substitué, et aucune capture de formulaire ne sert de visuel principal.