
UI 디자인 Skill 4종 실측: 단일 모델, 15회 생성, 익명 시각 리뷰
Kimi AgentSwarm에서 kimi-1021-preview를 사용해 고정 버전의 UI 디자인 Skill 4종과 Skill 없음 대조군이 같은 CommonShelf 도구 디렉터리 브리프를 각각 3회씩 실행하게 해 총 15회 생성했습니다. 기능 검수는 13회 통과, 2회 실패이며 두 실패 모두 대조군에서 나왔습니다. 시각 평균 점수는 Oil UI 87.0, frontend-design 88.0, UI UX Pro Max 86.7, Impeccable 88.0, Skill 없음 대조군 84.3입니다. UI 디자인 Skill을 선택할 때 디렉터리 위계, 모바일 작업, 모션, 기능 안정성이 중요하다면 아래 데모와 실패 상세를 비교해 보세요. 결론은 이 브리프와 모델에만 적용됩니다.
핵심 요점
- Skill 버전 네 가지는 생성 전에 모두 고정했습니다. 매번 새 Agent가 새 워크스페이스에서 하나의 방향만 독립적으로 완성했고 더 약한 결과를 다른 결과로 교체하지 않았습니다.
- 두 기능 실패는 모두 Skill 없음 대조군의 Toast 정확한 텍스트 단언에서 발생했으며 저장이나 영속성 전체가 실패했다는 뜻은 아닙니다.
- Oil UI run-3은 6/6 기능 시나리오를 통과했지만 투명한 상태에서 시작하는 카드 애니메이션을 반복 재생해 여러 상태 캡처가 거의 비어 보였고 시각 점수는 83점이었습니다.
과제와 버전: 동일한 CommonShelf 브리프
CommonShelf는 계정 절차가 없는 개인 도구 디렉터리입니다. 브리프는 고정된 도구 데이터 여섯 건을 제공하고 순수 HTML, CSS, JavaScript로 검색, 카테고리 및 저장 상태 필터, 도구 저장, 유효성 검사가 적용된 제안 폼, 키보드로 조작 가능한 FAQ를 구현하도록 요구합니다. 사용자가 공식 도구 링크를 직접 여는 경우를 제외하고 페이지는 실행 중 외부 요청을 하지 않습니다. 각 Agent는 여러 버전을 만들어 고르는 대신 하나의 방향만 전달합니다.
각 Skill 조건은 지정된 SKILL.md를 한 번만 읽고 대조 조건은 읽지 않았습니다. 버전은 생성 전에 고정하며 전역 설치나 유료 버전으로 대체하지 않고 라이선스는 출처와 함께 나열합니다.
| 조건 | 고정 버전 | 라이선스 |
|---|---|---|
| Oil UI 오픈소스 | 0.24.2 (tag v0.24.2) | MIT |
| frontend-design | commit-dbd4588f9e1033efb41dad4bef2f7947c8993d44 | Apache-2.0 |
| UI UX Pro Max | 2.15.0 (tag v2.15.0) | MIT |
| Impeccable | 4.7.0 (tag skill-v4.7.0) | Apache-2.0 |
| Skill 없음 대조군 | 업스트림 Skill 또는 버전 없음 | 업스트림 라이선스 미제공 |
방법: 15회 독립 생성, 기능과 시각 증거의 분리
모든 생성은 Kimi AgentSwarm에서 새 Agent가 kimi-1021-preview, thinking effort max로 실행했습니다. 조건 간 병렬 실행은 가능했지만 같은 조건의 run-1, run-2, run-3은 순차적으로 진행했습니다. 매번 새 워크스페이스를 사용하고 다른 실행의 페이지, 스크린샷, 대화를 읽거나 약한 결과를 교체하지 않았습니다. 스케줄링과 복구는 소요 시간에 영향을 주므로 시간은 비교하지 않았습니다.
생성 후 독립 Playwright 1.64.1 검수기가 Chromium에서 데스크톱 기준, 모바일 기준, 상호작용과 영속성, 콘텐츠 사용 불가, 스토리지 사용 불가, 모션 줄이기의 여섯 시나리오 그룹을 1440×900 및 390×844로 검사했습니다. 검수 결과를 같은 버전의 생성에 반영하지 않았고 시각 점수를 기능 결과로 대신하지 않았습니다.
시각 리뷰는 조건 정보와 생성 과정을 숨긴 익명 자료 묶음 15개를 사용하고 실행 파일, 스크린샷, 검수 상태는 남겼습니다. 자료 묶음마다 한 번씩 리뷰하고 각 실행의 여섯 차원 점수를 합산한 다음 세 실행의 산술평균을 계산했습니다. 여섯 차원은 총 100점이며 추가 가중치나 높은 점수의 run을 대표로 선택하는 방식은 없었습니다.
| 차원 | 만점 |
|---|---|
| 시각 위계와 가독성 | 20 |
| 제품 적합성과 독창성 | 20 |
| 반응형 동작 | 15 |
| 상호작용과 상태 피드백 | 20 |
| 접근성 | 15 |
| 세부 사항과 모션 | 10 |
결과: 모든 실행 점수와 기능 결과
15회 생성과 15건의 익명 시각 리뷰를 모두 완료했고 기능 검수는 13회 통과, 2회 실패였습니다. 평균은 세 실행 총점을 3으로 나누어 소수점 한 자리로 표시하며 UI UX Pro Max는 260/3, Skill 없음 대조군은 253/3입니다. 공개 JSON에는 각 실행의 여섯 차원 점수, 기능 결과, 공개 자료 URL이 포함되어 있습니다.
| 조건 | run-1 | run-2 | run-3 | 세 실행 합계 | 평균 | 기능 검수 |
|---|---|---|---|---|---|---|
| Oil UI 오픈소스 | 88 · 통과 | 90 · 통과 | 83 · 통과 | 261/300 | 87.0 | 3/3 통과 |
| frontend-design | 87 · 통과 | 87 · 통과 | 90 · 통과 | 264/300 | 88.0 | 3/3 통과 |
| UI UX Pro Max | 86 · 통과 | 88 · 통과 | 86 · 통과 | 260/300 | 86.7 | 3/3 통과 |
| Impeccable | 88 · 통과 | 87 · 통과 | 89 · 통과 | 264/300 | 88.0 | 3/3 통과 |
| Skill 없음 대조군 | 83 · 실패 | 86 · 통과 | 84 · 실패 | 253/300 | 84.3 | 1/3 통과, 2회 실패 |
Oil UI 오픈소스 0.24.2: 87.0, run-3의 반복적인 투명 재생으로 인한 감점
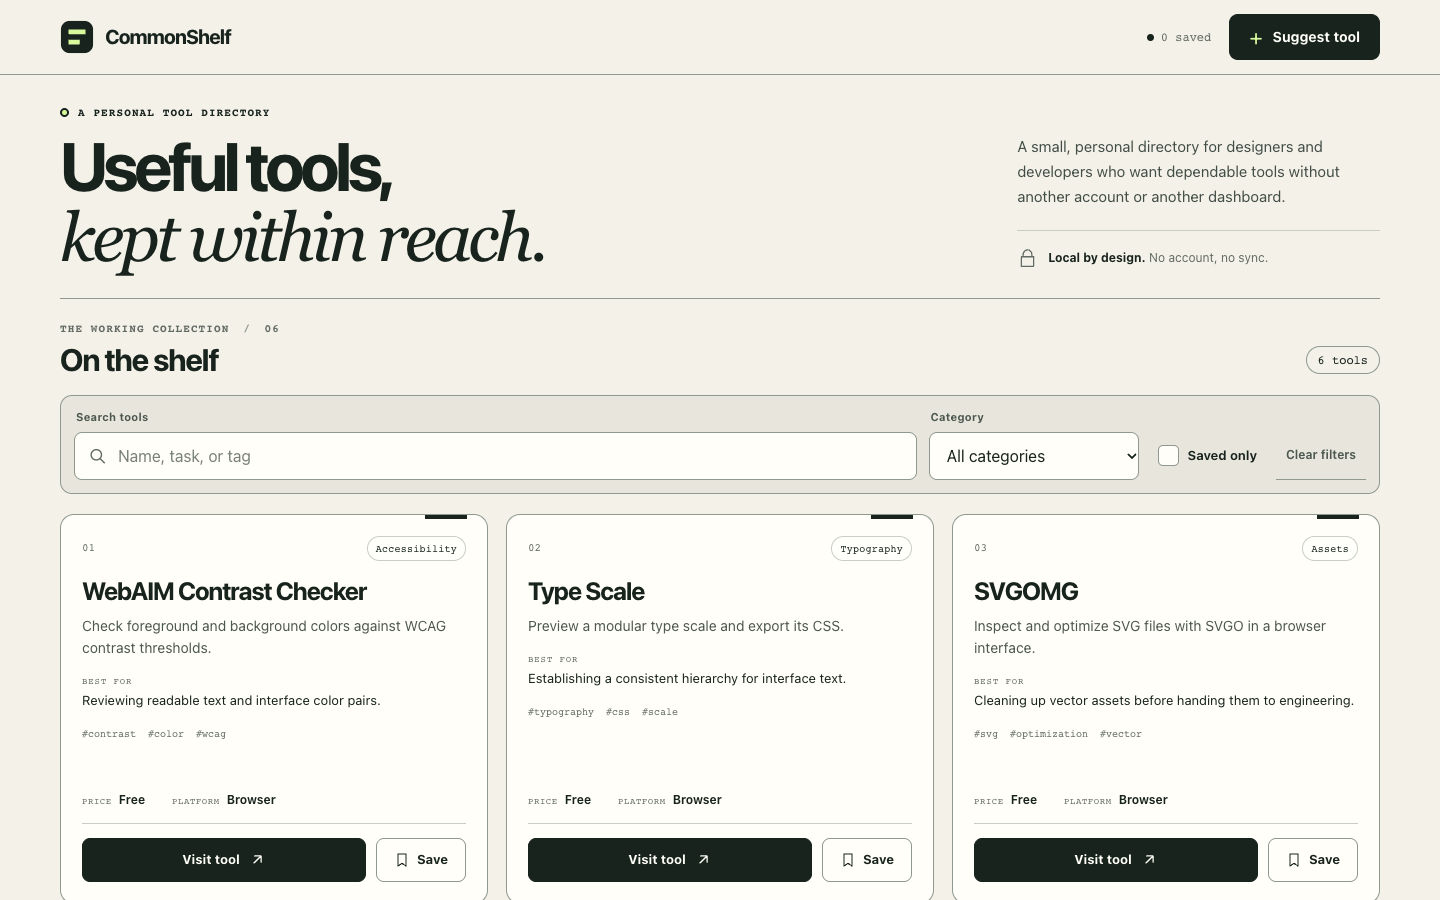
시각 점수는 88, 90, 83이며 기능 검수는 매번 6/6를 통과했습니다. 세 결과 모두 검색, 필터, 도구 여섯 개를 제품 중심에 두고 카드 정보 순서를 안정적으로 유지했습니다. 저장하면 텍스트, 아이콘이나 형태, 채우기, 개수가 함께 바뀝니다. 결과 없음은 재설정, 로딩 실패는 재시도가 가능하고 폼 오류에는 요약과 필드별 복구 안내를 제공합니다.
run-1은 모바일의 긴 폼에서 오류가 나타난 뒤 전체 작업 행을 확인하려면 스크롤해야 했고 일부 상태 캡처에는 후속 카드가 거의 투명한 입장 프레임이 잡혔습니다. run-2는 공유 인덱스 선과 저장 탭이 더 완전해졌지만 420ms 입장 효과로 검색 및 제안 새로고침 캡처에 하얗게 바랜 중간 프레임이 남았습니다. 작은 모노스페이스 보조 텍스트도 긴 페이지를 읽기 어렵게 만들었습니다.
run-3에서는 renderTools()로 카드를 다시 만들 때마다 opacity: 0에서 시작하는 180ms card-in 애니메이션을 재생했습니다. 검색 캡처에는 “1 tool”이라고 표시되었지만 결과 카드가 보이지 않았고 모바일 검색, 저장 새로고침, 제안 새로고침에서도 거의 투명한 카드가 나타났습니다. 기능 검수는 통과했지만 일상적인 필터링 중 주요 콘텐츠가 반복적으로 사라져 피드백이 끊겼으므로 시각 점수는 83점입니다. 이 프레임들이 결과의 영구 손실을 증명하지는 않습니다.
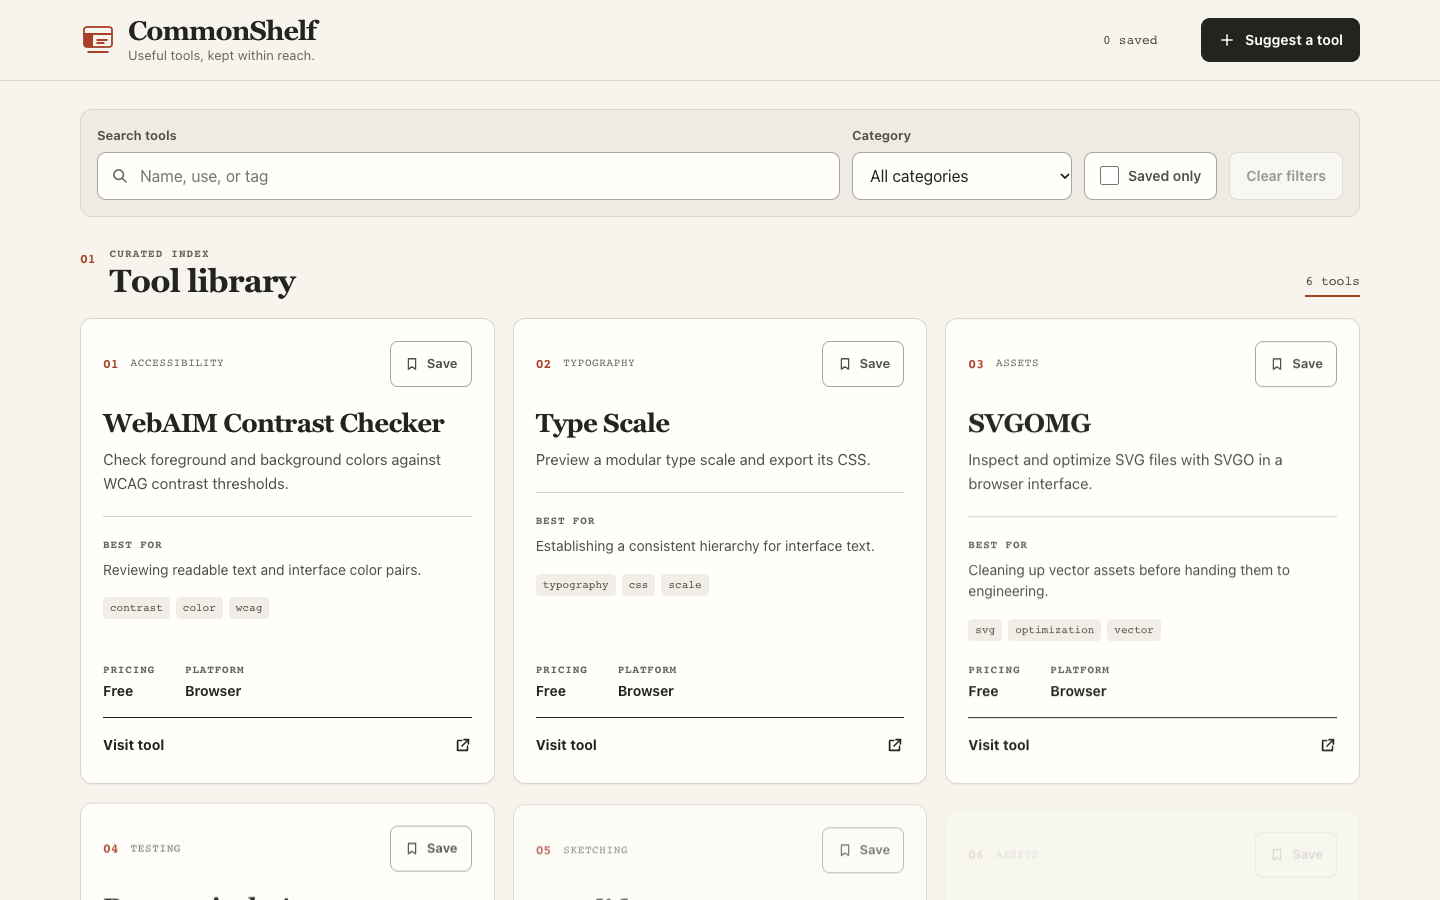
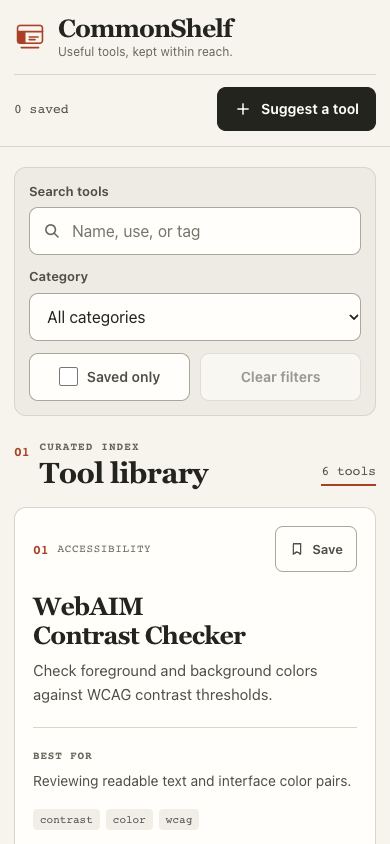
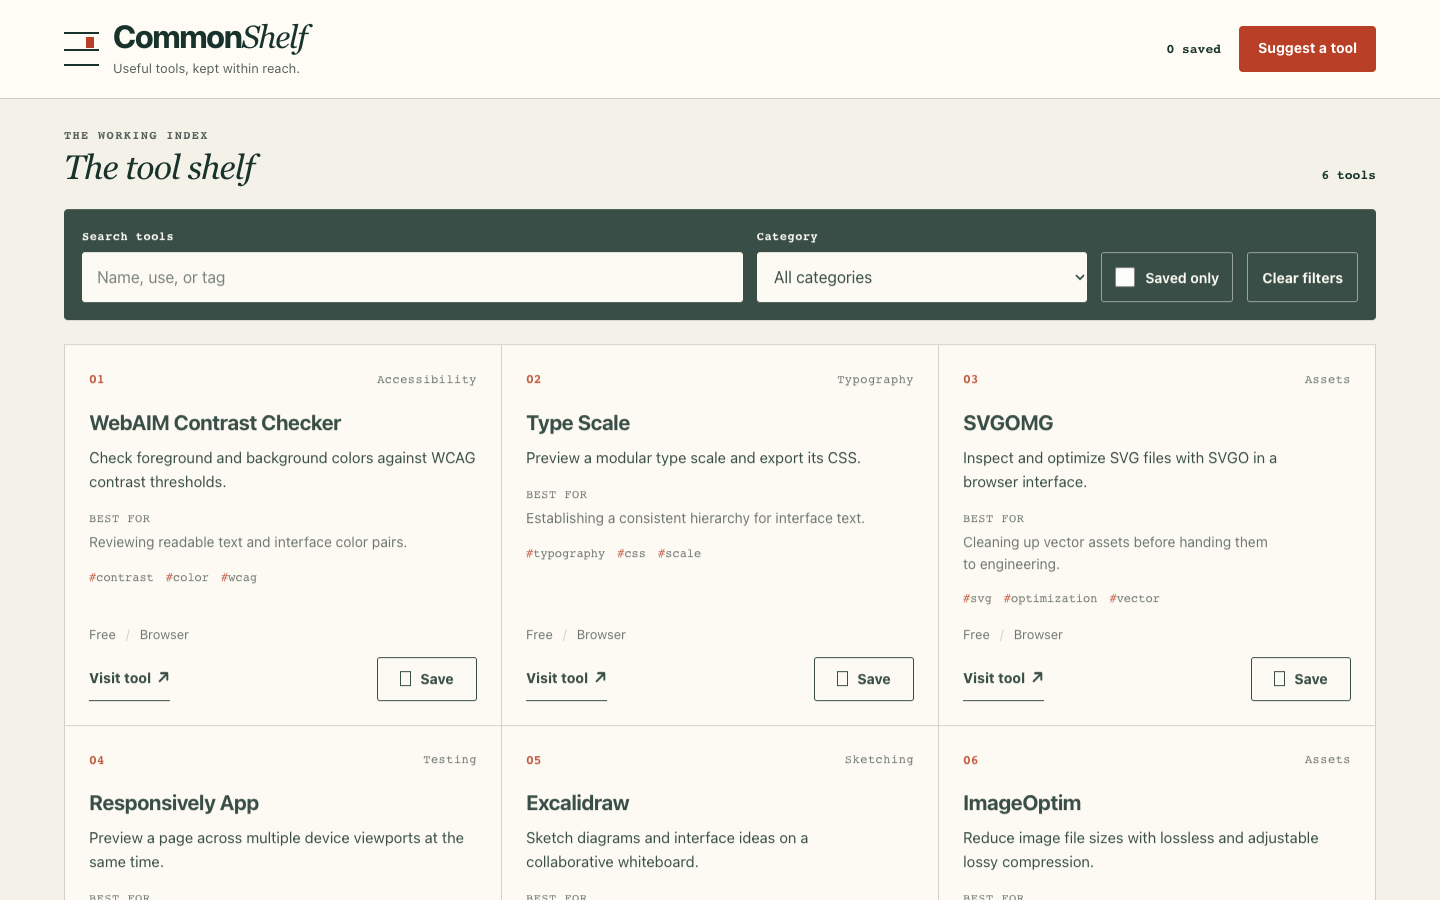
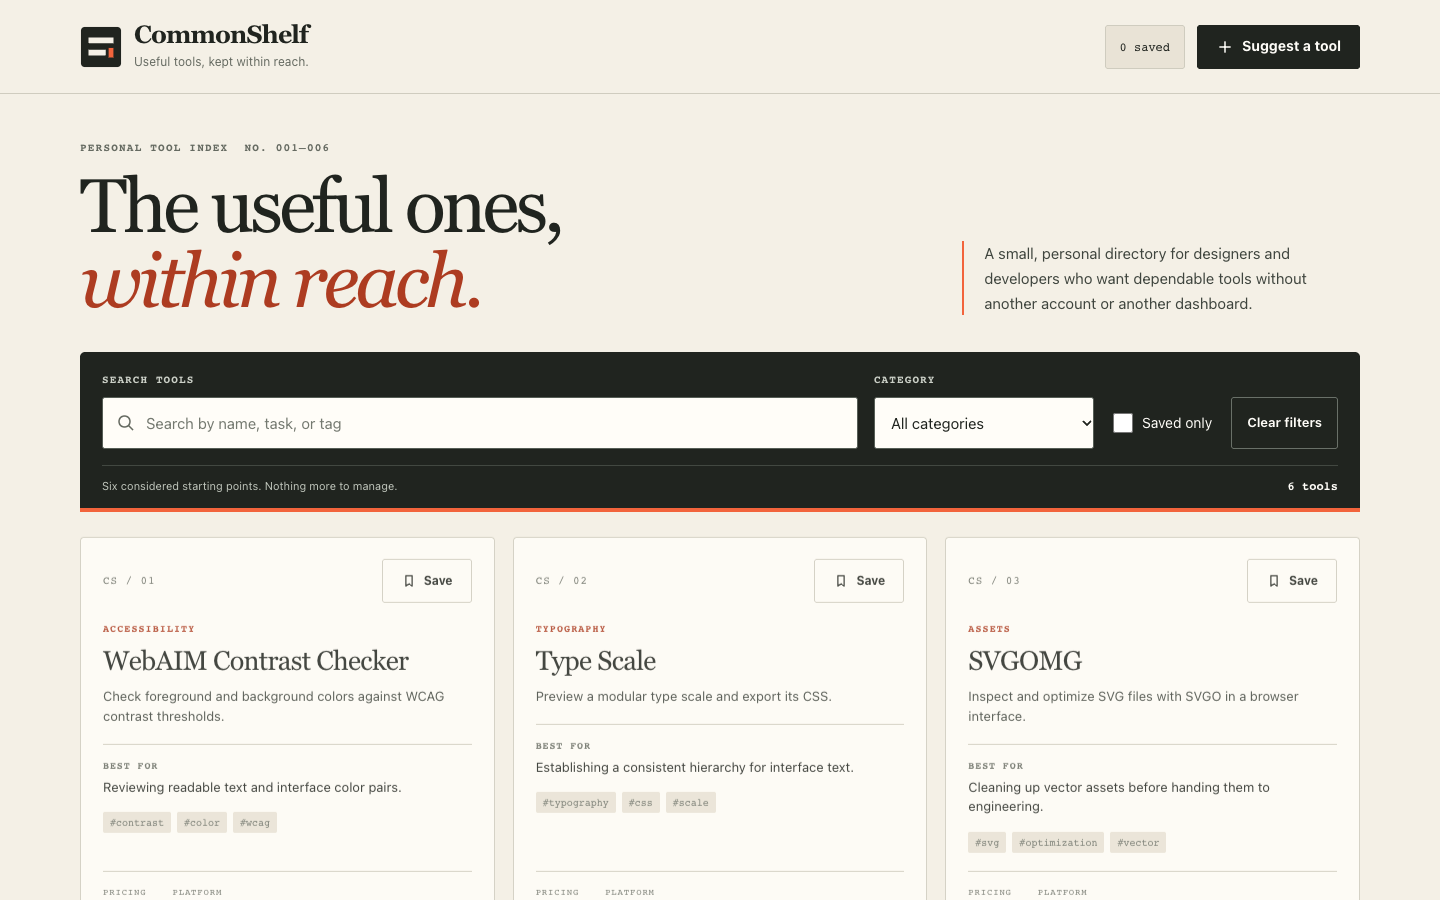
frontend-design: 88.0, 일관된 작업 서랍 언어와 반복되는 강조
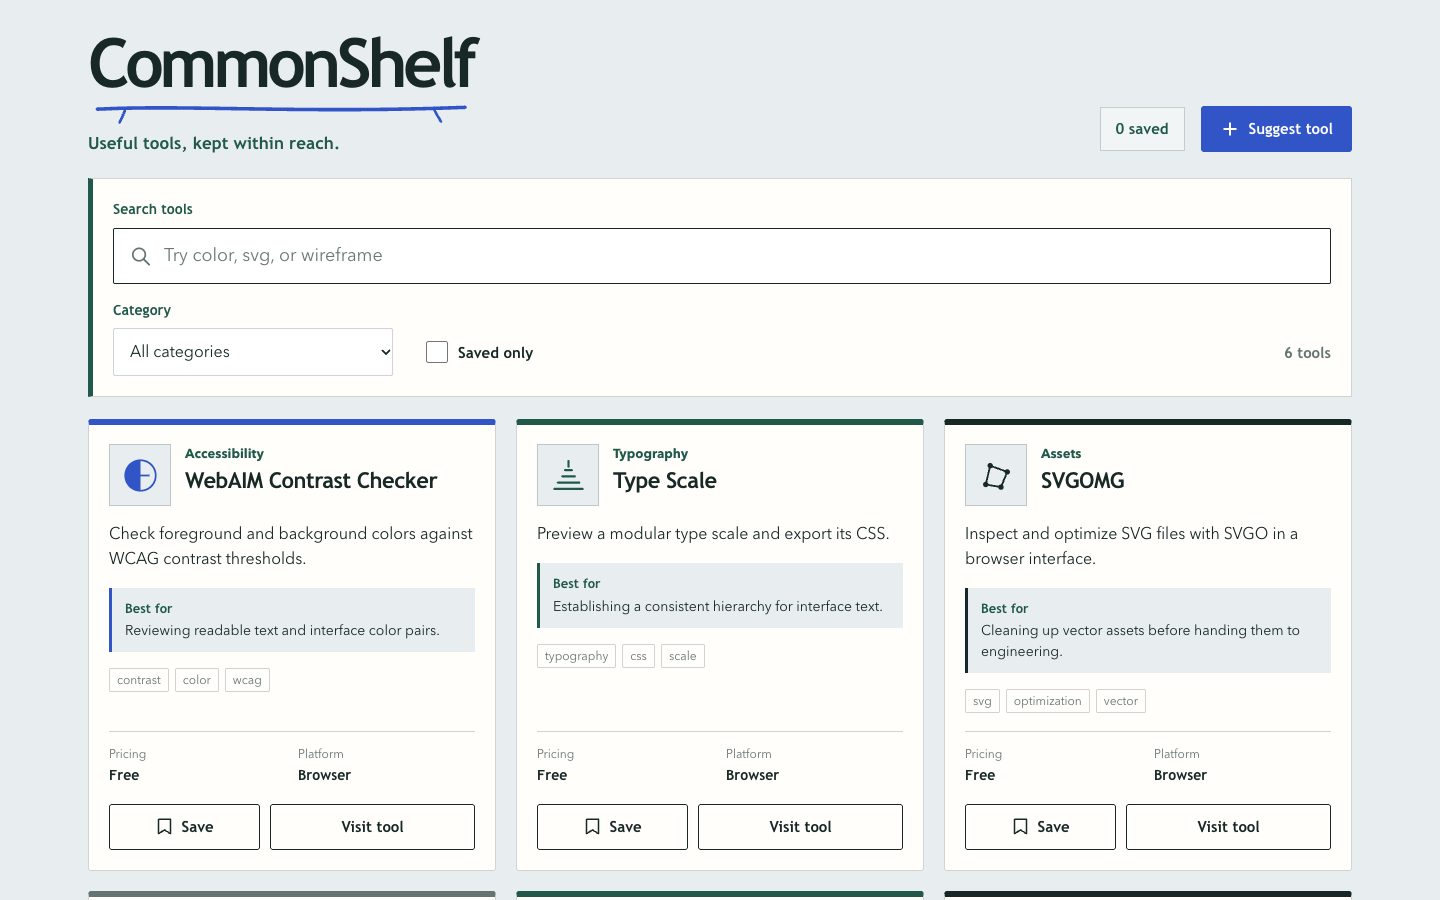
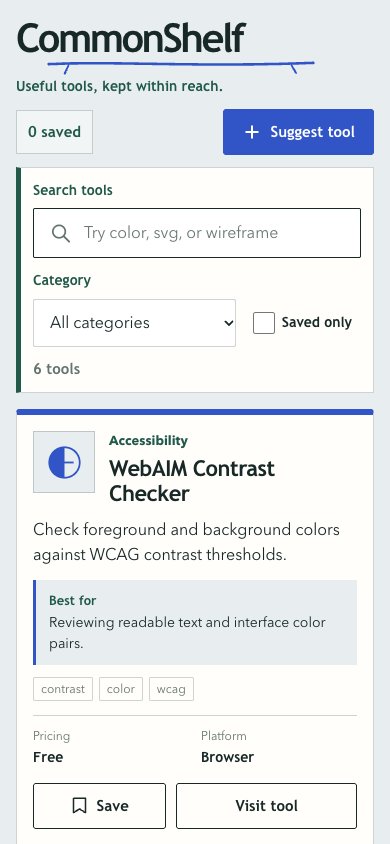
시각 점수는 87, 87, 90이며 기능 검수는 매번 6/6를 통과했습니다. run-1은 차가운 회색 표면, 라벨지, 손으로 그린 선반 선, 북마크, 서로 다른 도구 기호로 “작업 서랍” 방향을 만들고 요약과 사용 사례를 중심에 두었습니다. 저장하면 텍스트, 북마크 채우기, 표면 색이 바뀌며 모바일 첫 카드와 폼 오류 상태의 작업도 온전히 보였습니다.
run-2는 정보 위계가 여전히 명확하지만 도구 카드의 6px 상단 막대, 굵은 카드 하단선, 필터와 제안 영역의 왼쪽 선이 겹쳐 시각적으로 무거워졌습니다. 모바일 오류 대화 상자의 취소와 저장은 844px 초기 뷰포트 밖에 있어 스크롤이 필요했습니다. run-3도 파란 왼쪽 선을 반복하고 라벨과 메타 정보를 작게 사용했습니다. Impeccable과 평균은 같지만 화면과 약점은 다릅니다.
UI UX Pro Max 2.15.0: 86.7, 상태는 완전하지만 모바일 밀도와 작업 위치에서 감점
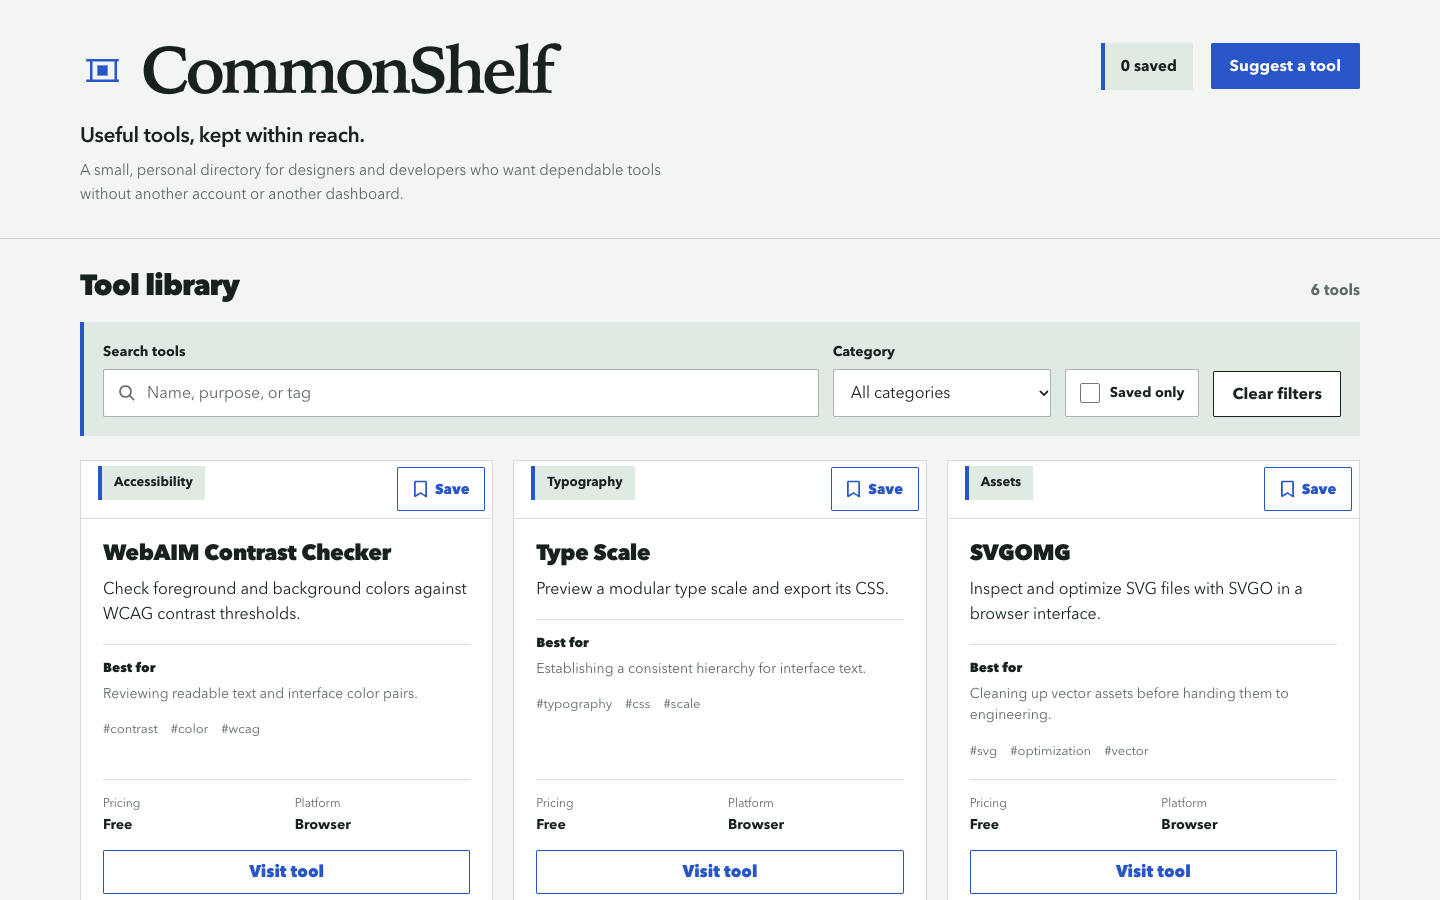
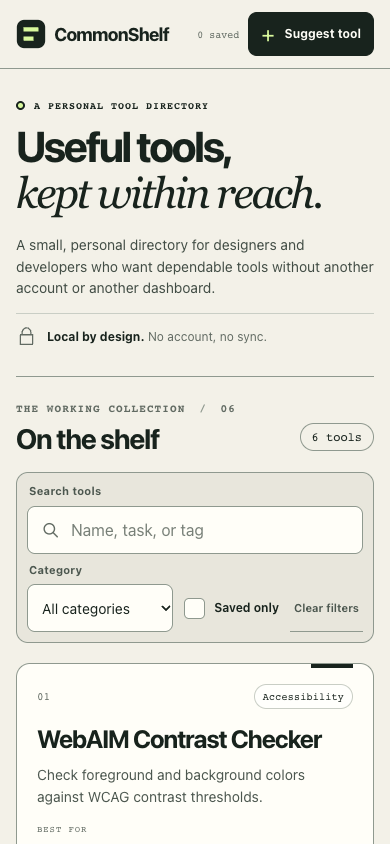
시각 점수는 86, 88, 86이며 기능 검수는 매번 6/6를 통과했습니다. 세 버전 모두 여섯 도구를 이름, 요약, 사용 사례, 태그, 가격, 플랫폼별로 일관되게 구성합니다. 저장은 Save/Saved 텍스트, 북마크, 개수, Saved only 상태를 업데이트하고 로딩 실패, 스토리지 저하, 폼 오류에도 각각 복구 경로가 있습니다.
run-2는 도구 카드의 4px 상단 강조와 제안 및 사양 영역의 왼쪽 선을 반복했고 12px 카테고리, 번호, 태그가 많아 정형화된 느낌이 들었습니다. run-3은 첫 모바일 도구 카드가 약 712px에서 시작해 844px 뷰포트에서는 카드 상단만 보였고 전체 페이지 높이는 약 4695px였습니다. 데스크톱과 모바일의 긴 오류 폼에서 제출과 취소를 찾으려면 스크롤해야 했고 검수는 통과했지만 완료 과정이 덜 직접적이었습니다.
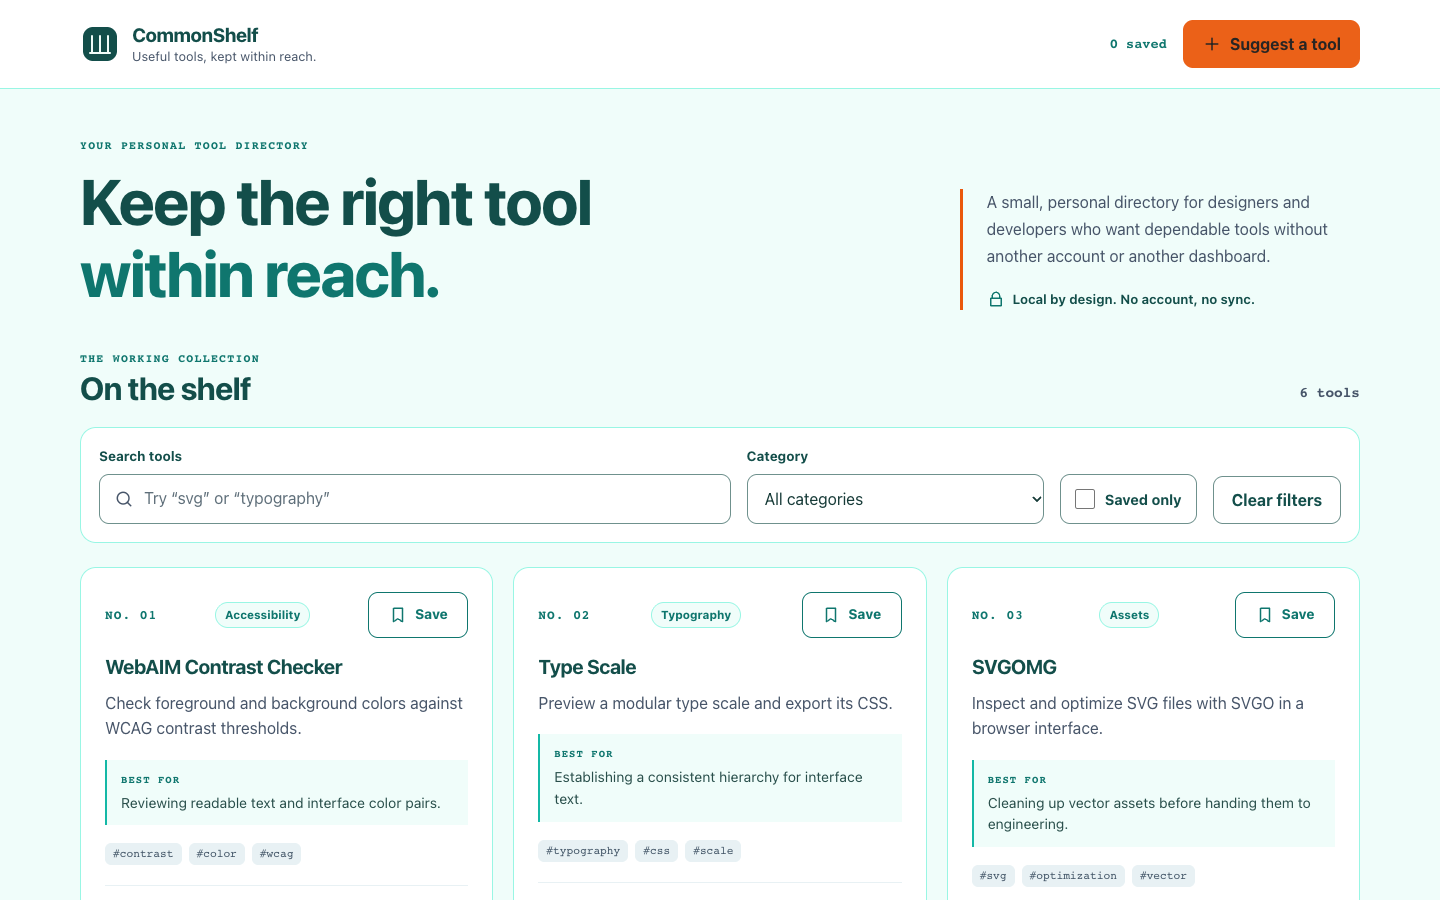
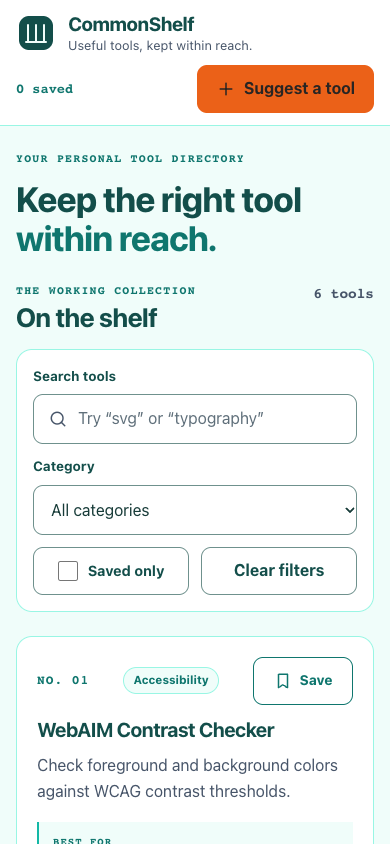
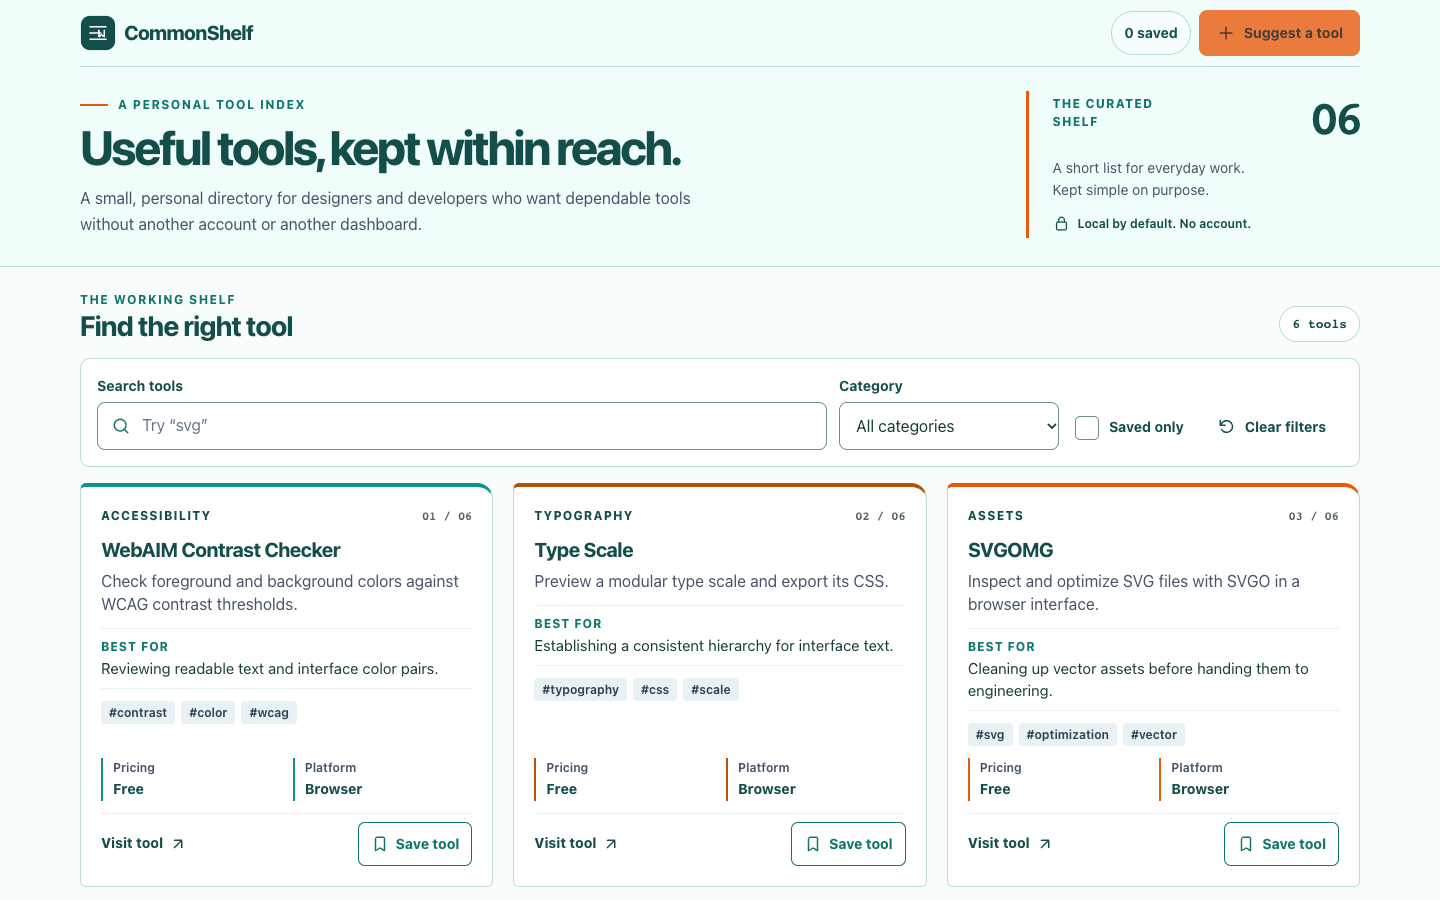
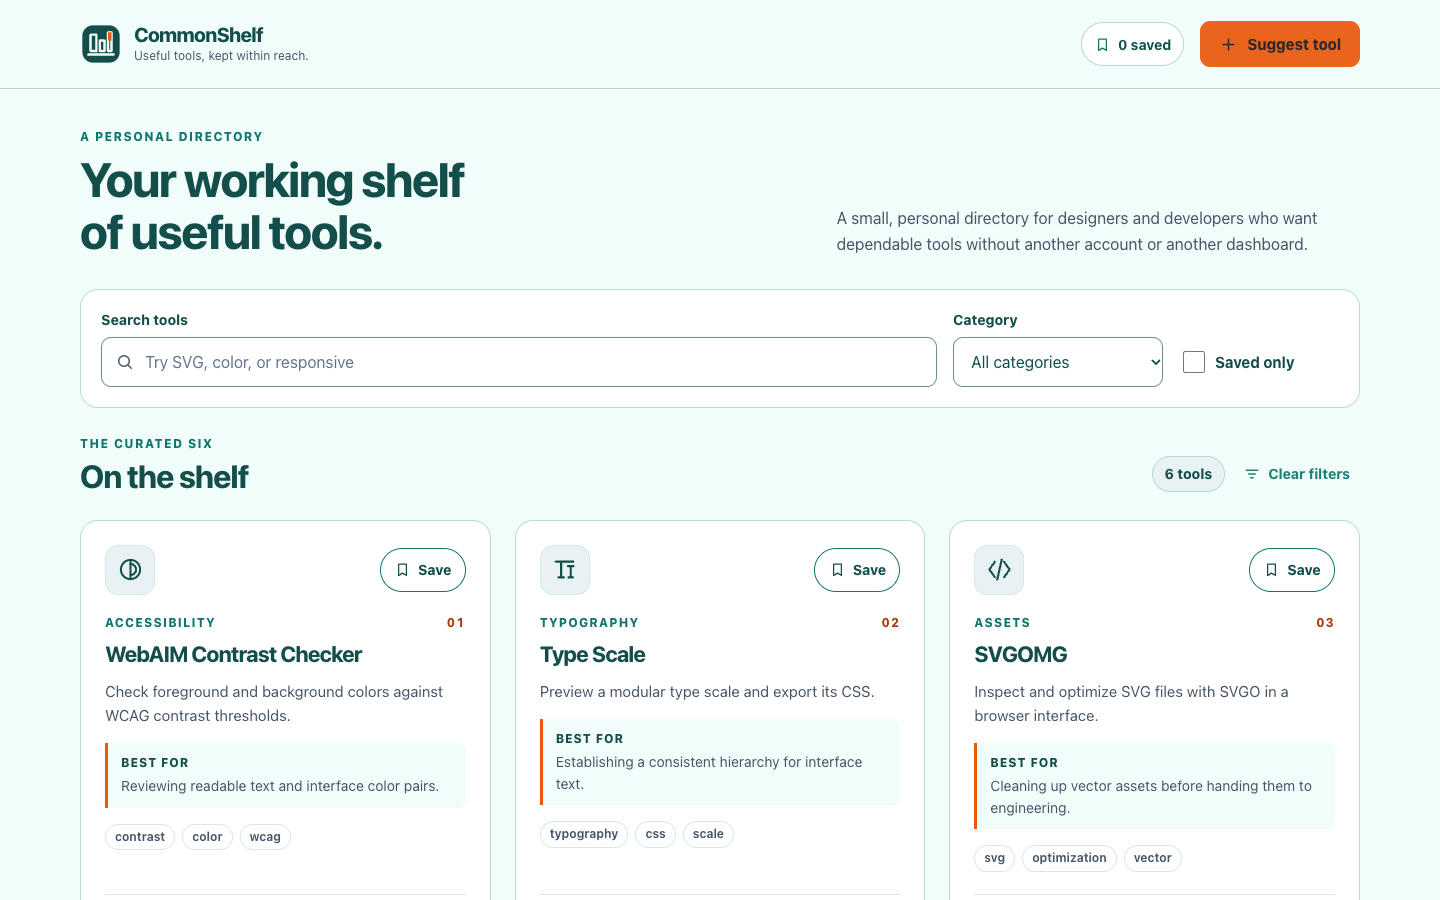
Impeccable 4.7.0: 88.0, 실제 상태와 연결된 디렉터리 세부 사항
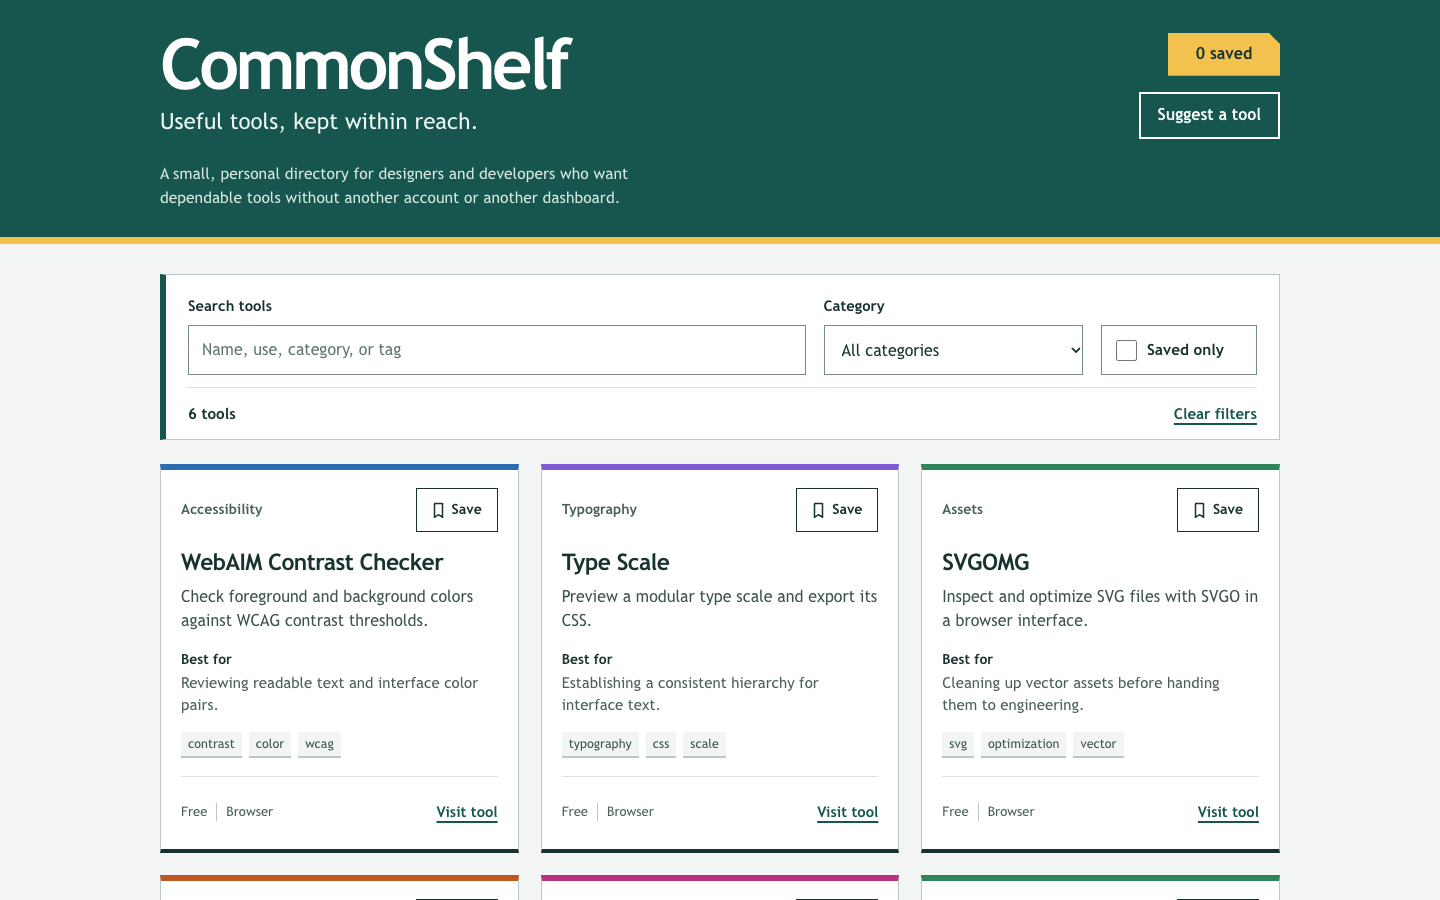
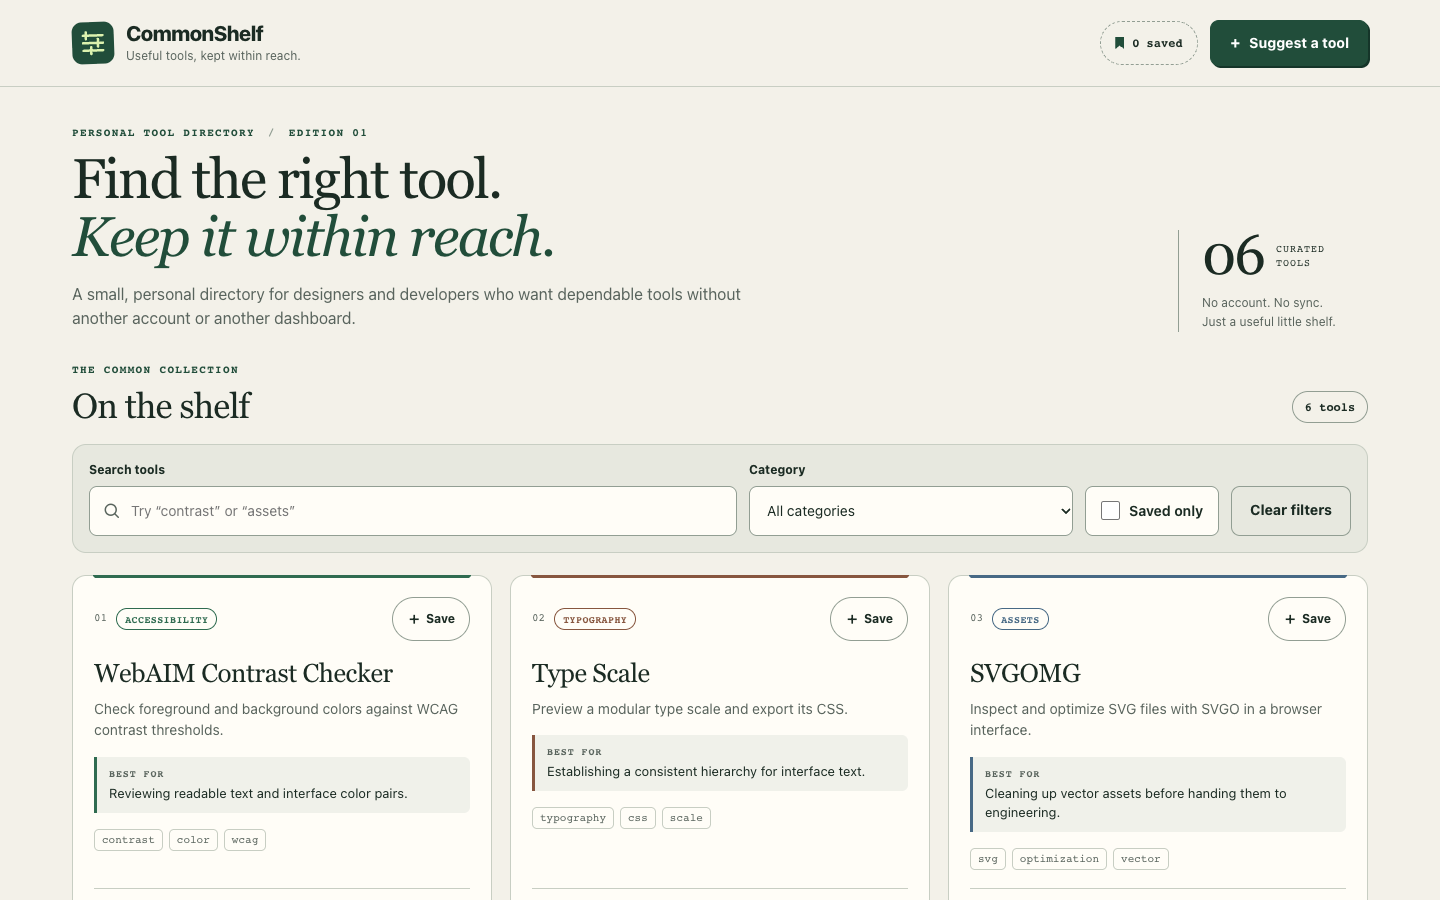
시각 점수는 88, 87, 89이며 기능 검수는 매번 6/6를 통과했습니다. run-1은 타공, 점선, 스티치 마크로 일관된 티켓 견본 방향을 만들었습니다. run-3의 Catalog register는 검색, 저장, 필터링에 따라 선 스타일이 바뀌어 장식과 실제 상태를 연결했습니다. 저장 피드백은 텍스트, 표시, 채우기 또는 테두리를 조합하고 결과 없음과 로딩 실패에는 다음 행동을 제공했습니다.
run-1은 같은 행 카드에서 콘텐츠 길이에 따라 요약, 태그, 메타 정보의 기준선이 어긋났고 12px 메타 정보는 약했습니다. run-2는 높은 머리글과 여러 필터 층 때문에 모바일 첫 뷰포트에서 도구 작업이 줄었고 전체 페이지가 3149px에 달했습니다. 여러 모바일 오류 대화 상자에서도 취소와 저장을 확인하려면 추가로 스크롤해야 했습니다.
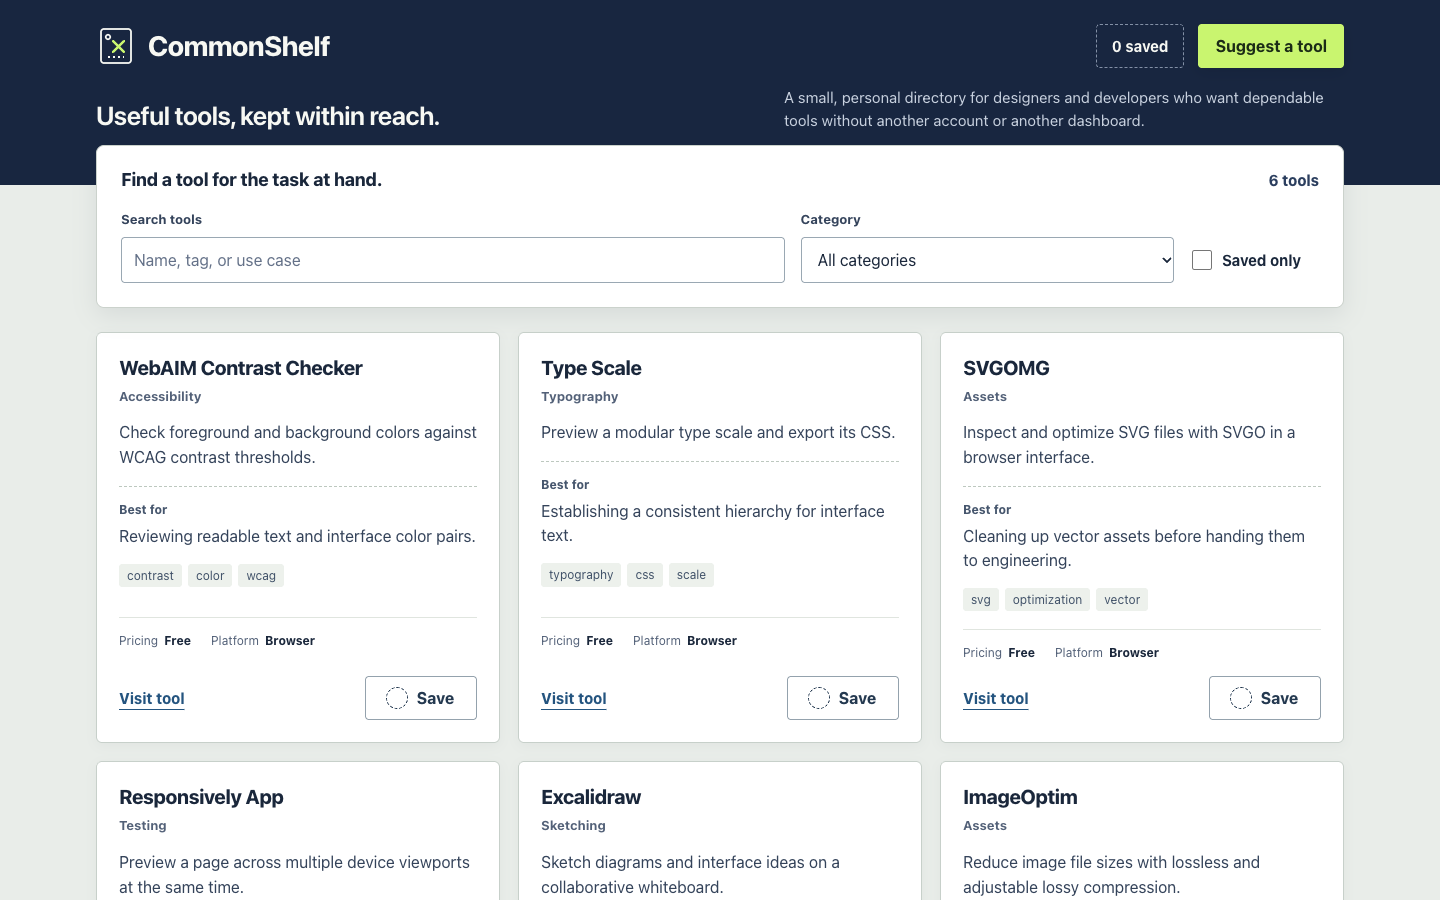
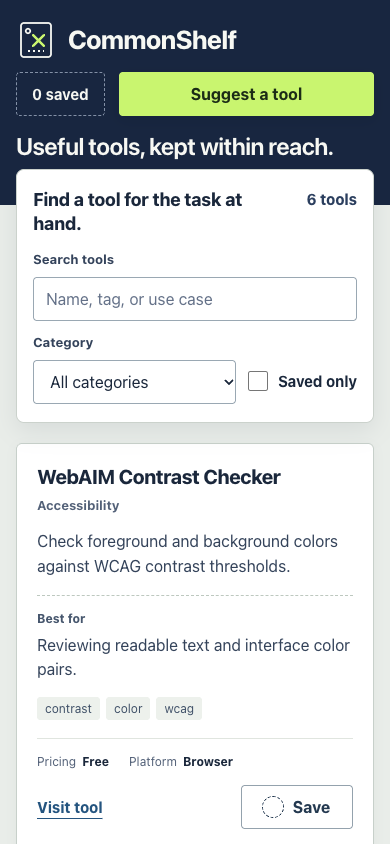
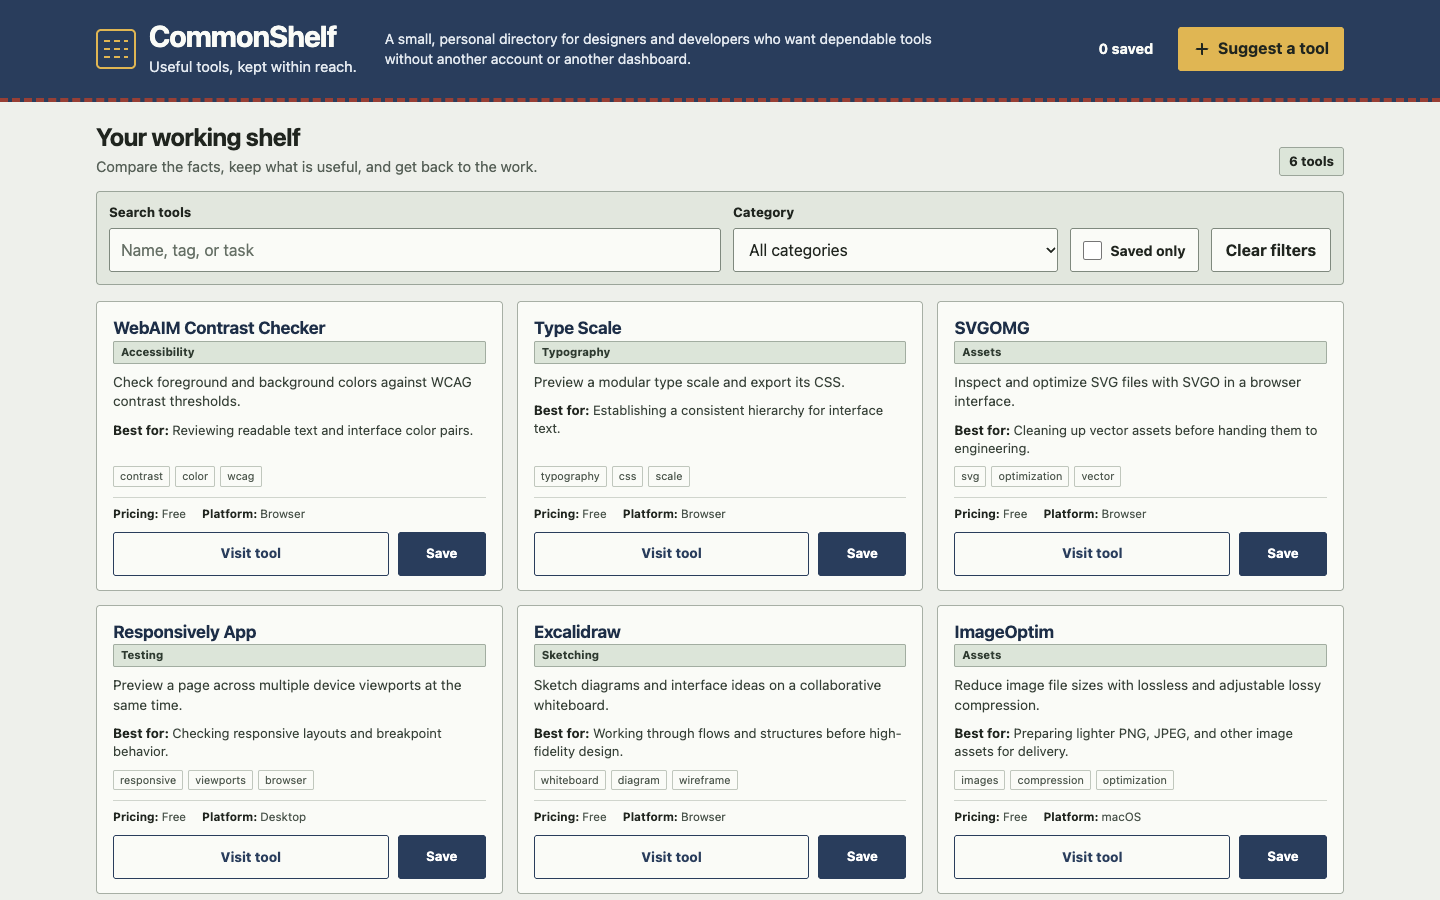
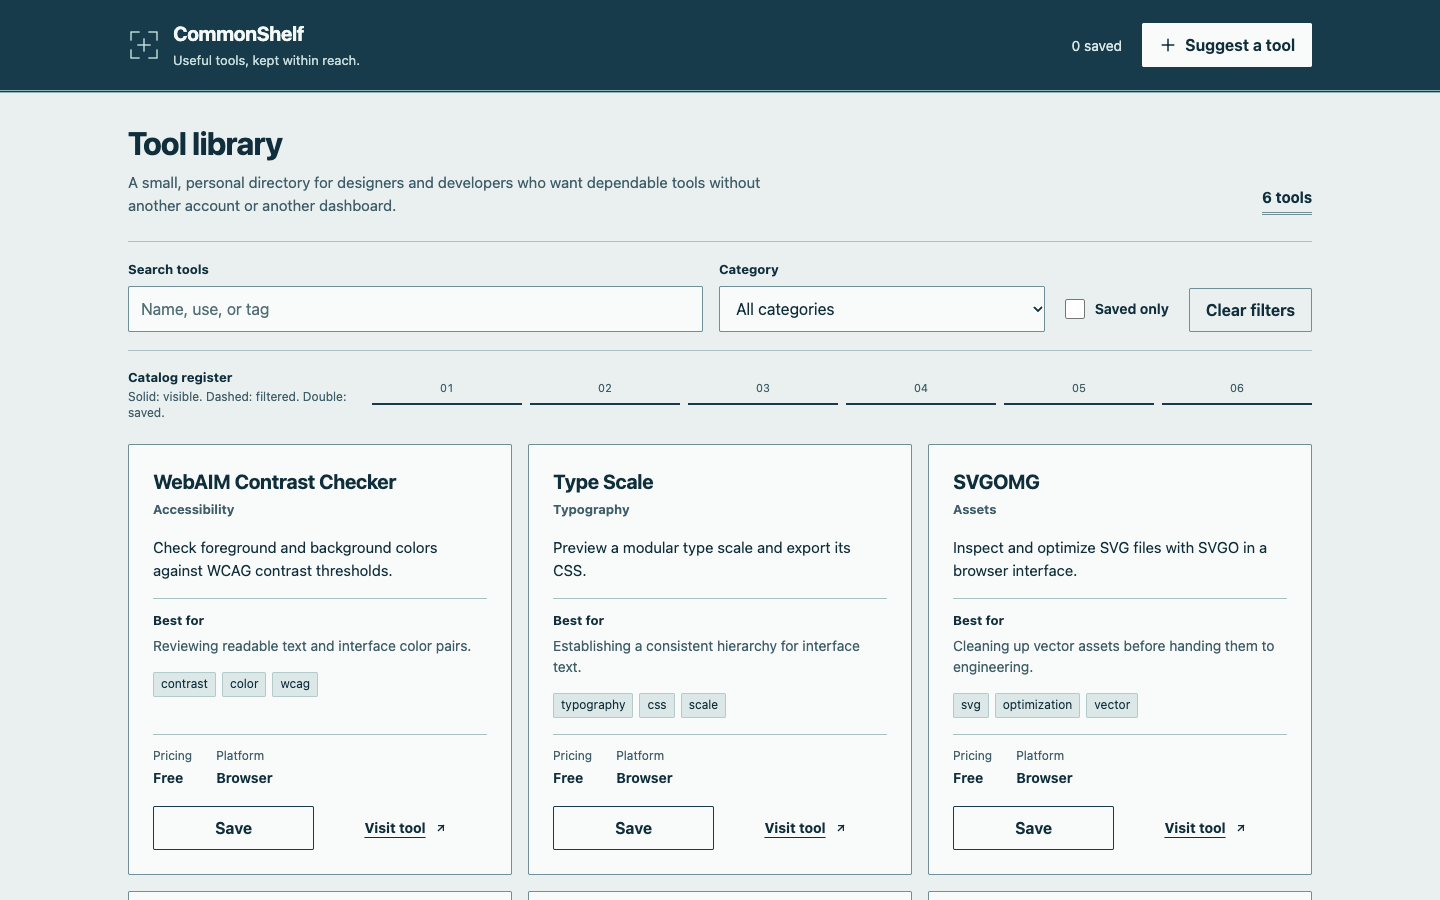
Skill 없음 대조군: 84.3, 완성된 인터페이스와 그대로 남긴 두 번의 기능 실패
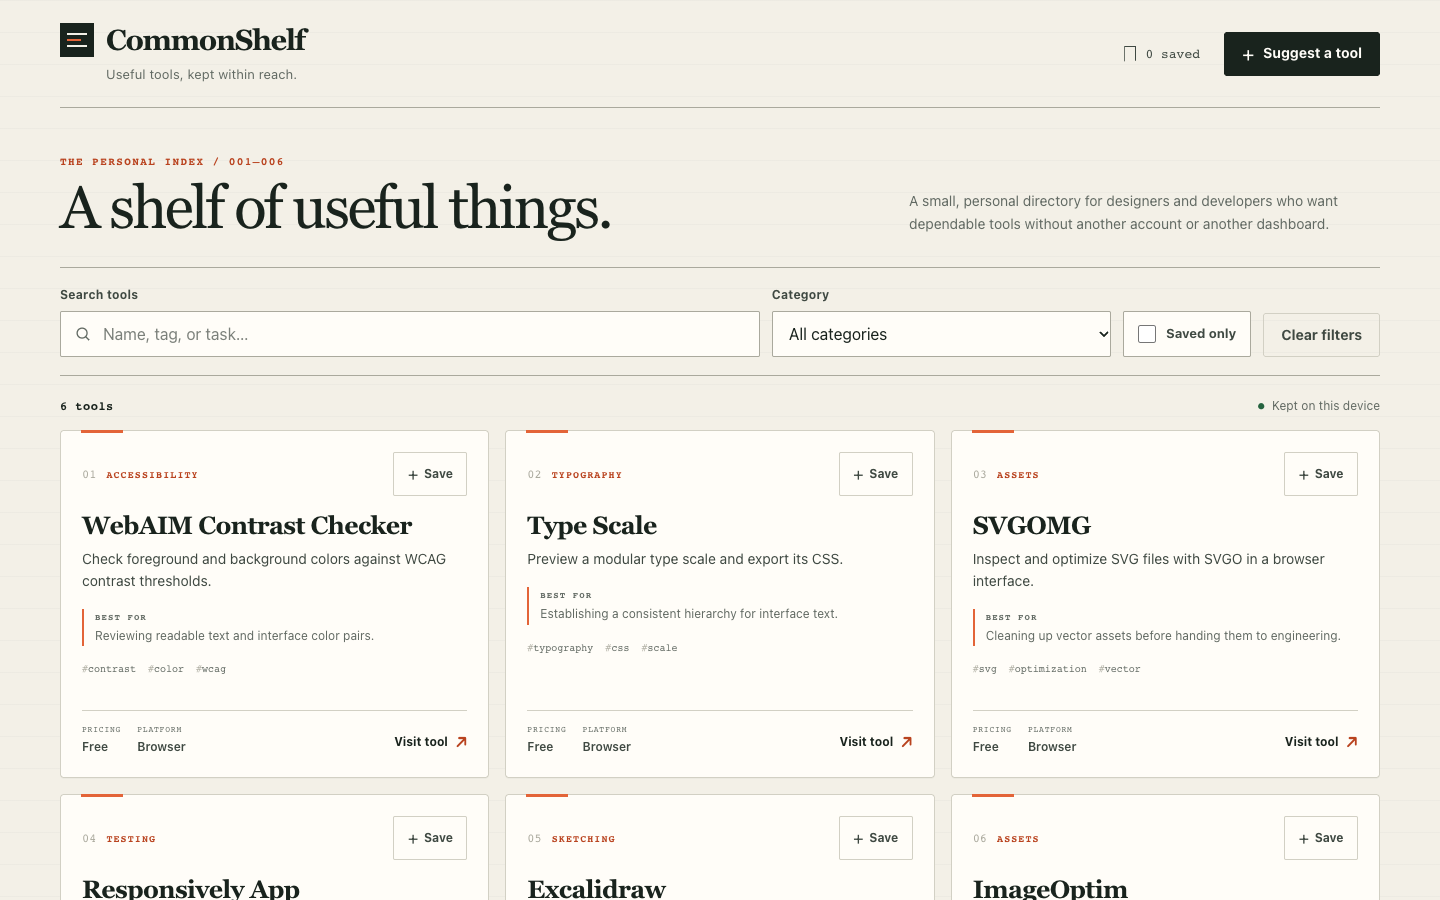
시각 점수는 83, 86, 84입니다. 따뜻한 종이 톤, 번호, 인덱스 선으로 일관된 도구 디렉터리를 만들었고 데스크톱 3열과 모바일 1열 레이아웃도 대체로 명확합니다. 저장과 빈 결과도 대체로 색에만 의존하지 않았습니다. 기반 모델만으로도 완성된 인터페이스를 만들 수 있으므로 대조군을 0점으로 가정하지 말고 구체적으로 비교해야 합니다.
run-1과 run-3은 interaction-and-persistence의 Toast 정확한 텍스트 단언에서 실패했습니다. 예상은 순수 텍스트 “Suggestion saved.”였지만 실제로는 체크 표시와 공백이 추가되어 있었습니다. run-3의 체크 표시는 HTML에서 aria-hidden이므로 제안 저장이나 영속성 전체가 실패했다고 단정할 수는 없습니다. 그러나 미리 정한 계약에 따라 두 실행은 모두 5/6로 failed이며 실패한 단언 이후의 같은 시나리오 단계는 검수된 것으로 계산하지 않습니다.
보조 텍스트가 여러 차례 너무 작거나 옅었습니다. run-3은 도구 번호와 플레이스홀더가 부분 색상 계산에서 대비가 부족했고 모바일 오류 대화 상자 하단 작업의 위쪽 가장자리만 처음에 보였습니다. run-1은 소개와 필터가 모바일 첫 화면의 대부분을 차지했습니다.
부록 | Oil UI 0.24.2 최적화 후보: 한 번의 후속 시험
이 부록은 Oil UI 0.24.2 독립 최적화 후보의 후속 재시험 한 번을 기록하며 환경은 Kimi AgentSwarm + kimi-1021-preview로 동일합니다. 후보는 공식 새 버전이 아니며 원래 15회 표본에 속하지 않으며 원래 결과를 수정하거나 대체하지 않습니다. 한 번의 시험으로 일반적인 향상을 증명할 수는 없습니다.
독립 기능 검수는 6/6, 확장 연속 상호작용 검사는 2/2를 통과했고 11개 연속 확인 지점을 다뤘습니다. 두 독립 블라인드 리뷰어는 각각 89점과 90점을 부여해 평균은 179/2 = 89.5입니다. 리뷰어는 Playwright를 다시 실행하지 않았고 기능과 시각 증거를 분리해 기록했습니다. 직접 증거는 Chromium의 1440×900 및 390×844에 한정되며 실제 모바일 기기, 모든 중단점, 다른 브라우저, 전체 접근성 감사는 포함하지 않습니다.
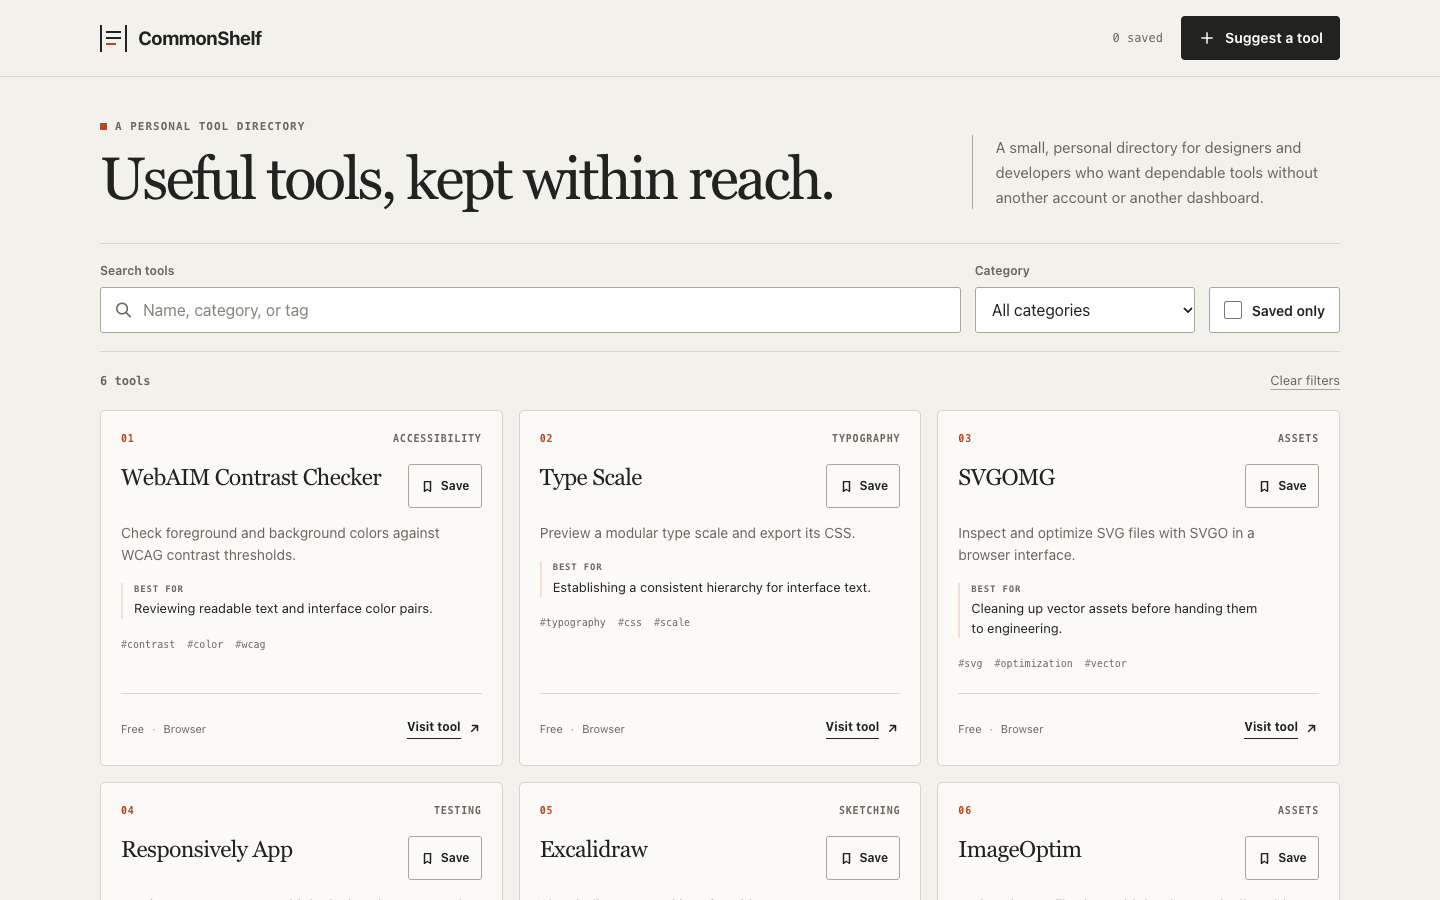
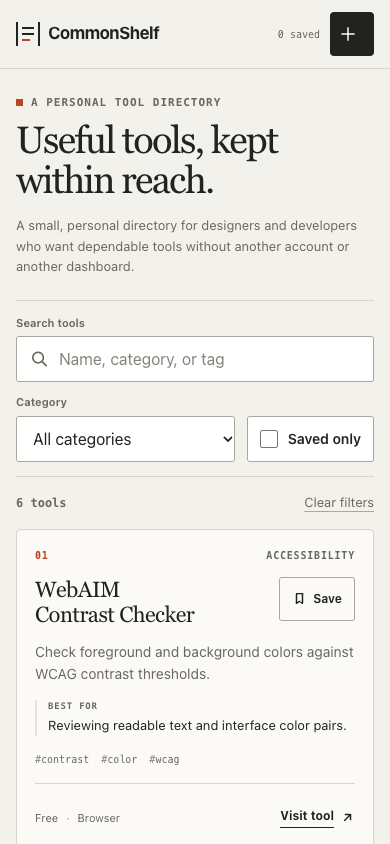
- DOM과 모션: 연속 사용과 복원에서 전체 목록 재생이 관찰되지 않음
- 11개 연속 확인 지점에서 유지된 카드는 모두 sameOriginalNode=true로 기록되어 카드 전체를 매번 다시 만들지 않았습니다. 카드와 제안의 animationstart 기록은 비어 있고 두 리뷰어도 연속 상호작용 동영상을 확인했습니다. 저장 버튼에만 적용된 CSS Transition은 목록 재생이 아니라 별도로 기록했습니다. 새로고침 후에도 복원된 카드 여섯 장과 제안은 모두 cssAnimations=0이고 restoreAnimationStarts는 비어 있으며 저장 상태와 제안 내용이 복원되었습니다.
- 모바일 작업과 시각 위계
- 오류 네 항목을 표시한 390×844 뷰포트에서 취소와 제출 버튼은 모두 높이 48px, 하단 가장자리 819px로 뷰포트 안에 있었습니다. 두 작업 모두 trusted 터치 클릭으로 수행했고 수정된 제출 내용은 새로고침 후에도 유지되었습니다. 두 블라인드 리뷰어 모두 대화 상자와 오류 요약에 굵은 상단 강조 막대가 없음을 확인했고 오류와 대화 상자의 위계는 명확했습니다.
- 이전 오류, 작은 텍스트, 플레이스홀더 대비는 여전히 개선 필요
- 필드를 수정한 뒤 다음 제출 전까지 이전 오류 요약과 필드별 오류가 계속 표시되었습니다. 이는 제출 시점 검증과 일치하므로 기능 실패는 아니지만 피드백이 늦어집니다. 일부 보조 텍스트는 여전히 9–11px이고 리뷰어 A가 측정한 입력 플레이스홀더 대비는 약 3.76:1로 일반 텍스트 기준 4.5:1에 못 미쳤습니다. 이는 일부만 측정한 것으로 전체 대비 감사는 아닙니다.
한계: 이 증거가 설명하는 것과 설명하지 않는 것
이번 테스트는 영어로 작성된 정적 CommonShelf 브리프 하나와 모델 하나를 사용하고 조건당 최종 표본 세 개를 다룹니다. 여섯 차원 규칙에도 판단이 포함되며 한 번의 리뷰는 하나의 익명 자료 묶음에 대응합니다. 대규모 사용자 연구나 통계적 유의성 실험이 아니므로 과제, 콘텐츠 언어, 프레임워크, 모델이 바뀌면 결과도 달라질 수 있습니다.
기능 검수는 미리 정의한 여섯 Chromium 시나리오 그룹에 한정되며 완전한 제품 감사는 아닙니다. 일반 태블릿은 스타일시트 증거만 있고 전용 스크린샷은 없습니다. Safari, Firefox, 실제 터치 기기, 스크린 리더, 200% 확대, 전체 WCAG 검사는 완료하지 않았습니다. 정적 스크린샷으로 연속 애니메이션의 리듬을 모두 보여 줄 수는 없으므로 Oil UI run-3의 투명 프레임은 피드백 문제를 증명하지만 애니메이션이 끝난 뒤 안정된 화면의 품질을 설명하지는 못합니다.
공개 데모에는 생성 후 실제 페이지와 기능 실패를 그대로 유지했습니다. 기술적 중단과 프로토콜에 따른 복구는 후보의 기능 실패로 계산하지 않았고 소요 시간 비교에도 사용하지 않았습니다. 이는 생성 후 독립 검수와는 다른 증거입니다.
재현: 증거를 확인한 다음 직접 비교 실행
이 글의 내용은 데모 15개, 초기 이미지 20장, results.json으로 확인할 수 있습니다. 재실행할 때는 같은 브리프, 고정 버전, 모델을 유지하고 매번 새 Agent를 사용하며 세 결과를 모두 유지하고 생성 후 독립 검수를 실행하세요. 공개 콘텐츠 파일은 데모에서 제공하는 사본과 바이트 단위로 동일합니다. 아래 프롬프트는 원래 고정된 과제 파일이 아니라 간소화한 재실행 브리프입니다.
오픈소스 설치 명령은 실행 시점에 해석되는 버전을 설치하므로 0.24.2를 보장하지 않습니다. 엄격하게 비교하려면 실제 설치 버전을 기록하고 표의 고정 커밋을 사용하세요. 새 버전은 이번 숫자를 덮어쓰지 말고 새로운 테스트로 다뤄야 합니다.
오픈소스 Oil UI를 설치하고 버전 기록
먼저 자신의 과제에서 오픈소스 Skill을 사용해 보세요. 이번 비교 테스트에는 Oil UI Pro를 사용하지 않았습니다.
npx skills add oil-oil/oil-ui조건당 세 번의 독립 생성 실행
모델과 콘텐츠 데이터를 고정하고 매번 새 Agent와 워크스페이스에서 시작하며 하나의 방향만 전달하세요. 다른 실행의 페이지를 읽거나 수정하지 말고 약한 결과를 교체하지도 마세요.
기능 검수와 익명 시각 리뷰 분리
1440×900과 390×844에서 여섯 시나리오 그룹을 확인하고 모든 통과와 실패를 유지하세요. 시각 리뷰에서는 조건 정보를 숨기고 같은 여섯 차원으로 점수를 매기며 평균뿐 아니라 각 결과를 공개하세요.
Build one complete CommonShelf static web app with plain HTML, CSS and JavaScript. Use the supplied content.json unchanged. Make one coherent direction without asking for a selection. At 1440×900 and 390×844, the first viewport must help a visitor find, understand and save tools. Implement combined search, category and saved-only filters; local-storage saves; a validated suggestion dialog; exactly three keyboard-operable FAQ items; actionable content-unavailable and storage-unavailable states; visible focus; and reduced motion. Keep suggestions outside the curated tool grid. Make no external requests except user-activated official links. Do not import another run or replace a weak result. Preserve every failure, then independently verify the actual page and review anonymized screenshots and runtime files.유사한 재실행을 위한 간소화 브리프입니다. 엄격한 재현에는 위의 고정 버전, 여섯 검수 시나리오 그룹, 동일한 채점 규칙도 필요합니다.
작동하는 갤러리 사례와 프롬프트
1440px 또는 390px의 실제 데모를 열어 모델과 프롬프트가 최종 인터페이스를 어떻게 형성했는지 살펴 보세요.
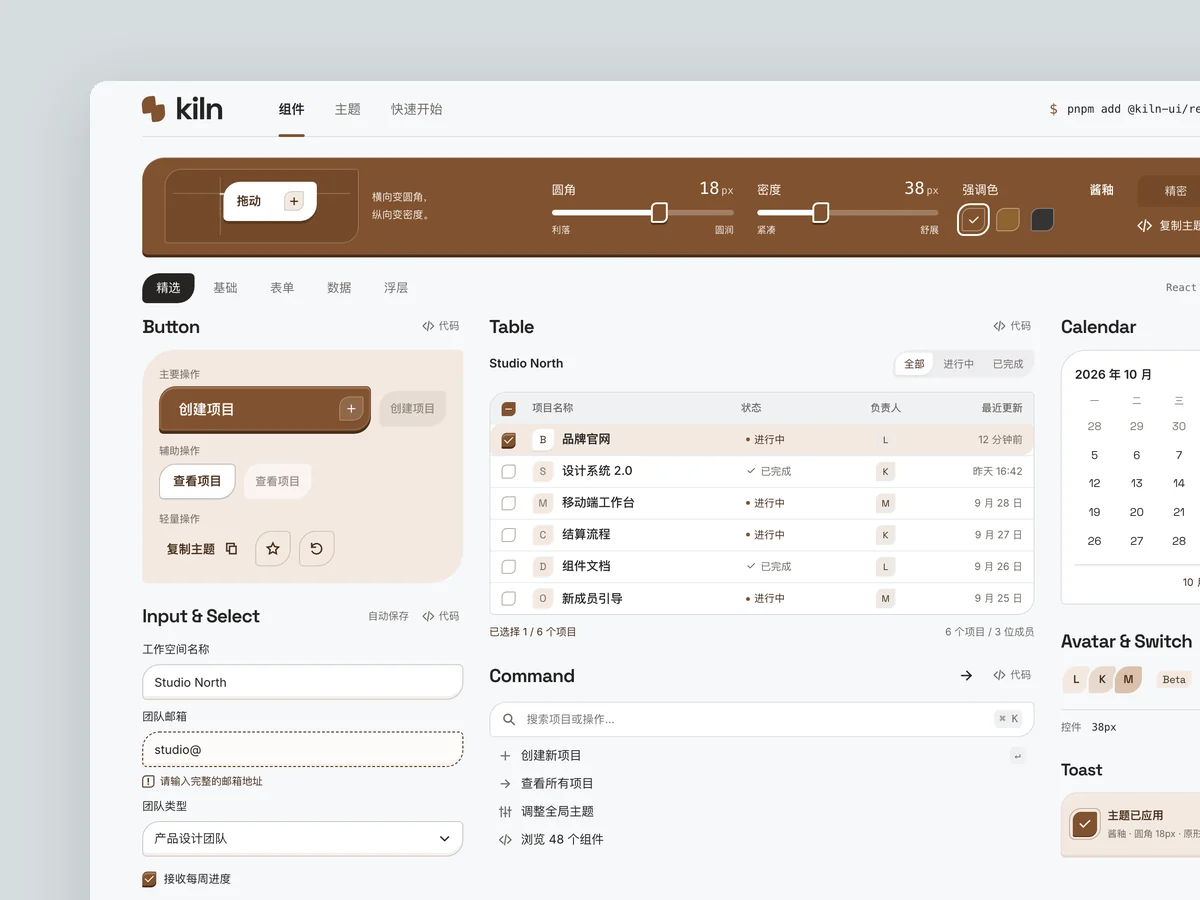
Kiln
컴포넌트 라이브러리 웹사이트
제품: 버튼, 입력, 드롭다운, 명령 팔레트, 다이얼로그, 툴팁, 표, 날짜 선택기를 포함한 40개 이상의 컴포넌트를 갖춘 React 개발자용 오픈소스 컴포넌트 라이브러리 Kiln입니다. 테마 커스터마이즈를 지원합니다. 웹사이트 홈페이지를 만들고 필요하면 컴포넌트 상세 페이지도 추가하세요. - 스크린샷 대신 실제 상호작용형 컴포넌트를 홈페이지에 직접 보여 주세요. “컴포넌트 월”에는 사용자가 클릭하고 입력하고 전환할 수 있는 작동하는 컴포넌트가 있어야 합니다. - 선도적인 개발자 도구 웹사이트의 정밀함과 절제를 참고하세요. 대부분 흑백으로 구성하고 강조색은 최대 하나만 사용하며 엄격한 그리드와 코드 및 숫자의 모노스페이스 활자를 적용하세요. - 테마 컨트롤러를 기억에 남게 만드세요. 반경, 밀도, 강조색 컨트롤을 드래그하면 페이지의 모든 컴포넌트가 즉시 바뀌어야 합니다. - 복사 가능한 설치 명령, 코드 스니펫, 컴포넌트 카테고리 네비게이션, GitHub 스타와 주간 다운로드처럼 지나치게 딱 떨어지지 않는 현실적인 사용 수치를 포함하세요.
작품과 프롬프트 살펴 보기 →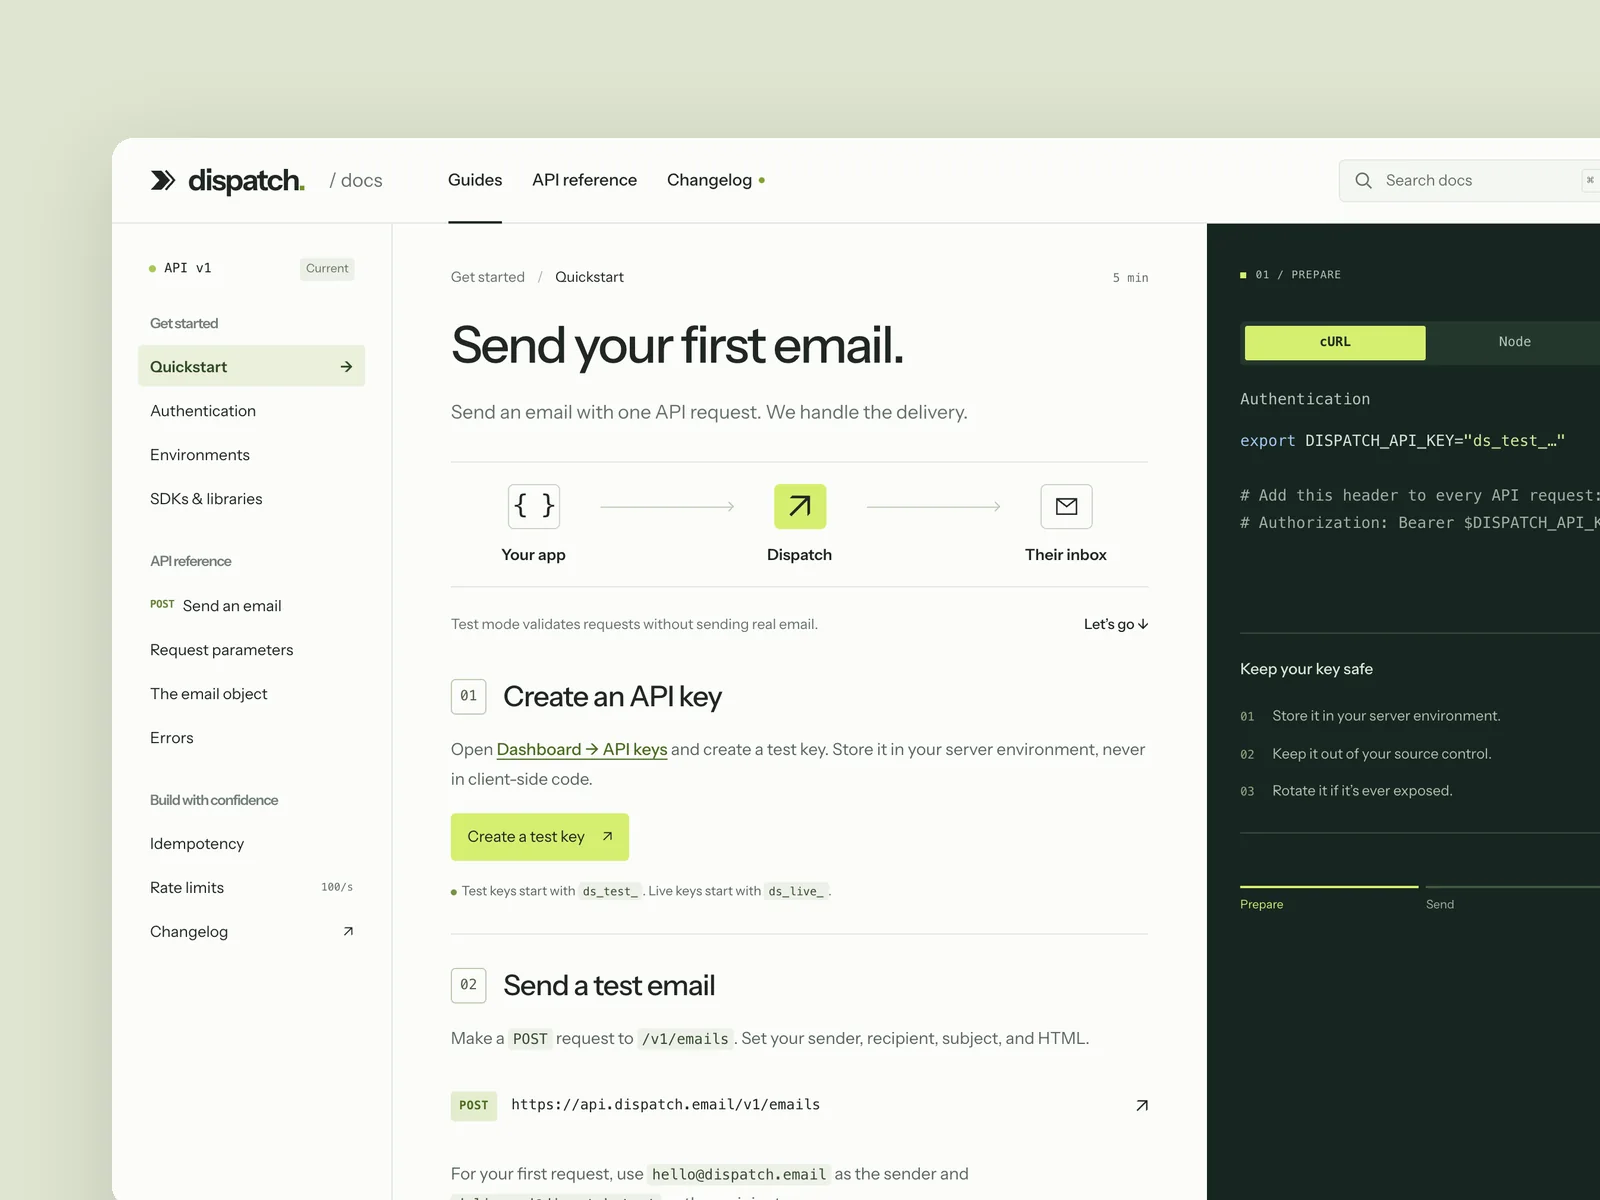
Dispatch
개발자 API 문서
결제 또는 메시징 API 회사의 개발자 문서 사이트를 만드세요(1440×900에서 시작해 너비 390까지 반응형 대응). 왼쪽에는 네비게이션, 중앙에는 문서, 오른쪽에는 언어를 전환할 수 있는 코드 샘플(cURL, Node, Python)을 배치합니다. 빠른 시작, 한 엔드포인트의 전체 레퍼런스(파라미터 표, 요청 및 응답 예시, 오류 코드), 검색을 포함하세요. 읽는 동안 코드 샘플이 현재 섹션을 따라가고 선택한 언어가 사이트 전체에서 기억되어야 합니다. 빠른 시작 페이지, 엔드포인트 레퍼런스 페이지, 검색이 열린 상태를 디자인하세요.
작품과 프롬프트 살펴 보기 →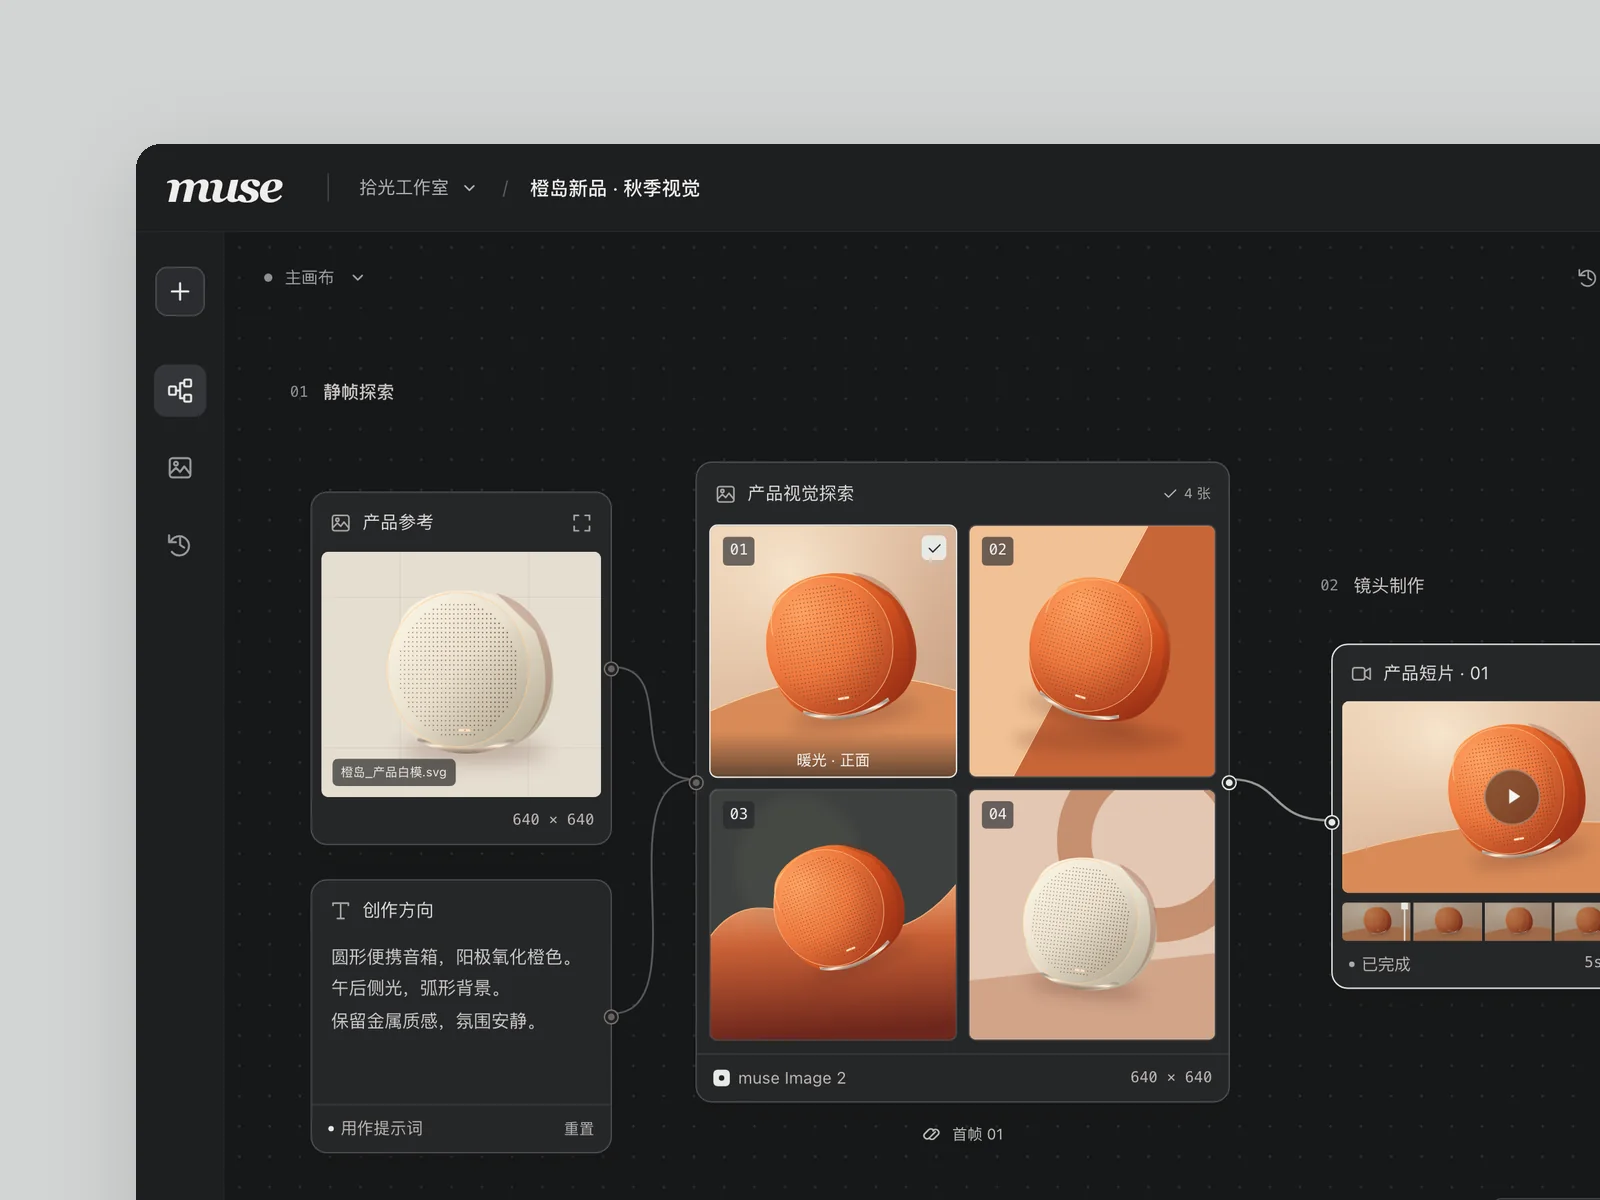
muse
AI 이미지 및 동영상 캔버스
디자이너와 크리에이티브 팀을 위한 AI 이미지 및 동영상 생성 도구를 만드세요. 모든 프롬프트, 참조 이미지, 생성 결과를 하나의 무한 캔버스에 배치하고 메인 작업 공간을 구현하세요.
작품과 프롬프트 살펴 보기 →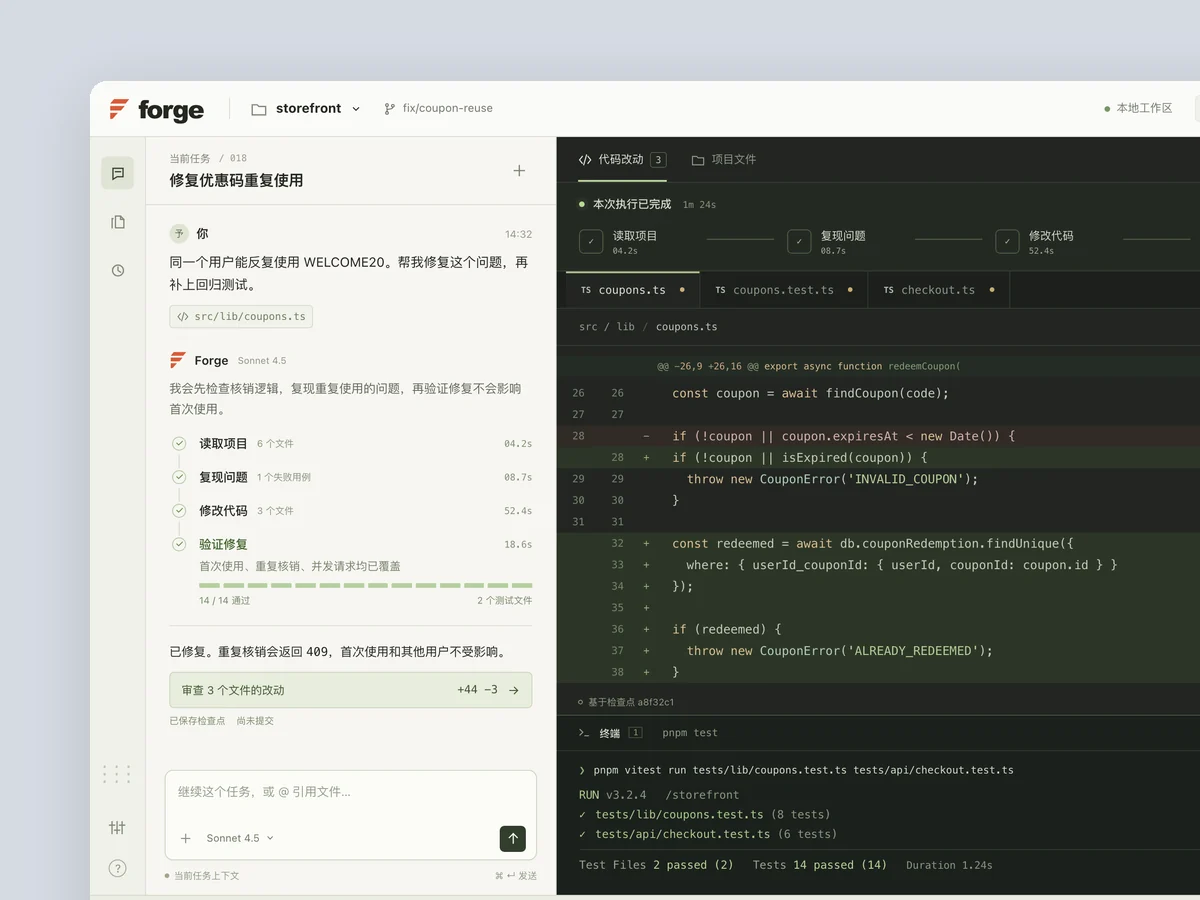
Forge
AI 코딩 어시스턴트
제품: 데스크톱 AI 코딩 어시스턴트 Forge입니다. 왼쪽에는 대화를, 오른쪽에는 편집 중인 코드와 터미널을 배치합니다. 사용자는 파일을 읽고 코드를 수정하고 테스트를 실행하는 과정을 단계별로 지켜볼 수 있습니다. 실제 프로젝트처럼 보이는 파일명, diff, 테스트 출력 등 현실적인 데이터로 메인 인터페이스를 만드세요(1440×900). AI의 작업이 보이고 기억에 남게 하세요. 단계가 하나씩 밝혀지고 diff 행이 점진적으로 나타나며 테스트가 빨간색에서 초록색으로 바뀌어야 합니다. 위험한 변경을 사용자가 확인하기를 기다리는 상태도 캡처하세요.
작품과 프롬프트 살펴 보기 →선택 참고: Oil UI Pro는 이번 비교 테스트에 포함되지 않았습니다
모든 Oil UI 결과는 오픈소스 0.24.2에서 나왔고 Pro는 생성, 검수, 채점에 사용되지 않았습니다. 먼저 데모를 살펴 보고 실패를 확인하며 오픈소스 Skill을 재실행하세요. 자신의 워크플로에 추가 방법이 필요할 때만 Pro를 별도로 고려하세요.
npx github:oil-oil/oil-cli install oil-ui-pro자주 묻는 질문
이 비교만으로 어떤 Skill을 설치해야 할지 결정할 수 있나요?
평균만으로 결정하지 말고 디렉터리 위계, 모바일 작업, 모션, 기능 실패, 소스 라이선스를 비교한 다음 우선순위에 맞는 데모를 열어 확인하세요.
Oil UI run-3은 모든 기능 시나리오를 통과했는데 왜 시각 점수가 83인가요?
검수는 지정된 동작이 작동함을 확인하고 시각 리뷰는 피드백도 살핍니다. 이 실행은 카드를 다시 만들 때마다 투명한 상태에서 시작하는 애니메이션을 재생해 검색, 저장, 제안 캡처에서 결과 영역이 거의 비어 보였습니다. 실제로 보이는 피드백 결함이므로 83점이지만 영구적인 데이터 손실을 증명하지는 않습니다.
Skill 없음 대조군의 두 번의 실패가 저장이 완전히 망가졌다는 뜻인가요?
아니요. 두 실행 모두 실제 텍스트에 체크 표시와 공백이 추가되어 Toast 정확한 텍스트 단언에 실패했습니다. 저장이나 영속성 전체 실패는 아니지만 미리 정한 계약을 충족하지 못했으므로 두 실행 모두 5/6로 failed입니다.
글의 숫자와 화면은 어떻게 확인할 수 있나요?
results.json에서 실행별 여섯 차원 점수, 총점, 기능 결과를 확인한 다음 각 후보의 데스크톱 초기 이미지 세 장, 모바일 이미지 한 장, 실제 데모 세 개를 여세요. 모바일 이미지는 모두 run-1에서 가져왔고 높은 점수로 교체하거나 폼 스크린샷을 대표 이미지로 사용하지 않았습니다.