
4 Skills de diseño de interfaces a prueba: 15 ejecuciones, un modelo y revisiones visuales anónimas
En Kimi AgentSwarm, utilizamos kimi-1021-preview para ejecutar el mismo brief del directorio de herramientas CommonShelf tres veces con cada una de cuatro versiones fijadas de Skills de diseño de interfaces y un control sin Skill: 15 ejecuciones en total. La validación funcional se superó en 13 y falló en dos, ambas en el control. Las medias visuales fueron Oil UI 87.0, frontend-design 88.0, UI UX Pro Max 86.7, Impeccable 88.0 y control sin Skill 84.3. Si estás eligiendo una Skill de diseño de interfaces y te importan la jerarquía del catálogo, las acciones móviles, el movimiento y la fiabilidad funcional, compara las demos y los detalles de los fallos; las conclusiones solo cubren este brief y este modelo.
Ideas clave
- Las cuatro versiones de las Skills se fijaron antes de la generación. Cada ejecución utilizó un agente nuevo en un espacio de trabajo nuevo y entregó una sola dirección; los resultados más débiles no se sustituyeron.
- Ambos fallos funcionales ocurrieron en aserciones de texto exacto del Toast en el control sin Skill; ninguno demuestra un fallo total de la persistencia.
- Oil UI run-3 superó 6/6 escenarios funcionales, pero la repetición de animaciones de tarjetas desde la transparencia dejó varias capturas de estado casi en blanco; su puntuación visual fue 83.
Tarea y versiones: un mismo brief de CommonShelf
CommonShelf es un directorio personal de herramientas sin flujo de cuenta. El brief proporciona seis registros fijos y exige implementar en HTML, CSS y JavaScript sin framework la búsqueda, los filtros por categoría y estado guardado, el guardado de herramientas, un formulario de sugerencias validado y un FAQ operable con teclado. Excepto cuando el usuario activa un enlace oficial, la página no realiza solicitudes externas durante su ejecución. Cada agente entrega una sola dirección, sin generar varias y elegir una.
Cada condición con Skill lee solo su SKILL.md asignado una vez; el control no lee ninguna. Las versiones se fijan antes de la generación, no se sustituyen por ediciones globales o de pago y las licencias se enumeran junto a las fuentes.
| Condición | Versión fijada | Licencia |
|---|---|---|
| Oil UI de código abierto | 0.24.2 (tag v0.24.2) | MIT |
| frontend-design | commit-dbd4588f9e1033efb41dad4bef2f7947c8993d44 | Apache-2.0 |
| UI UX Pro Max | 2.15.0 (tag v2.15.0) | MIT |
| Impeccable | 4.7.0 (tag skill-v4.7.0) | Apache-2.0 |
| Control sin Skill | Sin Skill ni versión upstream | Sin licencia upstream proporcionada |
Método: 15 generaciones independientes, con evidencias funcionales y visuales separadas
Cada generación utilizó un agente nuevo en Kimi AgentSwarm con kimi-1021-preview y thinking effort en max. Las condiciones podían ejecutarse en paralelo, pero run-1, run-2 y run-3 de una misma condición se realizaron secuencialmente. Cada ejecución comenzó en un espacio de trabajo nuevo, sin leer páginas, capturas o conversaciones de otras ni sustituir resultados más débiles. La programación y la recuperación afectan al tiempo transcurrido, por lo que no se comparó.
Después de la generación, un ejecutor independiente de Playwright 1.64.1 comprobó seis grupos de escenarios en Chromium: base de escritorio, base móvil, interacción y persistencia, contenido no disponible, almacenamiento no disponible y movimiento reducido, a 1440×900 y 390×844. La validación no devolvió correcciones al artefacto generado y las puntuaciones visuales no se trataron como aprobaciones funcionales.
La revisión visual utilizó 15 paquetes anonimizados, ocultando las condiciones y el proceso de generación, pero conservando archivos de ejecución, capturas y estados de validación. Cada paquete recibió una revisión. Las puntuaciones de seis dimensiones se sumaron para cada ejecución y después se calcularon las medias de las tres; las dimensiones suman 100, sin ponderación adicional ni selección de una ejecución con puntuación alta para representar al grupo.
| Dimensión | Máximo |
|---|---|
| Jerarquía visual y legibilidad | 20 |
| Adecuación al producto y originalidad | 20 |
| Comportamiento adaptable | 15 |
| Interacción y respuesta a los estados | 20 |
| Accesibilidad | 15 |
| Detalle y movimiento | 10 |
Resultados: puntuación y resultado funcional de cada ejecución
Las 15 generaciones y las revisiones visuales anónimas se completaron; la validación funcional se superó en 13 ejecuciones y falló en dos. Las medias dividen entre tres la suma de las tres ejecuciones y se muestran con un decimal: UI UX Pro Max es 260/3 y el control sin Skill 253/3. El JSON público contiene cada puntuación de las seis dimensiones, el resultado funcional y la URL pública de los recursos.
| Condición | run-1 | run-2 | run-3 | Suma de tres ejecuciones | Media | Validación funcional |
|---|---|---|---|---|---|---|
| Oil UI de código abierto | 88 · aprobada | 90 · aprobada | 83 · aprobada | 261/300 | 87.0 | 3/3 aprobadas |
| frontend-design | 87 · aprobada | 87 · aprobada | 90 · aprobada | 264/300 | 88.0 | 3/3 aprobadas |
| UI UX Pro Max | 86 · aprobada | 88 · aprobada | 86 · aprobada | 260/300 | 86.7 | 3/3 aprobadas |
| Impeccable | 88 · aprobada | 87 · aprobada | 89 · aprobada | 264/300 | 88.0 | 3/3 aprobadas |
| Control sin Skill | 83 · fallida | 86 · aprobada | 84 · fallida | 253/300 | 84.3 | 1/3 aprobada, 2 fallidas |
Oil UI de código abierto 0.24.2: 87.0, con una pérdida de puntos en run-3 por la transparencia repetida
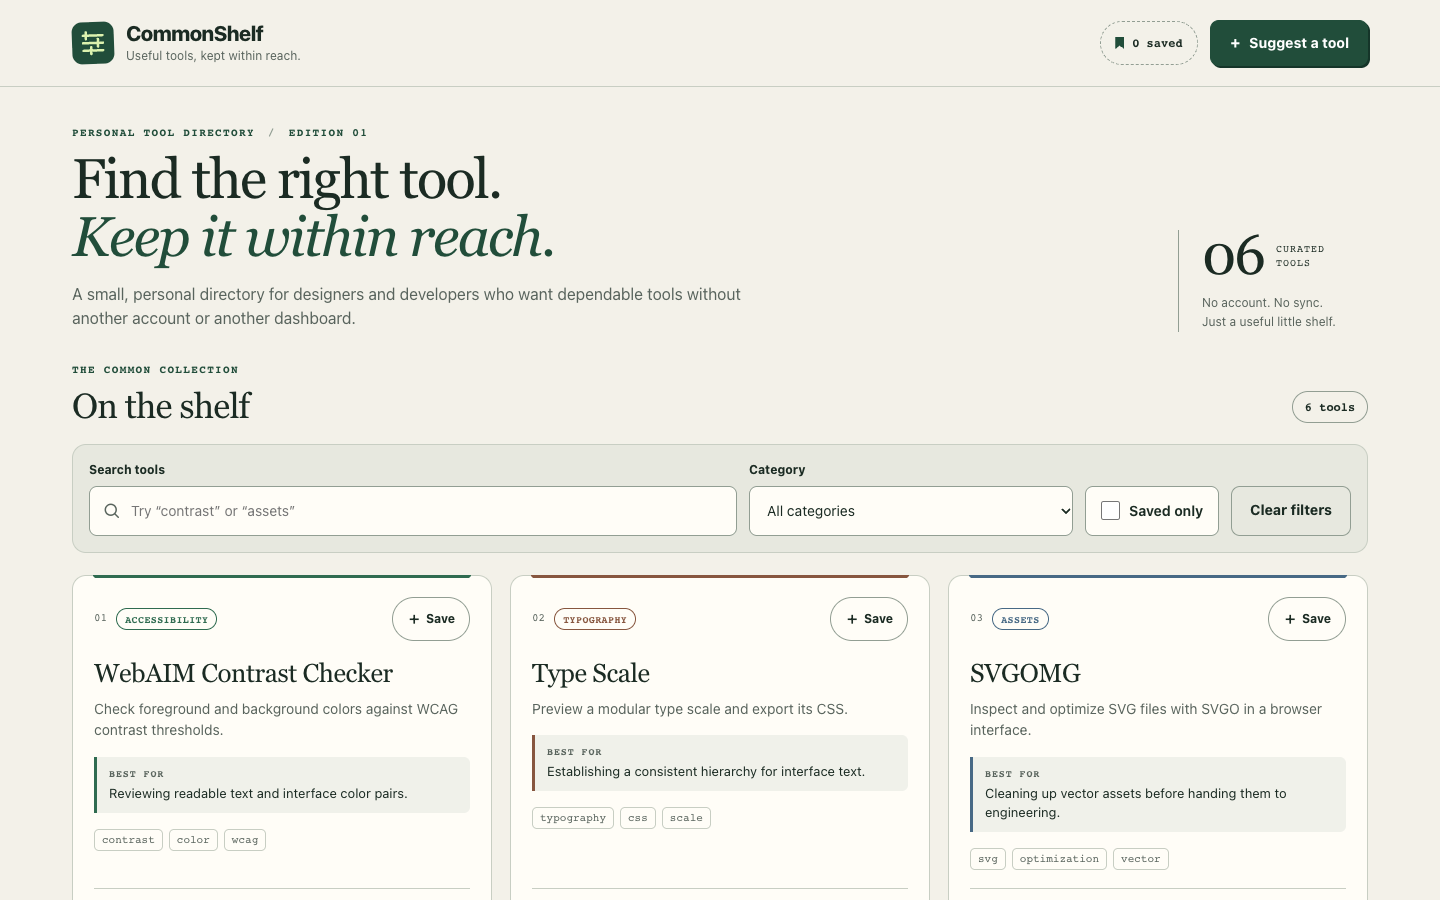
Las puntuaciones visuales fueron 88, 90 y 83, con 6/6 escenarios funcionales superados cada vez. Las tres versiones centran la búsqueda, los filtros y las seis herramientas, con un orden estable de la información. Guardar actualiza el texto, los iconos o la forma, el relleno y el recuento; los resultados vacíos permiten restablecer, los fallos de carga permiten reintentar y los errores del formulario incluyen un resumen e indicaciones de recuperación por campo.
En run-1, el formulario móvil largo requiere desplazarse para mostrar toda la fila de acciones tras aparecer los errores, y varias capturas registraron las tarjetas posteriores casi transparentes durante la entrada. Run-2 desarrolló un sistema más coherente de líneas de índice compartidas y pestañas guardadas, pero su efecto de entrada de 420ms produjo fotogramas blanqueados en las capturas de búsqueda y actualización de sugerencias. El texto auxiliar monoespaciado pequeño también dificultó la lectura de páginas largas.
En run-3, cada reconstrucción mediante renderTools() reprodujo una animación card-in de 180ms desde opacity: 0. Una captura de búsqueda mostraba “1 tool” sin ninguna tarjeta visible, mientras que las capturas móviles de búsqueda, actualización de guardados y actualización de sugerencias mostraban tarjetas casi transparentes. Aunque la validación funcional se superó, ocultar repetidamente el contenido principal durante el filtrado habitual interrumpió la respuesta, por lo que esta ejecución obtuvo 83 puntos. Los fotogramas no demuestran una pérdida permanente de datos.
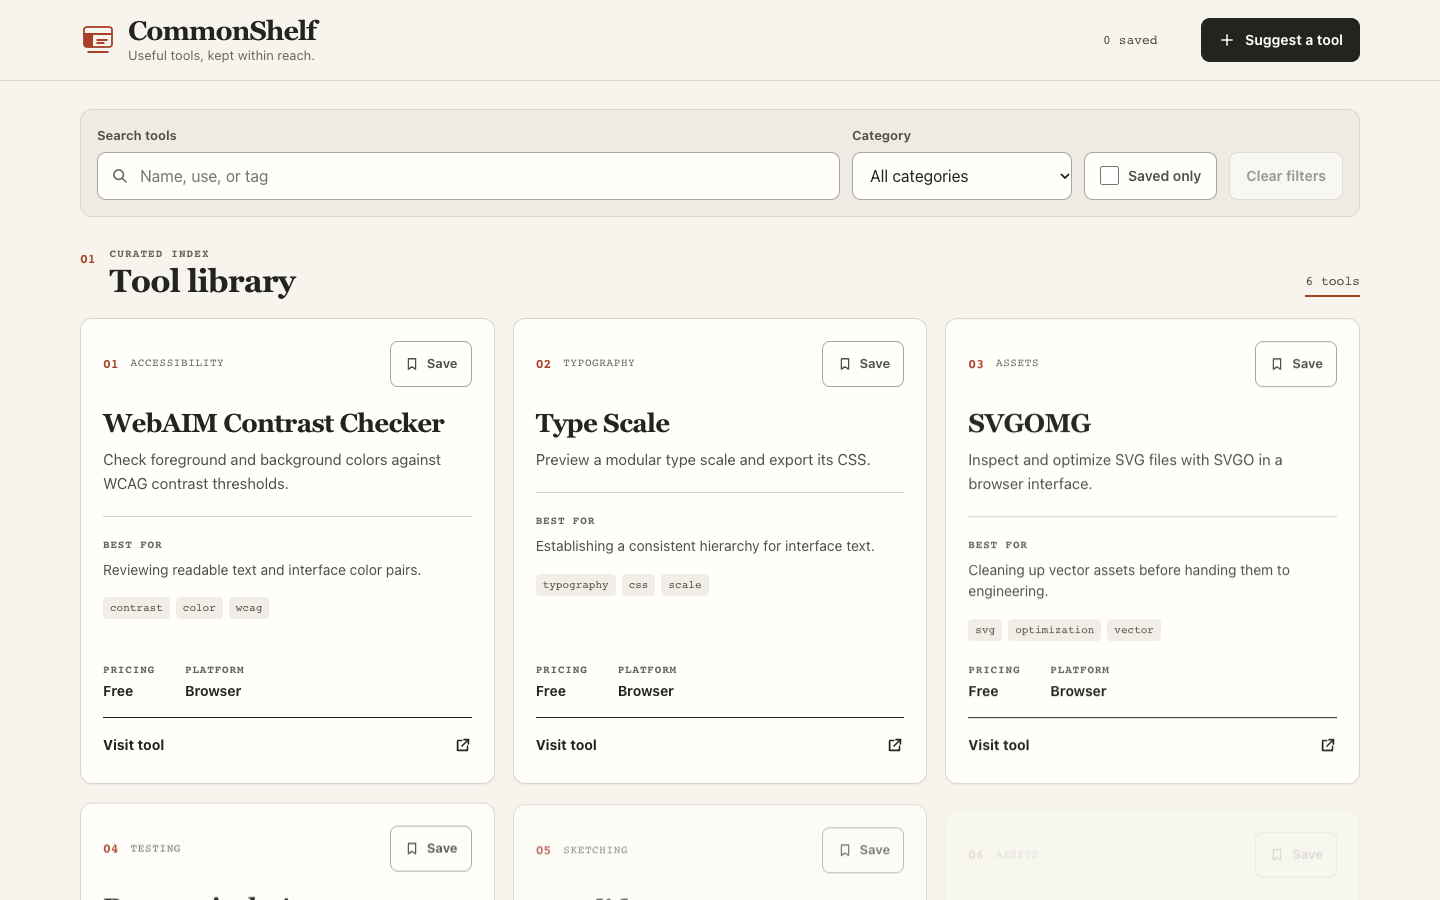
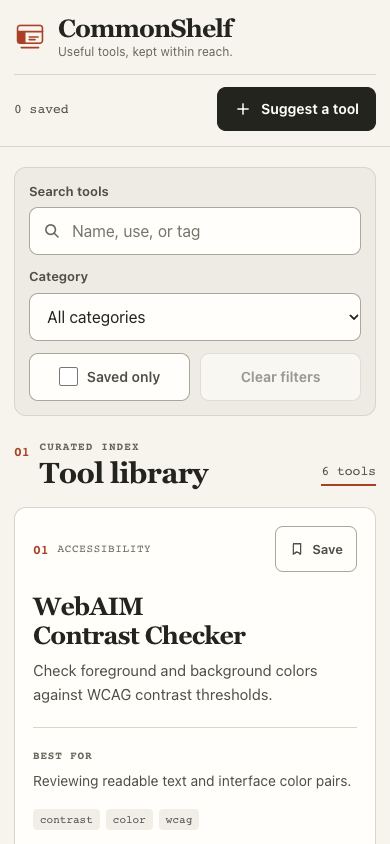
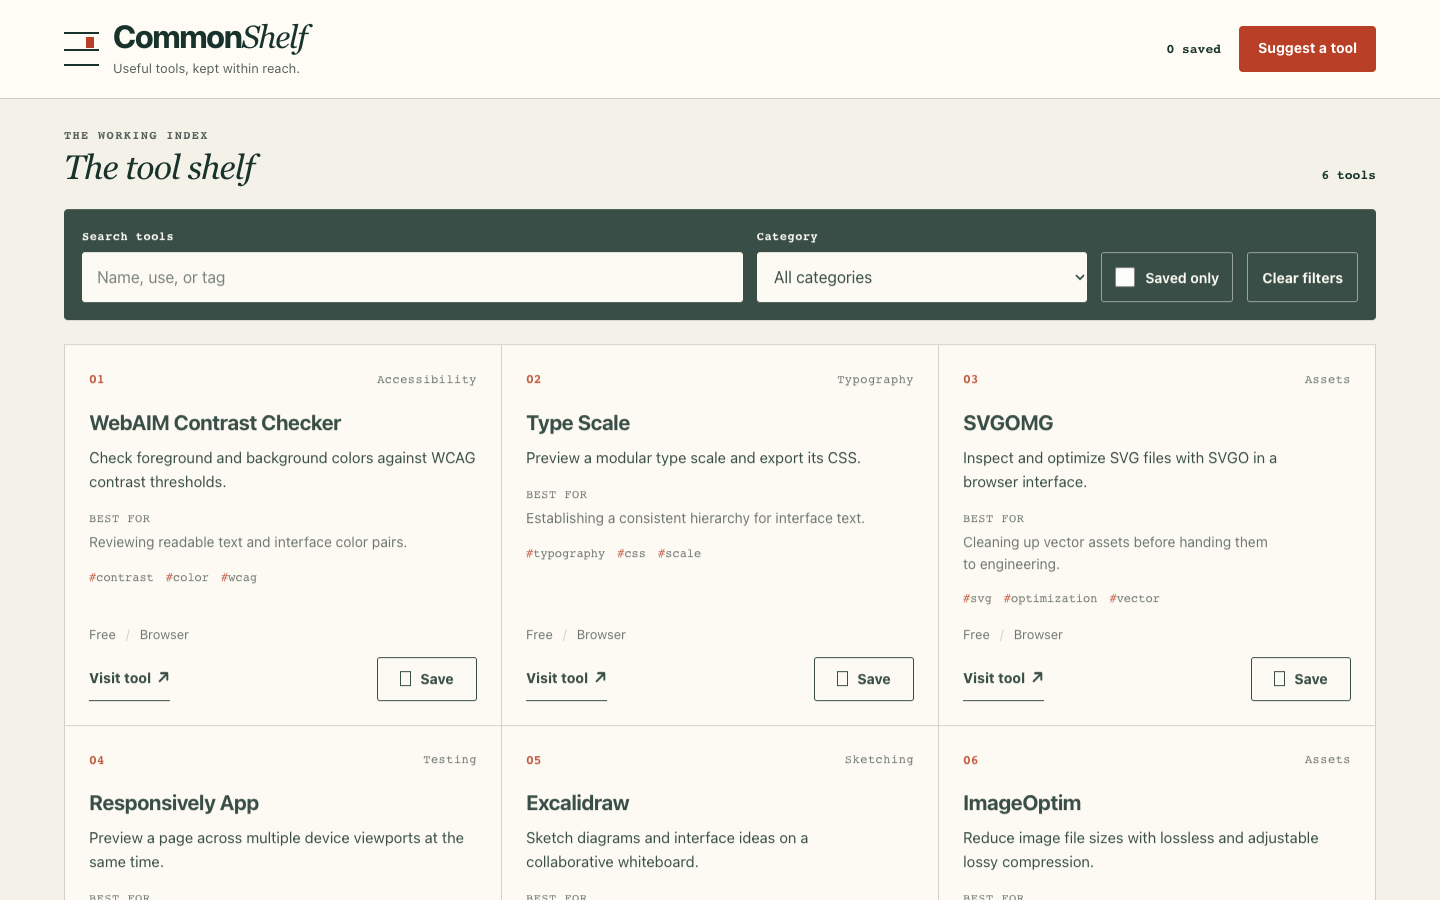
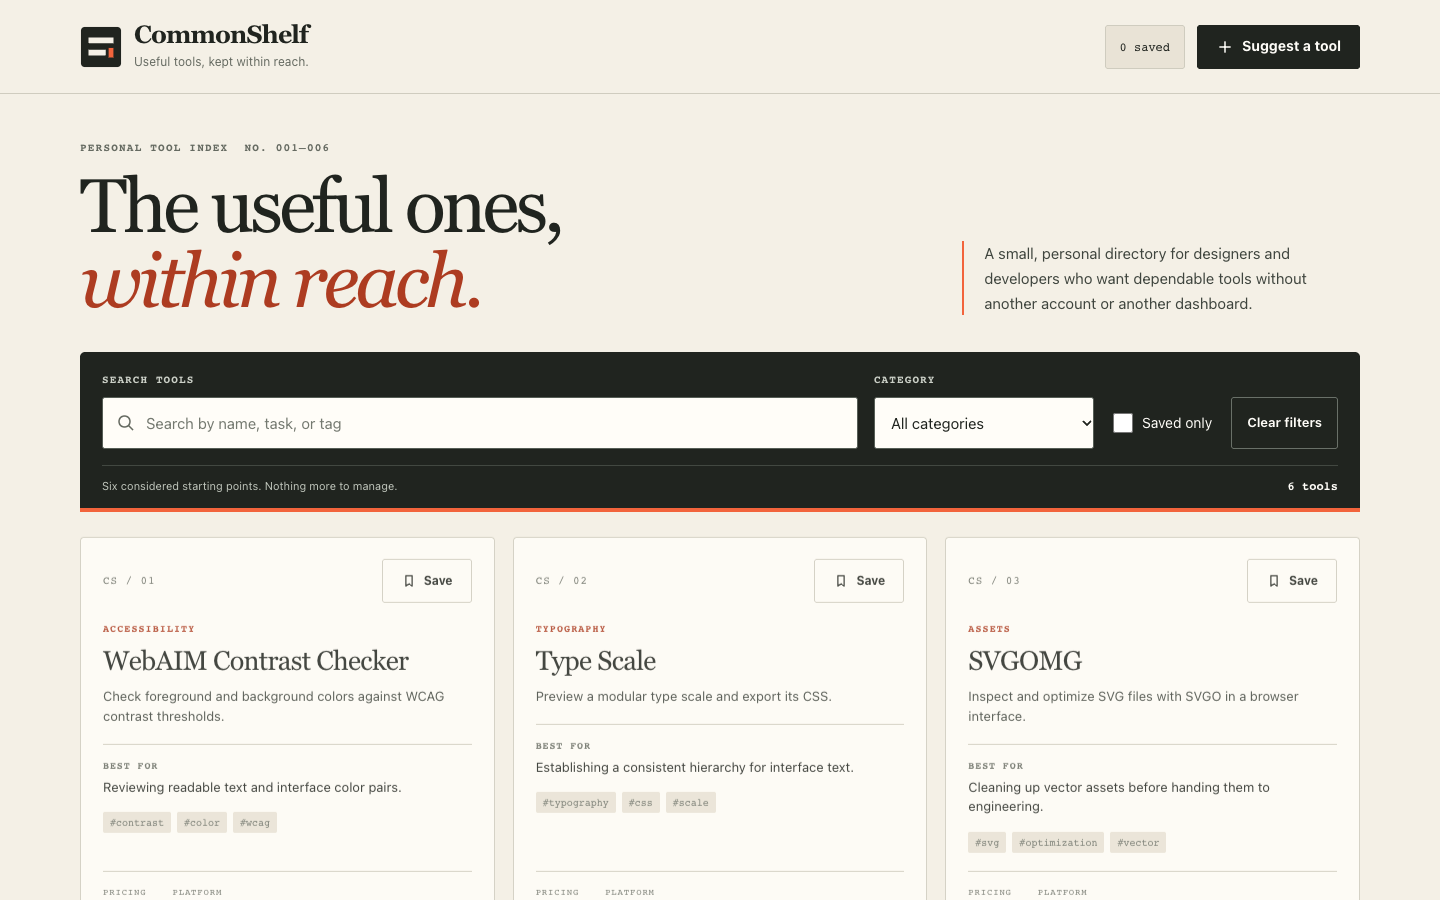
- Abrir la demo run-1 de Oil UI de código abierto · Visual 88/100 · validación funcional 6/6: aprobada
- Abrir la demo run-2 de Oil UI de código abierto · Visual 90/100 · validación funcional 6/6: aprobada
- Abrir la demo run-3 de Oil UI de código abierto · Visual 83/100 · validación funcional 6/6: aprobada
frontend-design: 88.0, un lenguaje coherente de cajón de trabajo con énfasis repetidos
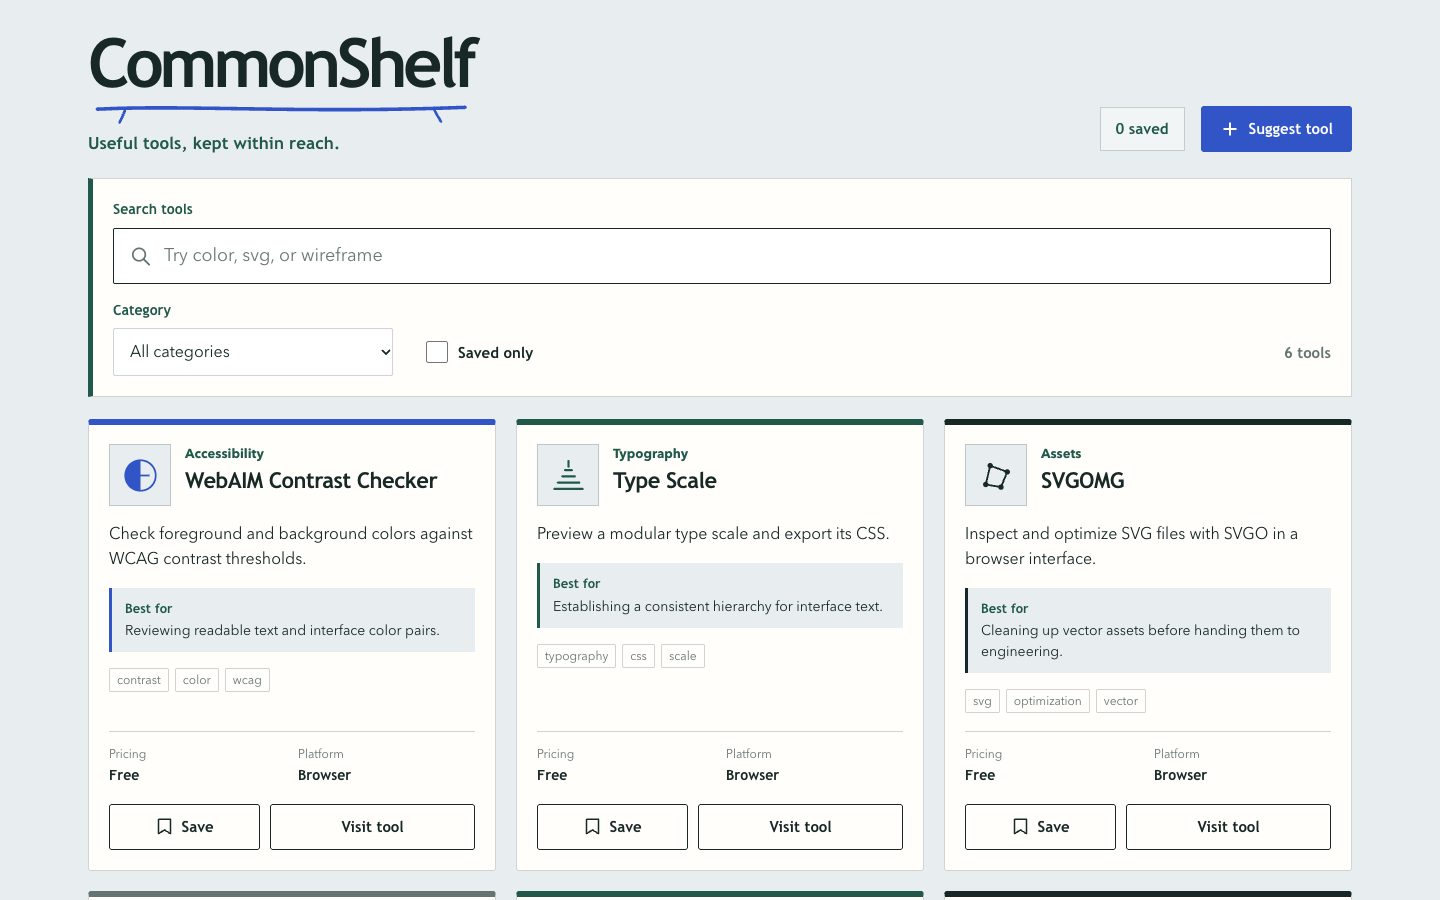
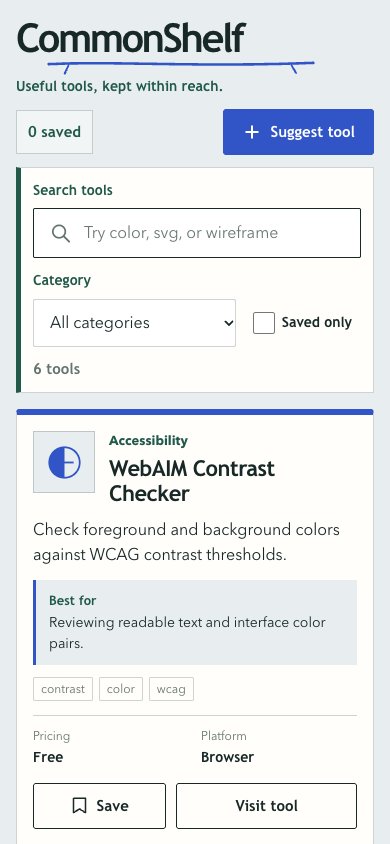
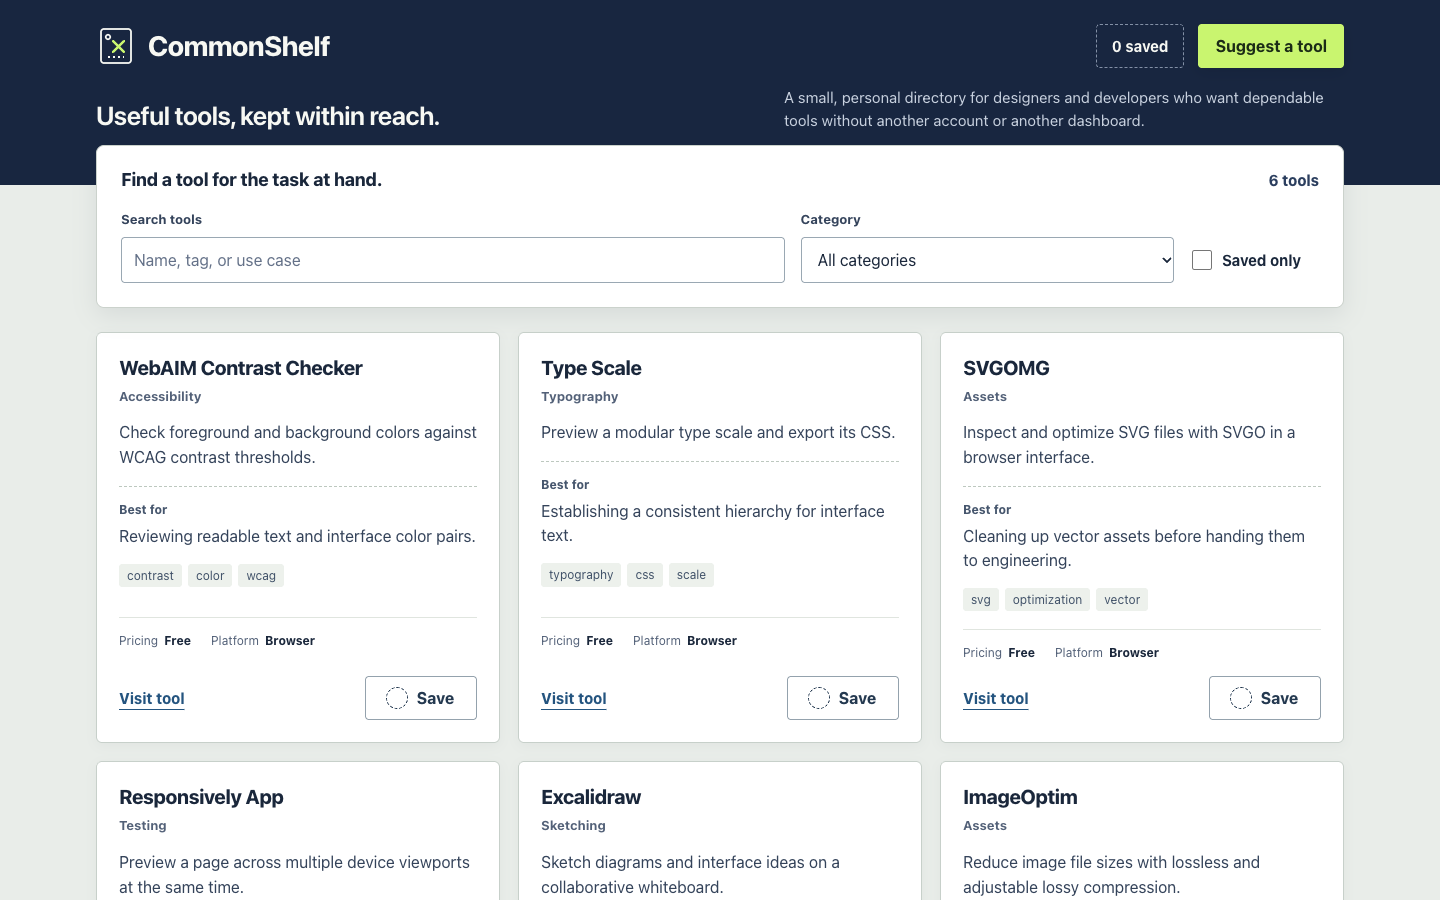
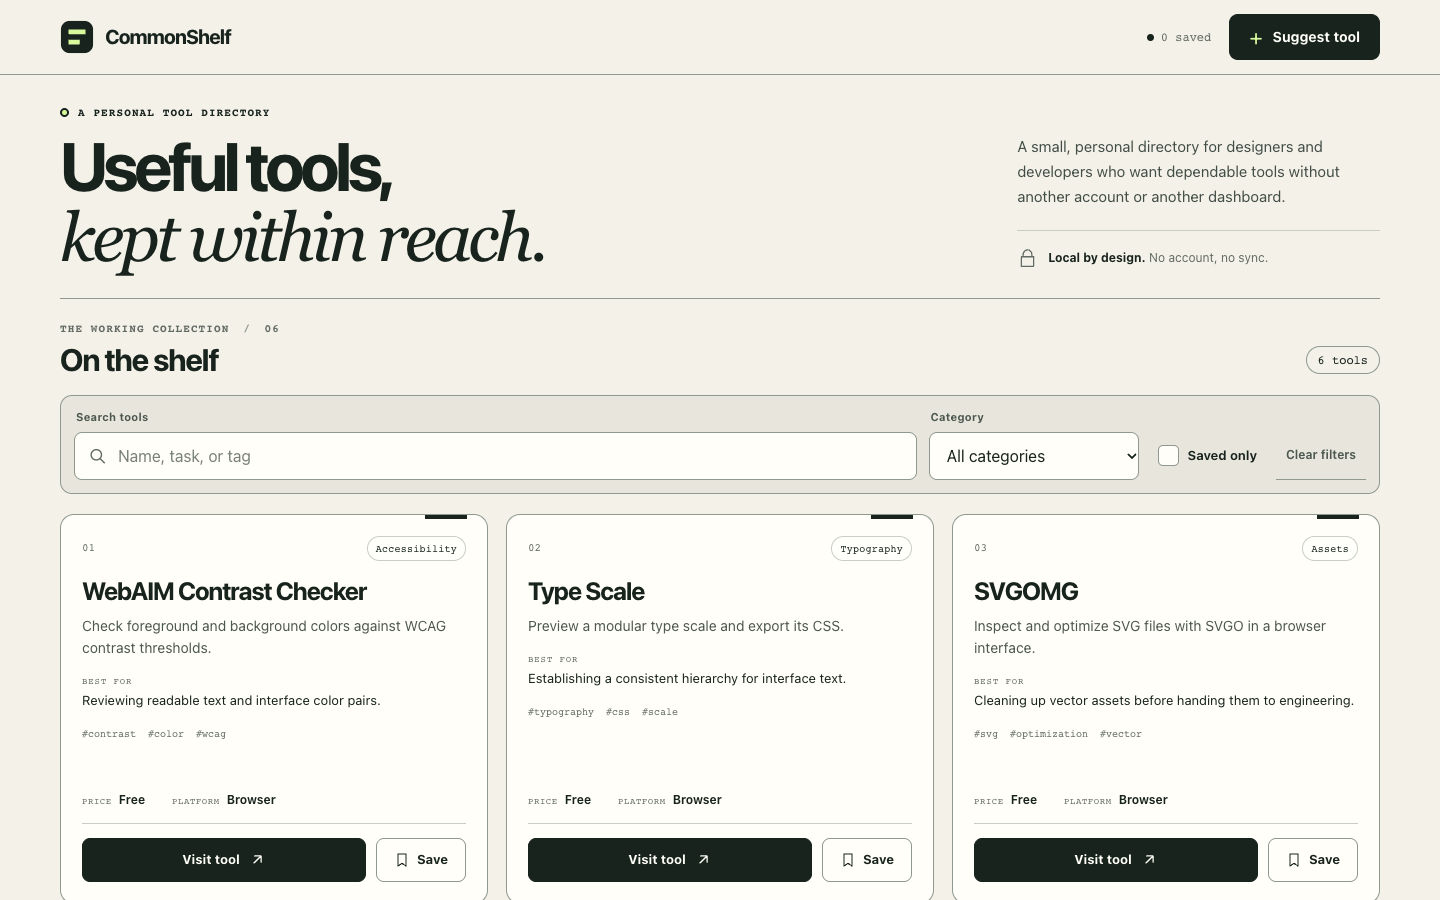
Las puntuaciones visuales fueron 87, 87 y 90, con 6/6 escenarios funcionales superados cada vez. Run-1 construyó un «cajón de trabajo» con superficies gris frío, papel de etiquetas, líneas de estantes dibujadas a mano, marcadores y símbolos distintos, manteniendo los resúmenes y casos de uso como foco. Guardar cambiaba el texto, el relleno del marcador y el color de la superficie; la primera tarjeta móvil y las acciones del formulario no válido eran totalmente visibles.
Run-2 mantuvo una jerarquía clara, pero combinó una barra superior de 6px en las tarjetas, una línea inferior gruesa y líneas izquierdas alrededor de filtros y sugerencias, haciendo el diseño visualmente más pesado. Su diálogo de error móvil colocó cancelar y guardar por debajo del viewport inicial de 844px, obligando a desplazarse. Run-3 también repitió líneas izquierdas azules y utilizó etiquetas y metadatos pequeños. Su media coincide con la de Impeccable, pero las pantallas y las debilidades son diferentes.
UI UX Pro Max 2.15.0: 86.7, estados completos limitados por la densidad móvil y la ubicación de las acciones
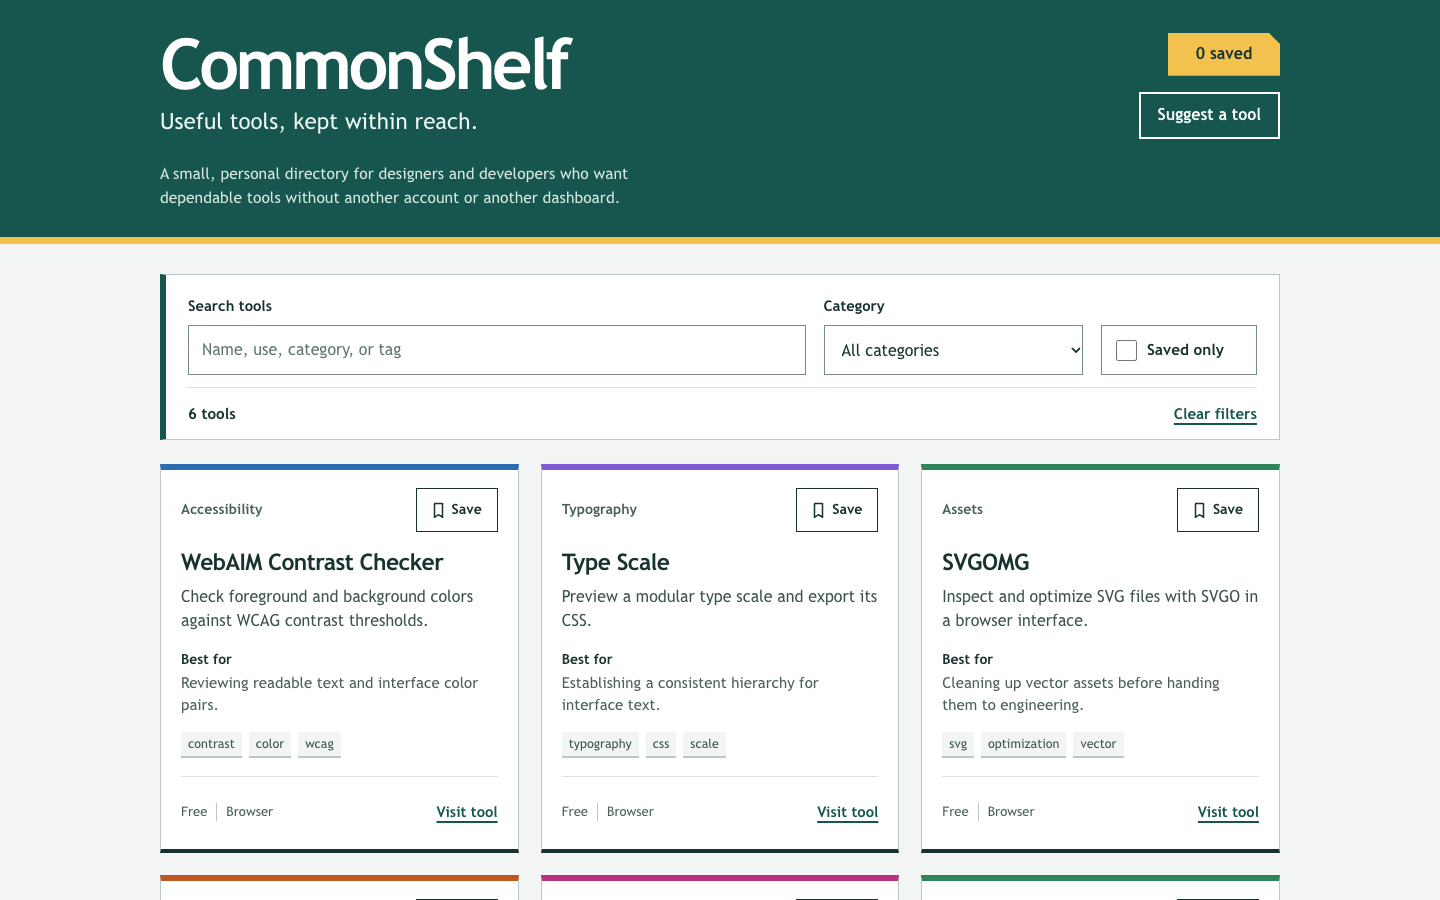
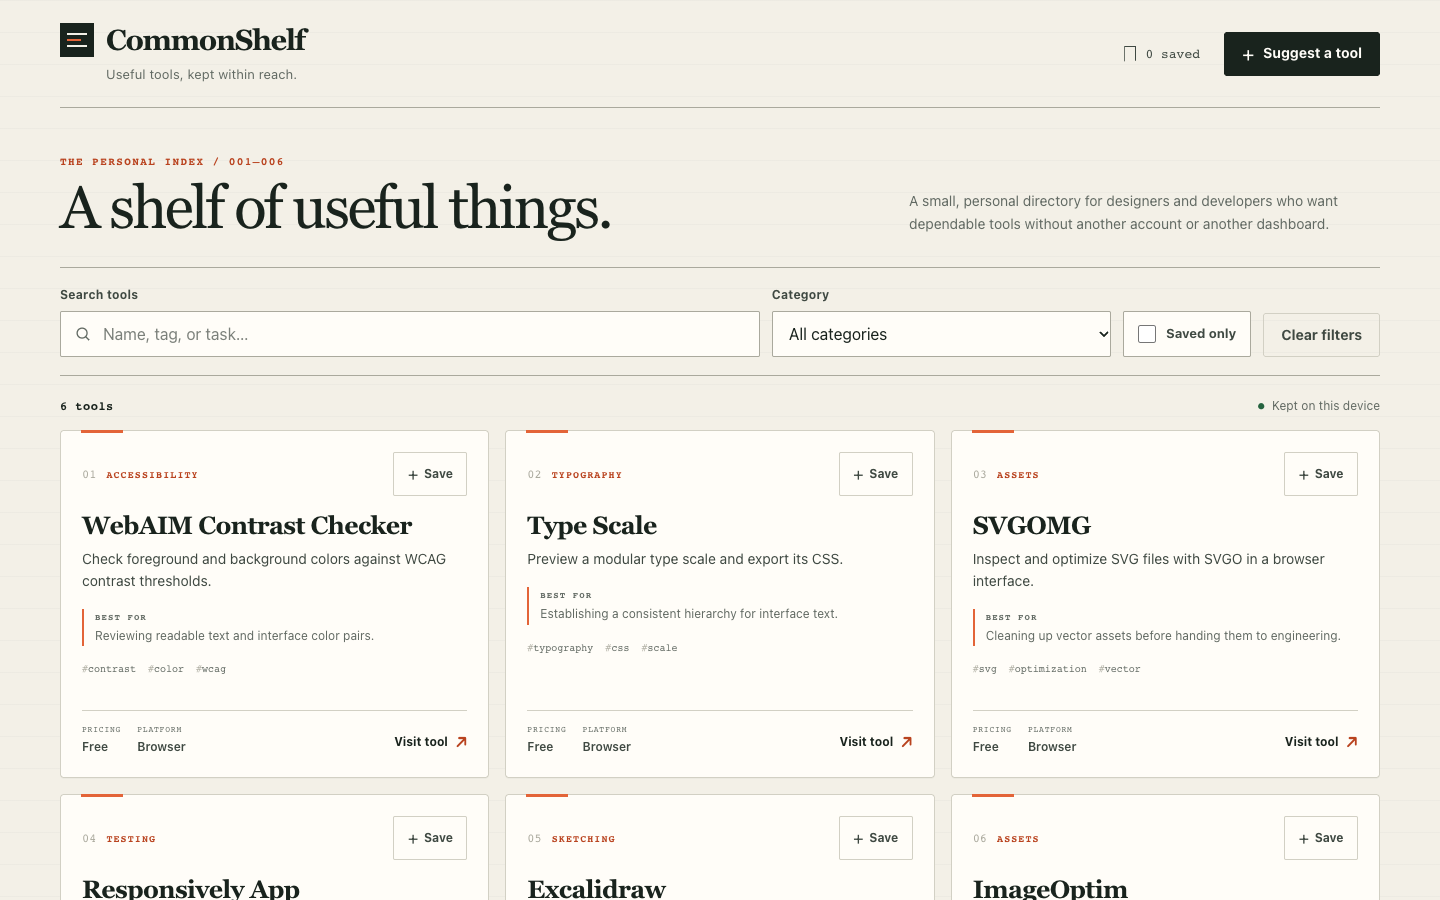
Las puntuaciones visuales fueron 86, 88 y 86, con 6/6 escenarios funcionales superados cada vez. Las tres versiones organizan las seis herramientas por nombre, resumen, caso de uso, etiquetas, precio y plataforma. Guardar actualiza el texto Save/Saved, el marcador, el recuento y el estado Saved only; los fallos de carga, la degradación del almacenamiento y los errores del formulario tienen vías de recuperación.
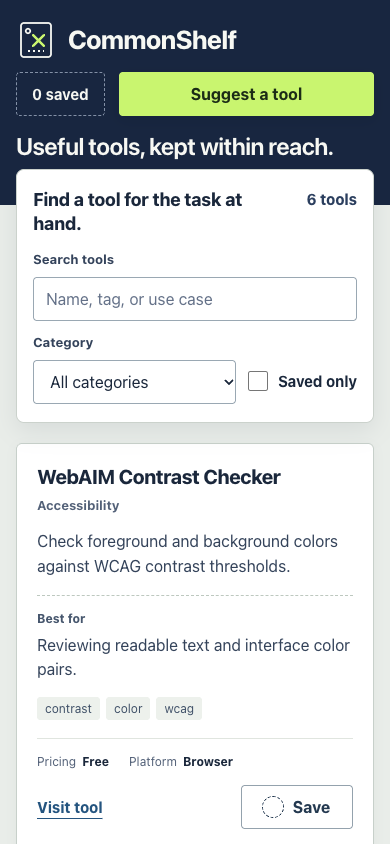
Run-2 repitió un acento superior de 4px en las tarjetas y líneas izquierdas en sugerencias y especificaciones; las frecuentes categorías, cifras y etiquetas de 12px hacían que el tratamiento resultara formulista. En run-3, la primera tarjeta móvil comenzaba alrededor de 712px, dejando solo su parte superior visible en un viewport de 844px, y la página completa medía unos 4695px. Los formularios de error largos, en escritorio y móvil, exigían desplazarse para encontrar enviar y cancelar; superaron la validación, pero completar el flujo fue menos directo.
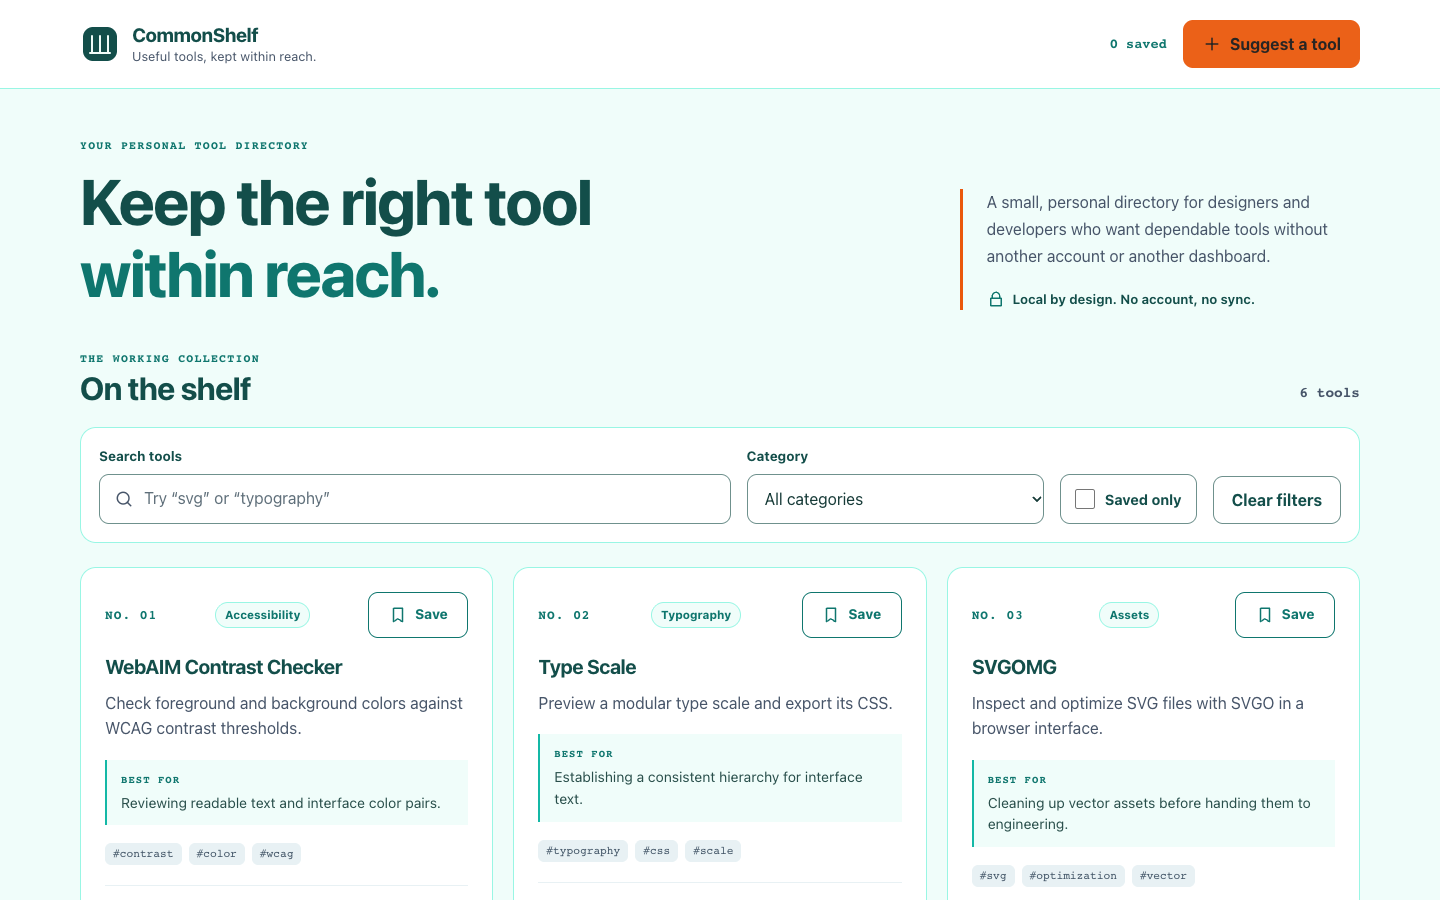
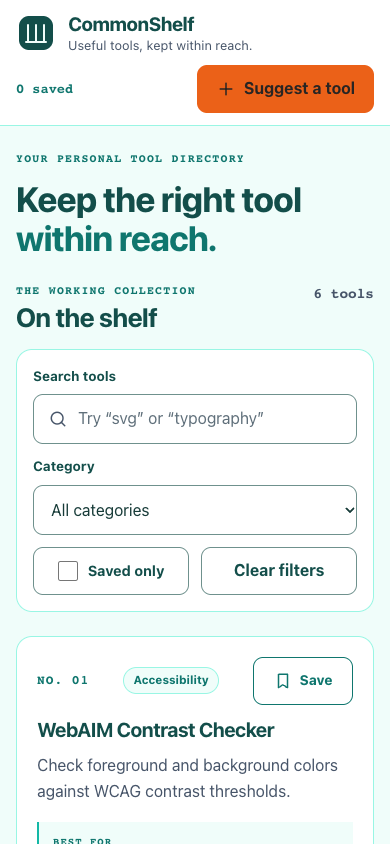
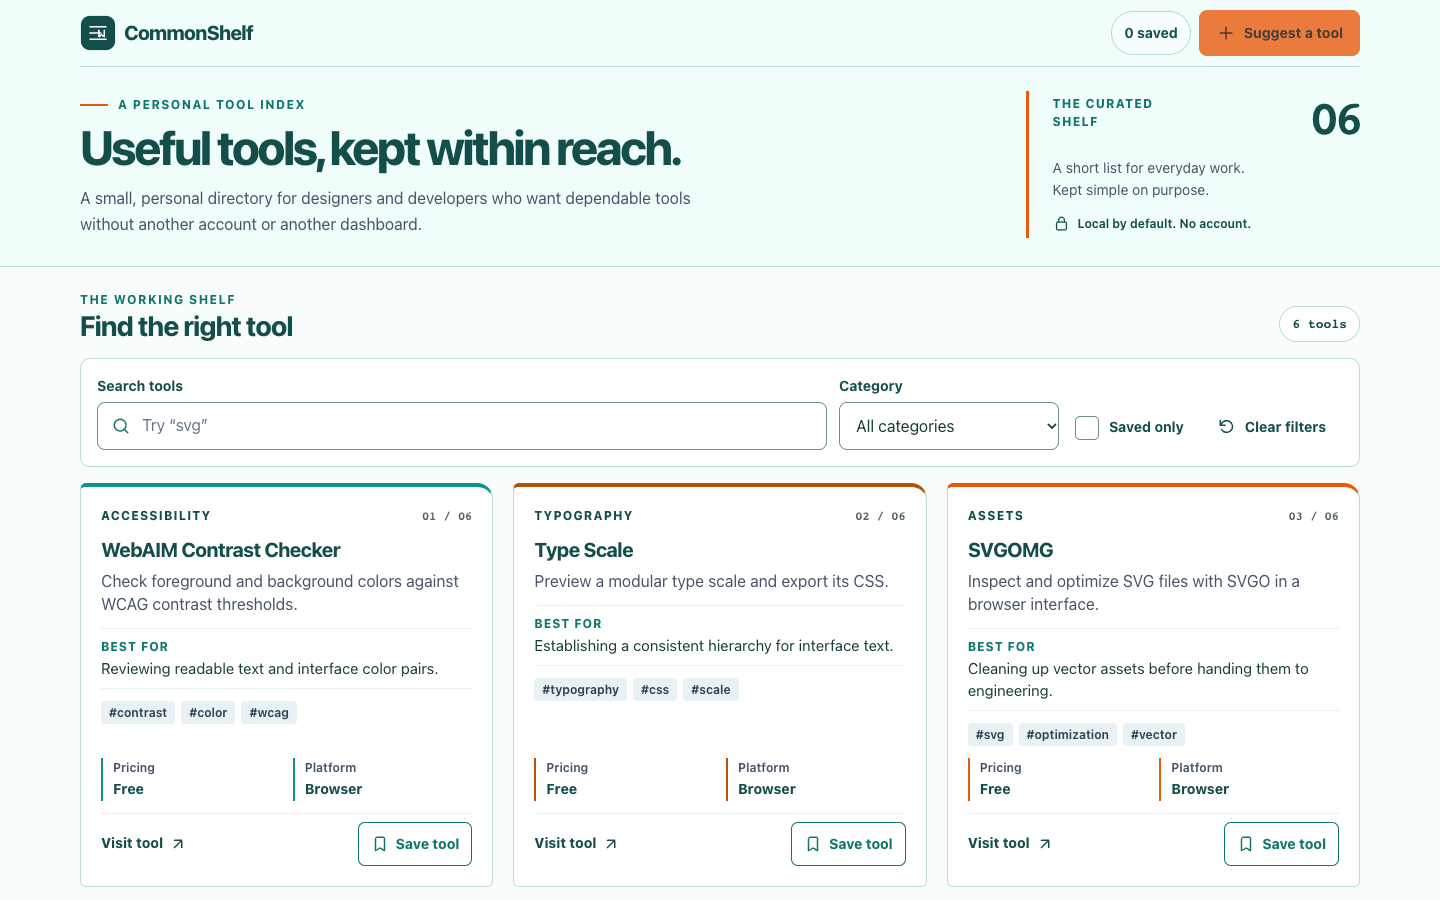
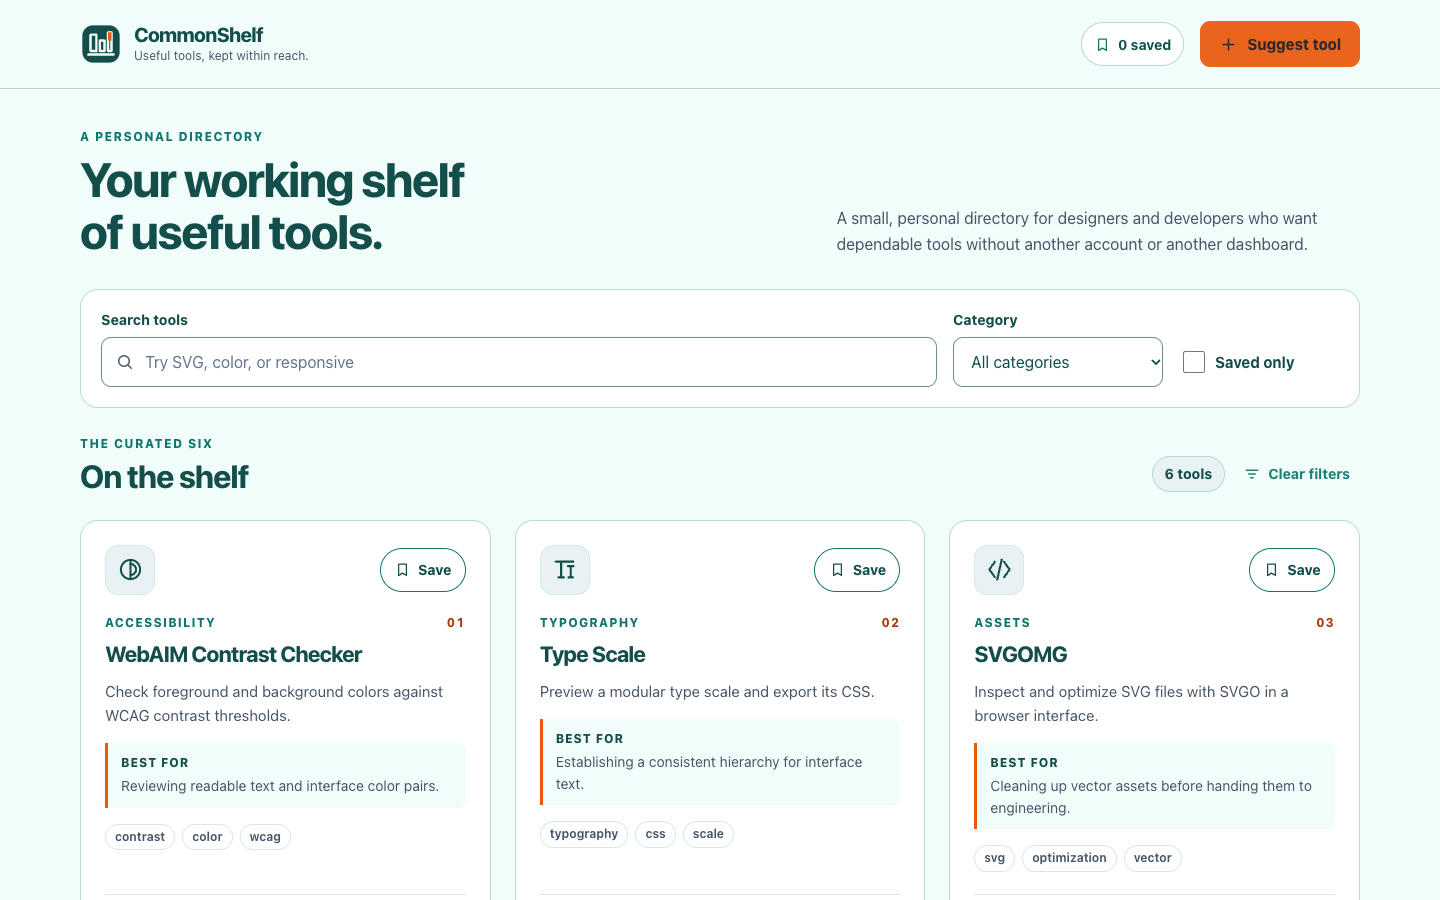
Impeccable 4.7.0: 88.0, con detalles del directorio vinculados al estado real
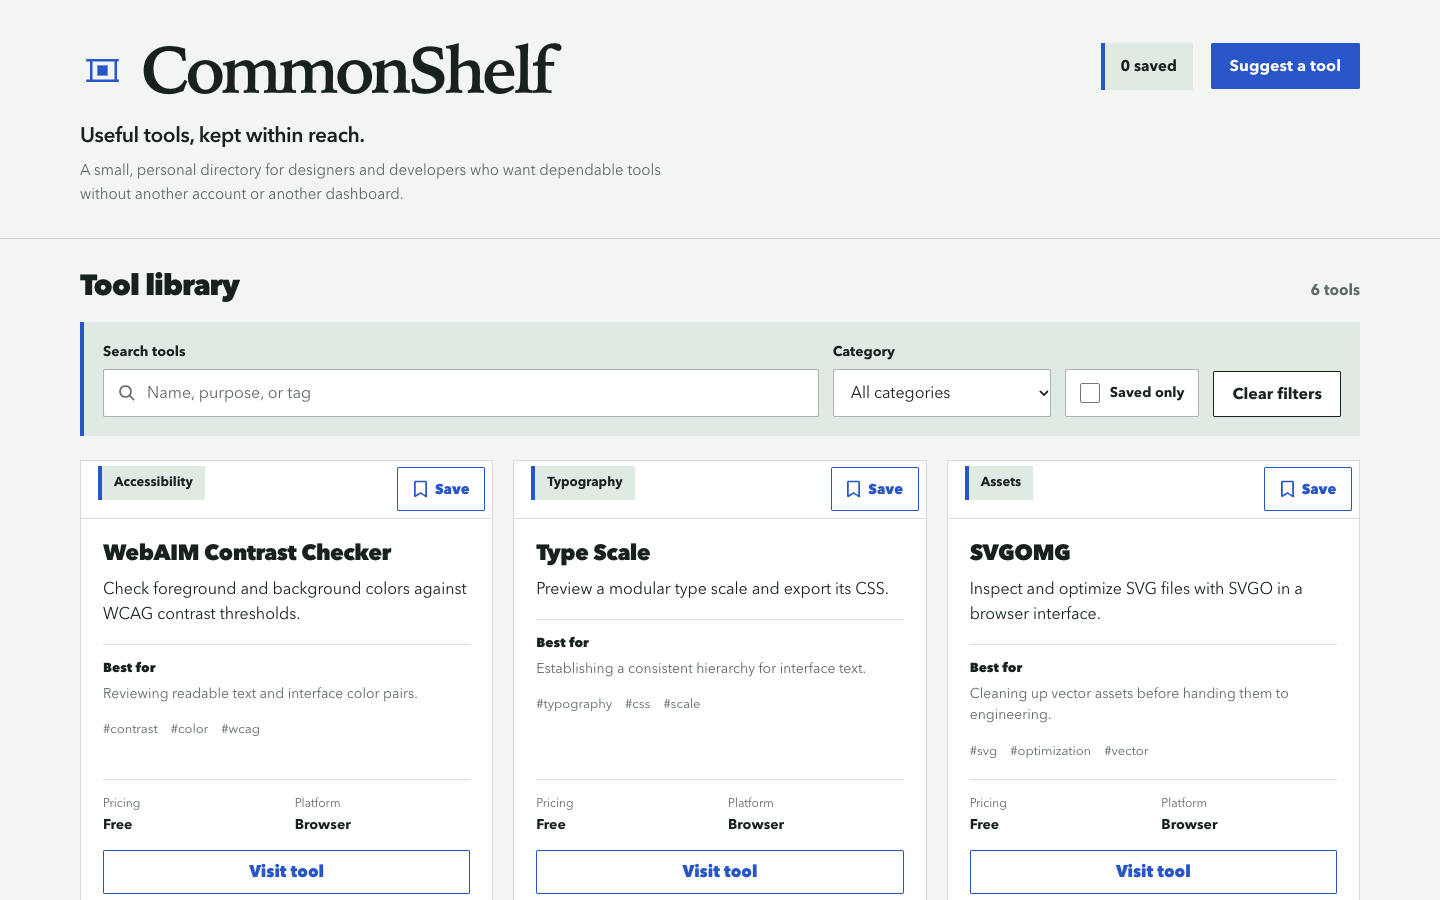
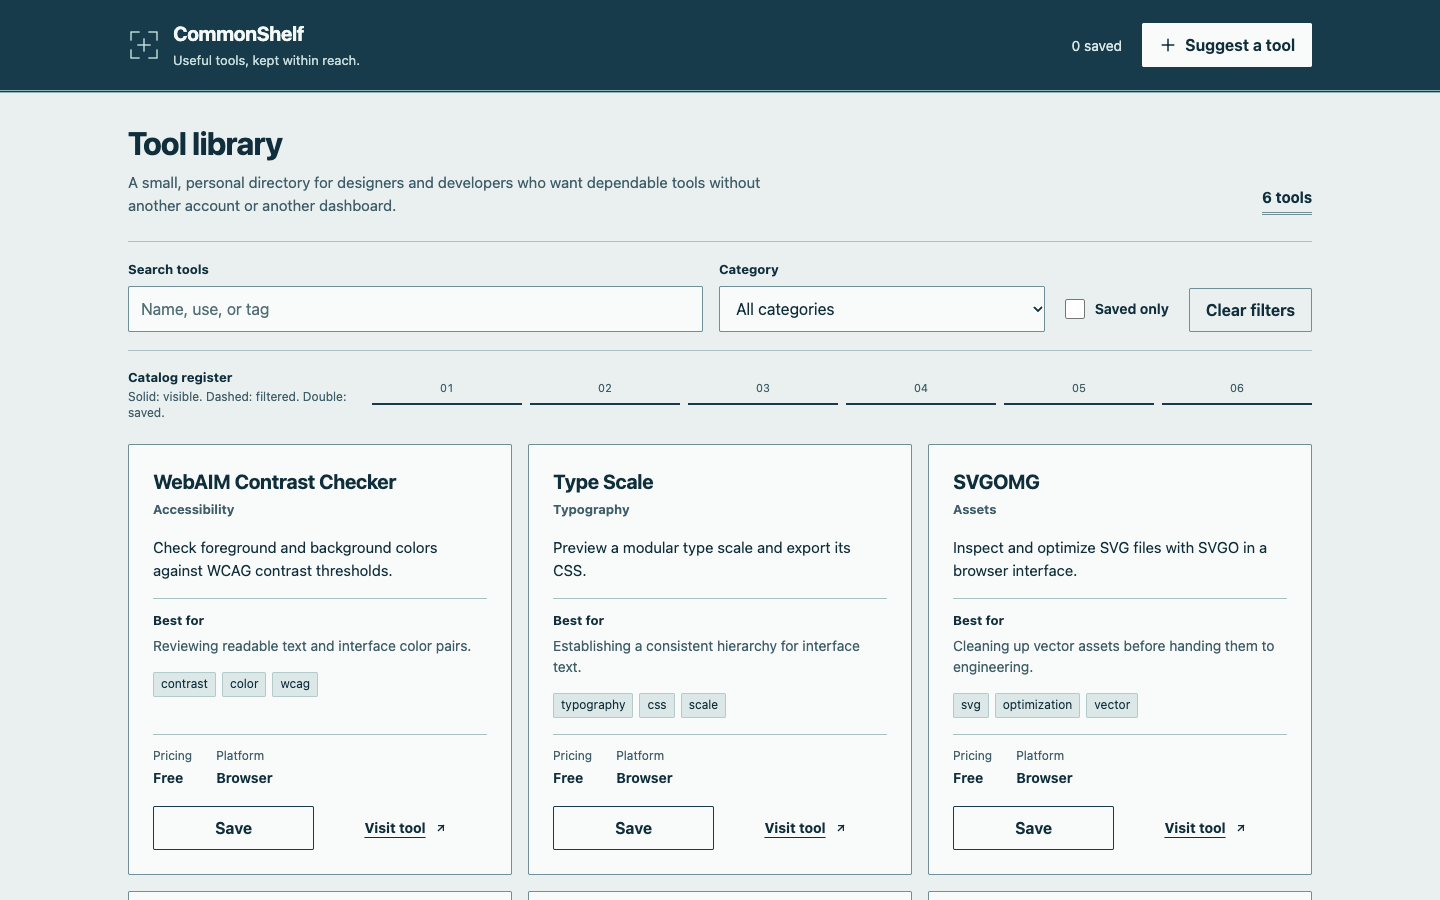
Las puntuaciones visuales fueron 88, 87 y 89, con 6/6 escenarios funcionales superados cada vez. Run-1 utilizó perforaciones, líneas discontinuas y marcas de costura para formar una dirección coherente de muestras de tickets. En run-3, el Catalog register cambiaba los estilos de línea con la búsqueda, el guardado y el filtrado, vinculando la decoración al estado real. La respuesta al guardar combinaba texto, marcas, relleno o bordes; los resultados vacíos y los fallos de carga ofrecían una acción siguiente.
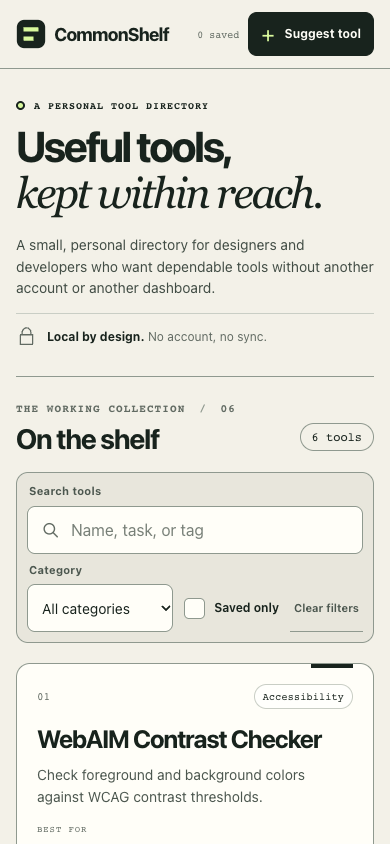
Las deducciones se centraron en la densidad y los flujos de pantallas pequeñas. En run-1, los resúmenes, las etiquetas y los metadatos no compartían líneas de base entre tarjetas de una misma fila cuando variaba su longitud, y los metadatos de 12px eran débiles. Run-2 combinó una cabecera alta con varias capas de filtros, dejando menos acciones de herramientas en el primer viewport móvil y produciendo una página de 3149px. Varios diálogos de error móviles también exigían más desplazamiento para mostrar cancelar y guardar.
Control sin Skill: 84.3, interfaces completas junto a dos fallos que siguen visibles
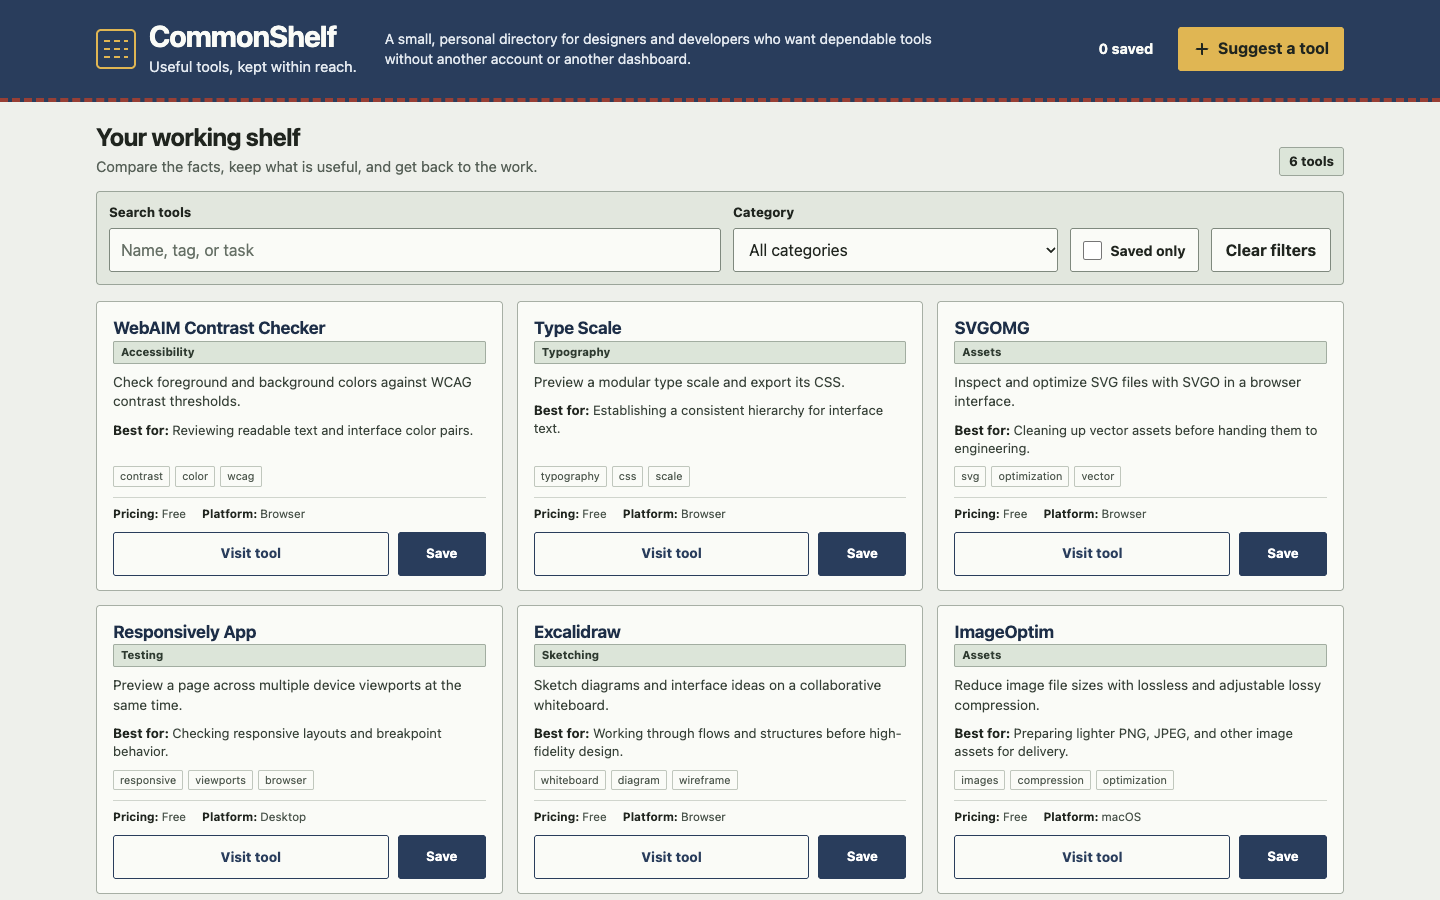
Las puntuaciones visuales fueron 83, 86 y 84. El papel cálido, la numeración y las líneas de índice también formaron directorios coherentes, con diseños de tres columnas en escritorio y una en móvil en general claros; guardar y los estados vacíos solían comunicarse mediante más señales que el color. El modelo subyacente ya puede producir interfaces completas sin una Skill, por lo que la evaluación necesita comparaciones concretas y no una puntuación inicial de cero.
Run-1 y run-3 fallaron la aserción de texto exacto del Toast en interaction-and-persistence: el contrato esperaba “Suggestion saved.”, pero el texto real añadía una marca de verificación y espacios en blanco. En run-3, esa marca era aria-hidden en el HTML, por lo que el resultado no demuestra que las sugerencias o la persistencia estuvieran totalmente rotas. Según el contrato fijado, ambas ejecuciones siguen marcadas como failed con 5/6 escenarios, y los pasos posteriores a la aserción fallida no cuentan como aceptados.
El texto auxiliar fue repetidamente demasiado pequeño o tenue. En run-3, los cálculos de color muestreados revelaron un contraste débil en los números de herramientas y los placeholders, e inicialmente solo era visible el borde superior de las acciones inferiores del diálogo de error móvil. En run-1, la introducción y los filtros ocupaban la mayor parte de la primera pantalla móvil.
Apéndice | Candidato de optimización de Oil UI 0.24.2: un ensayo de seguimiento
Este apéndice recoge un ensayo de seguimiento de un candidato de optimización independiente basado en Oil UI 0.24.2, de nuevo con Kimi AgentSwarm y kimi-1021-preview. El candidato no es una nueva versión oficial, está fuera de la muestra original de 15 ejecuciones y no cambia ni sustituye esos resultados; un solo ensayo no demuestra una mejora general.
La validación funcional independiente superó 6/6 escenarios y la comprobación ampliada de interacción continua superó 2/2 con 11 puntos de control. Los dos revisores independientes a ciegas dieron 89 y 90 puntos, con una media de 179/2 = 89.5. No volvieron a ejecutar Playwright y las evidencias funcionales se mantienen separadas de las puntuaciones visuales. La evidencia directa solo cubre Chromium a 1440×900 y 390×844, no teléfonos reales, todos los puntos de interrupción, otros navegadores ni una auditoría completa de accesibilidad.
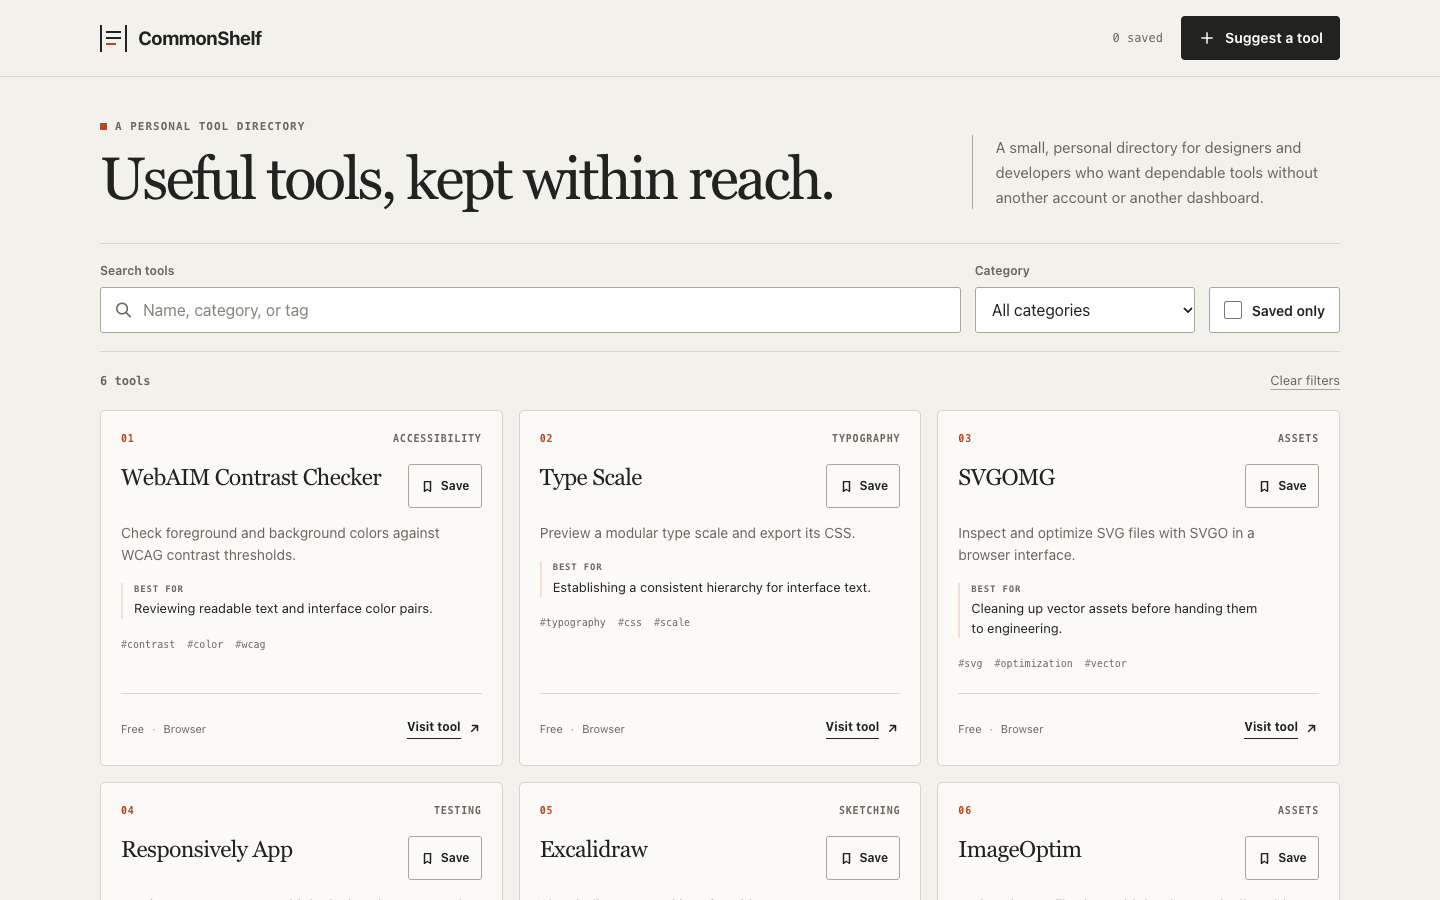
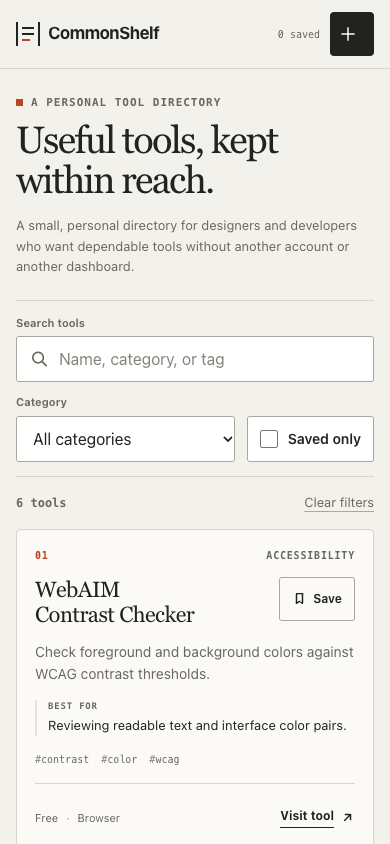
- DOM y movimiento: no se observó una repetición de toda la lista durante el uso continuo o la restauración
- En los 11 puntos de control consecutivos, las tarjetas conservadas registraron sameOriginalNode=true en lugar de reconstruir todo el conjunto. Los registros animationstart de tarjetas y sugerencias estaban vacíos y ambos revisores inspeccionaron el video de interacción continua. La transición CSS localizada del botón de guardado se registró por separado, no como una repetición de la lista. Tras la recarga, las seis tarjetas restauradas y la sugerencia tenían cssAnimations=0, restoreAnimationStarts estaba vacío y tanto el estado guardado como el contenido de la sugerencia se recuperaron.
- Acciones móviles y jerarquía visual
- Con cuatro errores en el viewport de 390×844, los botones de cancelar y enviar medían 48px de alto y tenían el borde inferior en 819px, por lo que permanecían dentro del viewport. Ambas acciones fueron clics táctiles reales y el envío corregido se conservó tras la recarga. Ambos revisores a ciegas confirmaron que el diálogo y el resumen de errores no tenían una barra gruesa de énfasis superior y que su jerarquía seguía siendo clara.
- Los errores antiguos, el texto pequeño y el contraste del placeholder aún necesitan trabajo
- Después de corregir los campos y antes del siguiente envío, el resumen de errores anterior y los errores por campo seguían visibles. Esto coincide con la validación al enviar, no es un fallo funcional, pero reduce la inmediatez de la respuesta. Parte del texto secundario sigue midiendo 9–11px. El revisor A midió un contraste aproximado de 3.76:1 en el texto placeholder de entrada, por debajo de la referencia de 4.5:1 para texto normal; fue solo una medición localizada, no una certificación completa de contraste.
Limitaciones: qué demuestran estas evidencias y qué no
La prueba cubre un brief estático de CommonShelf en inglés, un modelo y tres muestras finales por condición. La rúbrica de seis dimensiones sigue implicando criterio: una revisión corresponde a un paquete anonimizado, no a una investigación de usuarios a gran escala ni a un experimento de significancia estadística. Otra tarea, idioma de contenido, framework o modelo podría cambiar el resultado.
La validación funcional cubrió seis grupos de escenarios predefinidos en Chromium, no una auditoría completa del producto. Los diseños para tableta tenían evidencias en las hojas de estilo, pero no capturas dedicadas. No se completaron comprobaciones de Safari, Firefox, dispositivos táctiles reales, lectores de pantalla, zoom al 200% ni una revisión WCAG completa. Las capturas estáticas no describen el ritmo de una animación continua: los fotogramas transparentes de Oil UI run-3 demuestran un problema de respuesta, pero no la calidad del fotograma estable posterior.
Las demos públicas conservan las páginas reales posteriores a la generación y los fallos funcionales. Las interrupciones técnicas y la recuperación dentro del protocolo no se contaron como fallos funcionales de los candidatos ni se usaron para comparar el tiempo transcurrido; son evidencias distintas de la validación independiente posterior a la generación.
Reproducción: inspecciona las evidencias y ejecuta después tu propia comparación
Usa las 15 demos, las 20 imágenes iniciales y results.json para comprobar este artículo. Para una repetición comparable, mantén el mismo brief, las versiones fijadas y el modelo; inicia un agente nuevo cada vez, conserva los tres resultados y ejecuta una validación independiente después de la generación. El archivo de contenido público es una copia byte por byte de la que se sirve con la demo. El prompt siguiente es un brief condensado, no el archivo de tarea congelado original.
El comando de instalación de código abierto instala la versión que resuelva al ejecutarlo, no necesariamente 0.24.2. Para una comparación estricta, registra la versión instalada y utiliza los commits fijados de la tabla. Una versión más reciente debe tratarse como una prueba nueva, no sobrescribir estas cifras.
Instala Oil UI de código abierto y registra la versión
Prueba primero la Skill de código abierto en tu propia tarea. Oil UI Pro no se utilizó en esta prueba comparativa.
npx skills add oil-oil/oil-uiEjecuta tres generaciones independientes por condición
Mantén fijos el modelo y los datos de contenido. Inicia cada ejecución con un agente y un espacio de trabajo nuevos, entrega una dirección y no importes ni repares la página de otra ejecución ni sustituyas un resultado más débil.
Separa la validación funcional de la revisión visual anónima
Comprueba los seis grupos de escenarios a 1440×900 y 390×844 y conserva cada aprobación o fallo. Oculta las condiciones para la revisión visual, aplica las mismas seis dimensiones y publica todos los resultados, no solo las medias.
Build one complete CommonShelf static web app with plain HTML, CSS and JavaScript. Use the supplied content.json unchanged. Make one coherent direction without asking for a selection. At 1440×900 and 390×844, the first viewport must help a visitor find, understand and save tools. Implement combined search, category and saved-only filters; local-storage saves; a validated suggestion dialog; exactly three keyboard-operable FAQ items; actionable content-unavailable and storage-unavailable states; visible focus; and reduced motion. Keep suggestions outside the curated tool grid. Make no external requests except user-activated official links. Do not import another run or replace a weak result. Preserve every failure, then independently verify the actual page and review anonymized screenshots and runtime files.Este es un brief condensado para una repetición comparable. La reproducción estricta también requiere las versiones fijadas anteriores, los seis grupos de escenarios de validación y la misma rúbrica de puntuación.
Ejemplos funcionales y prompts de la galería
Abre las demos en directo a 1440 o 390 píxeles para examinar cómo el modelo y el prompt dieron forma a la interfaz final.
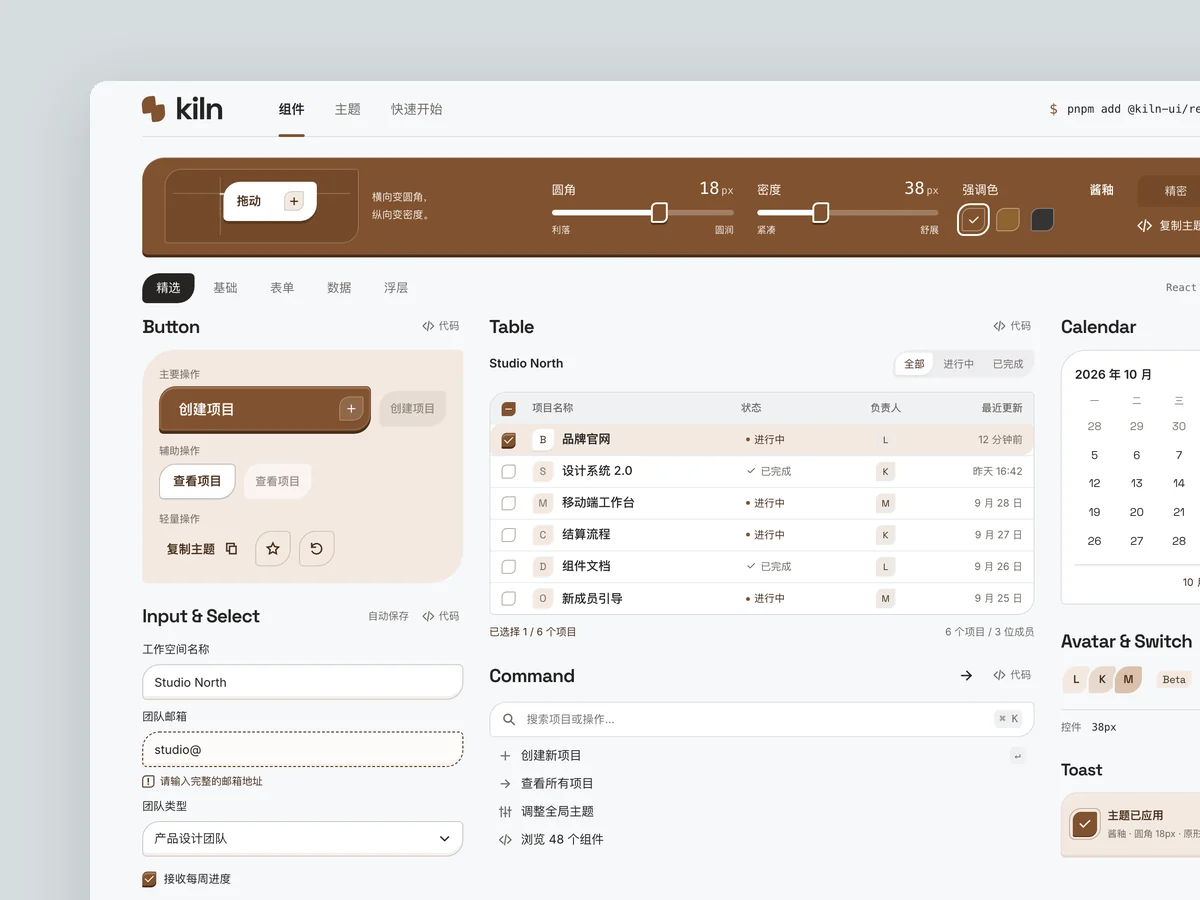
Kiln
Sitio web de biblioteca de componentes
Producto: Kiln, una biblioteca de componentes de código abierto para desarrolladores de React con más de 40 componentes, incluidos botones, campos de entrada, menús desplegables, paletas de comandos, diálogos, información emergente, tablas y selectores de fecha. Admite personalización de temas. Construye la página de inicio de su sitio web, opcionalmente con una página de detalle de componente: - Muestra componentes reales e interactivos directamente en la página de inicio, no capturas. Un «muro de componentes» debe contener componentes funcionales que los usuarios puedan pulsar, en los que puedan escribir y que puedan cambiar. - Toma como referencia la precisión y la contención de los principales sitios de herramientas para desarrolladores: predominantemente blanco y negro, como máximo un color de acento, una cuadrícula estricta y tipografía monoespaciada para código y números. - Haz memorable un controlador de tema: arrastrar controles de radio, densidad o color de acento cambia todos los componentes de la página de inmediato. - Incluye un comando de instalación copiable, fragmentos de código, navegación por categoría de componentes y cifras de uso realistas, como estrellas de GitHub y descargas semanales, evitando números excesivamente redondos.
Ver obra y prompt →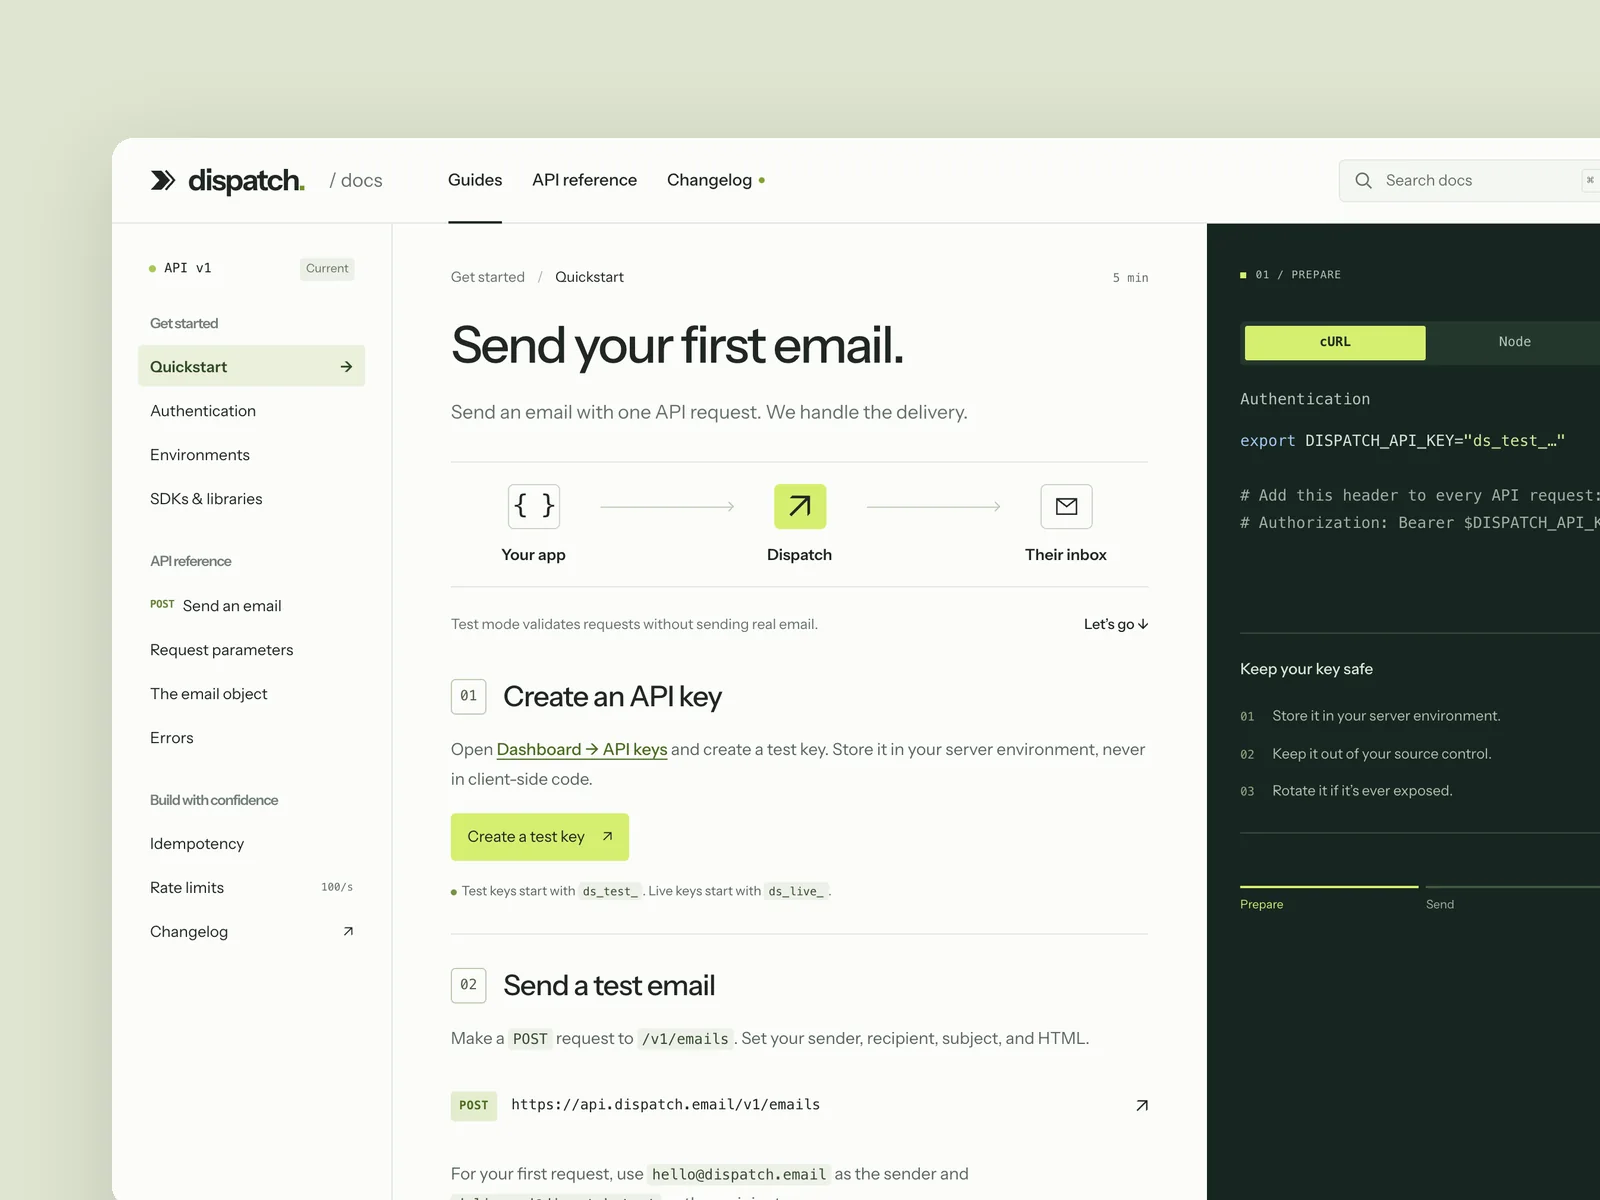
Dispatch
Documentación de API para desarrolladores
El sitio de documentación para desarrolladores de una empresa de API de pagos o mensajería (desde 1440×900, adaptable hasta 390 px de ancho): navegación a la izquierda, artículo en el centro y ejemplos de código a la derecha que cambian entre lenguajes (cURL, Node, Python). Incluye una guía rápida, una referencia completa de un endpoint (tabla de parámetros, ejemplos de solicitud y respuesta, códigos de error) y búsqueda. Mientras lees, los ejemplos de código siguen la sección actual y el lenguaje elegido se recuerda en todo el sitio. Diseña la página de guía rápida, una página de referencia de endpoint y la búsqueda abierta.
Ver obra y prompt →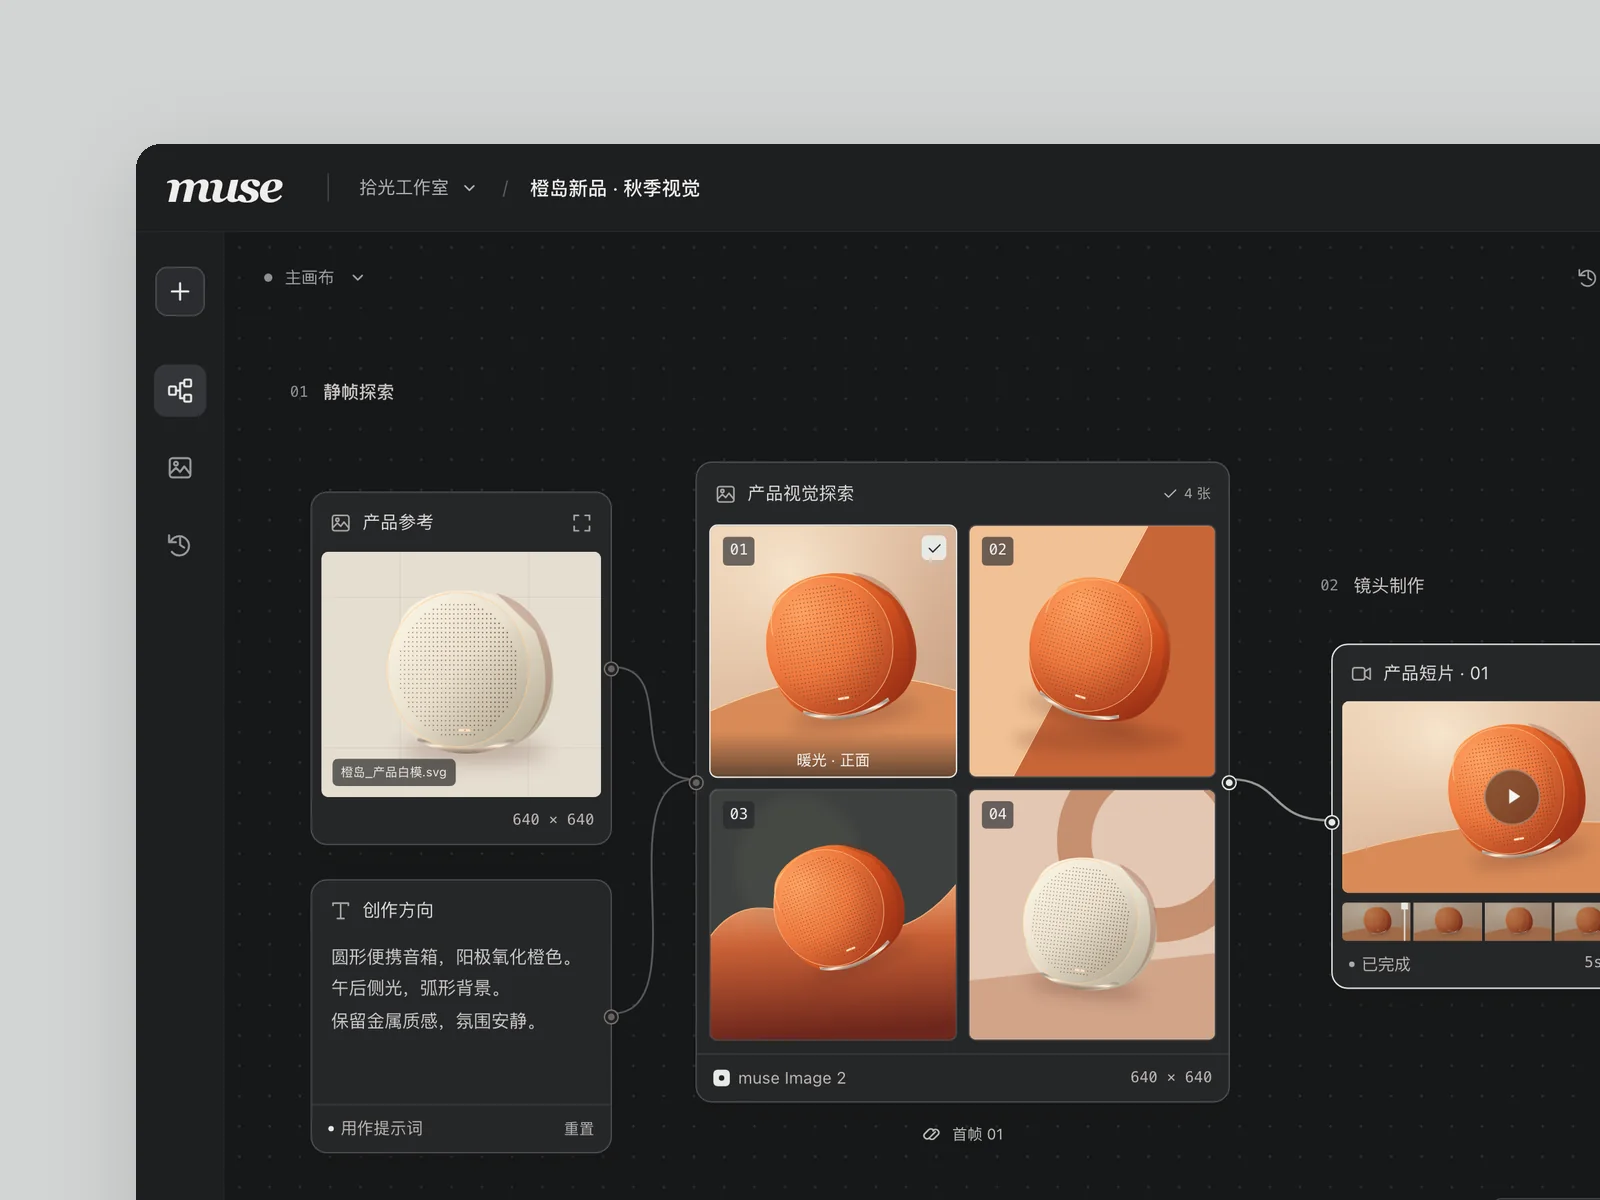
muse
Lienzo de imágenes y vídeo con IA
Una herramienta de generación de imágenes y vídeo con IA para diseñadores y equipos creativos, con todas las instrucciones, imágenes de referencia y resultados generados en un lienzo infinito. Construye el espacio de trabajo principal.
Ver obra y prompt →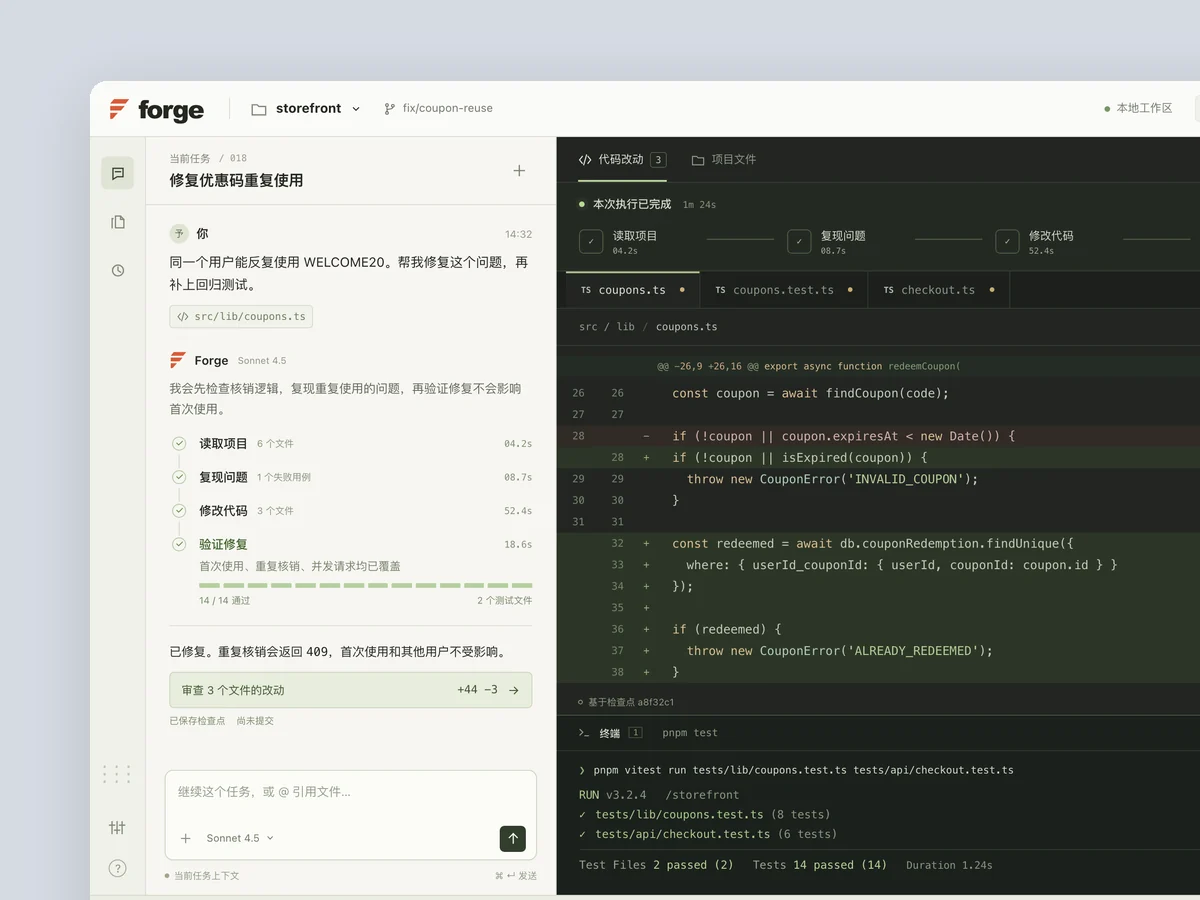
Forge
Asistente de programación con IA
Producto: Forge, un asistente de programación con IA para escritorio. Una conversación se sitúa a la izquierda, con el código que se está editando y la terminal a la derecha. Los usuarios pueden ver cómo lee archivos, edita código y ejecuta pruebas paso a paso. Construye su interfaz principal (1440×900) con datos realistas: nombres de archivos, diffs y salidas de pruebas que parezcan de un proyecto real. Haz visible y memorable el trabajo de la IA: los pasos se iluminan uno a uno, las líneas del diff aparecen progresivamente y las pruebas pasan de rojo a verde. Captura también un estado en el que espera a que el usuario confirme un cambio arriesgado.
Ver obra y prompt →Opcional: Oil UI Pro no formó parte de esta prueba comparativa
Todos los resultados de Oil UI proceden de la versión 0.24.2 de código abierto; Pro no intervino en la generación, la validación ni la puntuación. Inspecciona las demos, revisa los fallos y vuelve a ejecutar primero la Skill de código abierto. Considera Pro por separado si tu flujo de trabajo necesita sus métodos adicionales.
npx github:oil-oil/oil-cli install oil-ui-proPreguntas frecuentes
¿Puede esta comparación decidir qué Skill debo instalar?
No decidas solo por las medias. Compara la jerarquía del catálogo, las acciones móviles, el movimiento, los fallos funcionales y las licencias de las fuentes; después abre las demos que coincidan con tus prioridades.
¿Por qué Oil UI run-3 obtuvo 83 puntos visuales si superó todos los escenarios funcionales?
La validación confirma que los comportamientos especificados funcionan; la revisión visual también examina la respuesta. Cada reconstrucción de tarjetas de esta ejecución reprodujo una animación desde la transparencia, dejando áreas de resultados casi en blanco en varias capturas de búsqueda, guardado y sugerencias. Este defecto visible justifica la puntuación de 83, pero no demuestra una pérdida permanente de datos.
¿Los dos fallos sin Skill significan que guardar estaba completamente roto?
No. Ambas ejecuciones fallaron una aserción de texto exacto del Toast porque el texto real añadía una marca de verificación y espacios en blanco. Eso no demuestra un fallo total de guardado o persistencia, pero sí incumple el contrato predeterminado, por lo que ambas siguen marcadas como failed con 5/6.
¿Cómo puedo verificar las cifras y pantallas de este artículo?
Descarga results.json para consultar cada puntuación de las seis dimensiones, el total y el resultado funcional; después abre, para cada candidato, sus tres imágenes iniciales de escritorio, una imagen móvil y tres demos funcionales. Todas las imágenes móviles proceden de run-1; no se sustituyó por una ejecución con mayor puntuación y ninguna captura de formulario sirve como imagen principal.