
4 UI-Design-Skills im Test: 15 Durchläufe, ein Modell, anonyme visuelle Reviews
In Kimi AgentSwarm bearbeiteten vier fixierte UI-Design-Skills und eine Kontrolle ohne Skill mit kimi-1021-preview jeweils 3-mal dasselbe CommonShelf-Briefing für einen Werkzeugkatalog: insgesamt 15 Durchläufe. 13 bestanden die Funktionsabnahme, 2 schlugen fehl, beide in der Kontrolle. Die visuellen Durchschnittswerte waren Oil UI 87.0, frontend-design 88.0, UI UX Pro Max 86.7, Impeccable 88.0 und Kontrolle ohne Skill 84.3. Wenn du einen UI-Design-Skill auswählst und Wert auf Kataloghierarchie, mobile Aktionen, Bewegung und funktionale Zuverlässigkeit legst, vergleiche die Kandidaten anhand der folgenden Demos und Fehlerdetails. Die Schlussfolgerungen gelten nur für dieses Briefing und dieses Modell.
Die wichtigsten Punkte
- Alle vier Skill-Versionen wurden vor der Generierung fixiert. Jeder Durchlauf verwendete einen neuen Agenten in einem neuen Arbeitsbereich und lieferte nur eine Richtung; schwächere Ergebnisse wurden nicht ersetzt.
- Beide Funktionsfehler traten bei exakten Toast-Textprüfungen in der Kontrolle ohne Skill auf; keiner beweist ein vollständiges Versagen der Persistenz.
- Oil UI run-3 bestand 6/6 Funktionsszenarien, doch wiederholte Kartenanimationen ab Transparenz ließen mehrere Zustandsaufnahmen fast leer erscheinen; die visuelle Bewertung war 83.
Aufgabe und Versionen: ein CommonShelf-Briefing
CommonShelf ist ein persönlicher Werkzeugkatalog ohne Kontoführung. Das Briefing stellt 6 feste Tool-Datensätze bereit und verlangt Implementierungen in reinem HTML, CSS und JavaScript für Suche, Filter nach Kategorie und Speicherstatus, das Speichern von Werkzeugen, ein validiertes Vorschlagsformular und eine per Tastatur bedienbare FAQ. Abgesehen von einem vom Nutzer aktivierten offiziellen Tool-Link sendet die Seite zur Laufzeit keine externen Anfragen. Jeder Agent liefert nur eine Richtung, statt mehrere zu erzeugen und eine davon auszuwählen.
Jede Skill-Bedingung liest ihre zugewiesene SKILL.md nur einmal; die Kontrolle liest keine. Versionen werden vor der Generierung fixiert und nicht durch globale oder kostenpflichtige Editionen ersetzt; die Lizenzen werden zusammen mit den Quellen aufgeführt.
| Bedingung | Fixierte Version | Lizenz |
|---|---|---|
| Oil UI Open Source | 0.24.2 (tag v0.24.2) | MIT |
| frontend-design | commit-dbd4588f9e1033efb41dad4bef2f7947c8993d44 | Apache-2.0 |
| UI UX Pro Max | 2.15.0 (tag v2.15.0) | MIT |
| Impeccable | 4.7.0 (tag skill-v4.7.0) | Apache-2.0 |
| Kontrolle ohne Skill | Kein Upstream-Skill und keine Version | Keine Upstream-Lizenz angegeben |
Methode: 15 unabhängige Generierungen, Funktion und visuelle Bewertung getrennt geprüft
Jede Generierung verwendete einen neuen Agenten in Kimi AgentSwarm mit kimi-1021-preview und Thinking Effort max. Die Bedingungen konnten parallel laufen, run-1, run-2 und run-3 innerhalb einer Bedingung liefen jedoch nacheinander. Jeder Durchlauf begann in einem neuen Arbeitsbereich, konnte weder Seiten, Screenshots noch Unterhaltungen eines anderen Durchlaufs lesen und ersetzte keine schwächeren Ergebnisse. Planung und Wiederherstellung beeinflussen die verstrichene Zeit, deshalb wurde Zeit nicht verglichen.
Nach der Generierung prüfte ein unabhängiger Runner mit Playwright 1.64.1 in Chromium 6 Szenariogruppen bei 1440×900 und 390×844: Desktop-Baseline, mobile Baseline, Interaktion und Persistenz, Inhalt nicht verfügbar, Speicher nicht verfügbar und reduzierte Bewegung. Die Abnahme spielte keine Korrekturen in das erzeugte Artefakt zurück, und visuelle Bewertungen wurden nicht als bestandene Funktionstests gewertet.
Das visuelle Review nutzte 15 anonymisierte Pakete, aus denen die Identität der Bedingung und die Aufzeichnungen des Generierungsprozesses entfernt waren; Laufzeitdateien, Screenshots und Abnahmestatus blieben verfügbar. Jedes Paket erhielt ein Review. Die Werte aus 6 Dimensionen wurden für jeden Durchlauf summiert und anschließend über 3 Durchläufe gemittelt; die Dimensionen ergeben 100, ohne zusätzliche Gewichtung oder Auswahl eines besonders gut bewerteten Durchlaufs als Vertreter der anderen.
| Dimension | Maximum |
|---|---|
| Visuelle Hierarchie und Lesbarkeit | 20 |
| Produktpassung und Originalität | 20 |
| Responsives Verhalten | 15 |
| Interaktion und Zustandsrückmeldung | 20 |
| Barrierefreiheit | 15 |
| Detail und Bewegung | 10 |
Ergebnisse: jede Bewertung und jedes Funktionsergebnis
Alle 15 Generierungen und anonymen visuellen Reviews wurden abgeschlossen; 13 Durchläufe bestanden die Funktionsabnahme, 2 schlugen fehl. Der Durchschnitt ist die Summe aus 3 Durchläufen geteilt durch 3 und wird mit einer Dezimalstelle gezeigt: UI UX Pro Max also 260/3, die Kontrolle ohne Skill 253/3. Das öffentliche JSON enthält jede Bewertung in 6 Dimensionen, jedes Funktionsergebnis und jede öffentliche Asset-URL.
| Bedingung | run-1 | run-2 | run-3 | Summe aus 3 Durchläufen | Durchschnitt | Funktion |
|---|---|---|---|---|---|---|
| Oil UI Open Source | 88 · bestanden | 90 · bestanden | 83 · bestanden | 261/300 | 87.0 | 3/3 bestanden |
| frontend-design | 87 · bestanden | 87 · bestanden | 90 · bestanden | 264/300 | 88.0 | 3/3 bestanden |
| UI UX Pro Max | 86 · bestanden | 88 · bestanden | 86 · bestanden | 260/300 | 86.7 | 3/3 bestanden |
| Impeccable | 88 · bestanden | 87 · bestanden | 89 · bestanden | 264/300 | 88.0 | 3/3 bestanden |
| Kontrolle ohne Skill | 83 · fehlgeschlagen | 86 · bestanden | 84 · fehlgeschlagen | 253/300 | 84.3 | 1/3 bestanden, 2 fehlgeschlagen |
Oil UI Open Source 0.24.2: 87.0, mit Punktabzug für wiederholte Transparenz in run-3
Die visuellen Bewertungen waren 88, 90 und 83; bei jedem Durchlauf wurden 6/6 Funktionsszenarien bestanden. Alle 3 Ergebnisse stellen Suche, Filter und die 6 Werkzeuge in den Mittelpunkt und halten die Reihenfolge der Karteninformationen stabil. Das Speichern aktualisiert Text, Symbole oder Form, Füllung und Zähler; leere Ergebnisse bieten einen Reset, Ladefehler einen erneuten Versuch, und Formularfehler enthalten eine Zusammenfassung sowie Hinweise zur Korrektur auf Feldebene.
In run-1 erfordert das lange mobile Formular nach dem Erscheinen von Fehlern einen Bildlauf, damit die vollständige Aktionszeile sichtbar wird; mehrere Aufnahmen erwischten spätere Karten während des Eingangs fast transparent. Run-2 entwickelte ein kohärenteres System aus gemeinsamen Indexlinien und Saved-Tabs, aber sein 420ms-Eingangseffekt erzeugte ausgewaschene Frames bei der Suche und beim Aktualisieren von Vorschlägen. Kleiner Monospace-Hilfstext erschwerte außerdem das Lesen langer Seiten.
In run-3 wurde bei jedem Neuaufbau durch renderTools() die 180ms lange card-in-Animation erneut abgespielt, beginnend mit opacity: 0. Eine Suchaufnahme zeigte „1 tool“, aber keine sichtbare Ergebniskarte; bei mobiler Suche, Saved-Refresh und Suggestion-Refresh waren die Karten fast transparent. Obwohl die Funktionsabnahme bestanden wurde, störte das wiederholte Verbergen primärer Inhalte bei gewöhnlicher Filterung die Rückmeldung; deshalb erhielt dieser Durchlauf 83 Punkte. Diese Frames beweisen keinen dauerhaften Datenverlust.
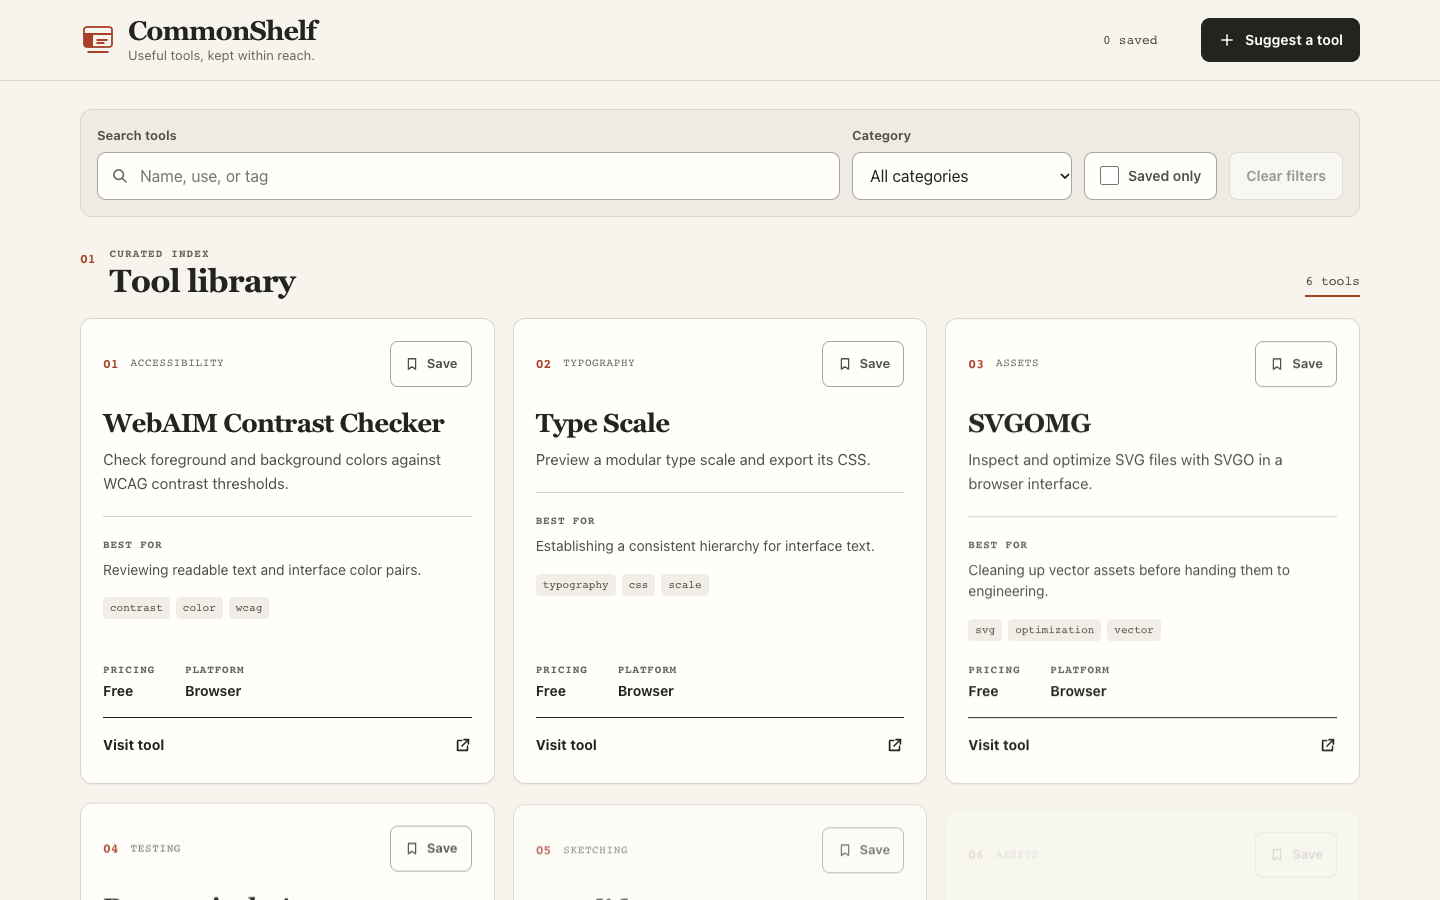
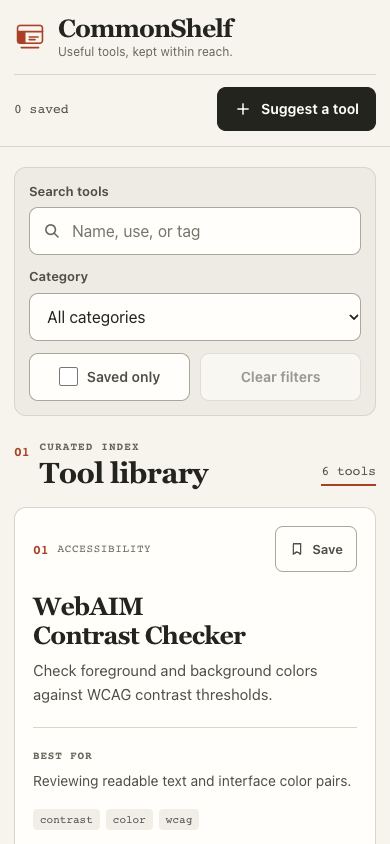
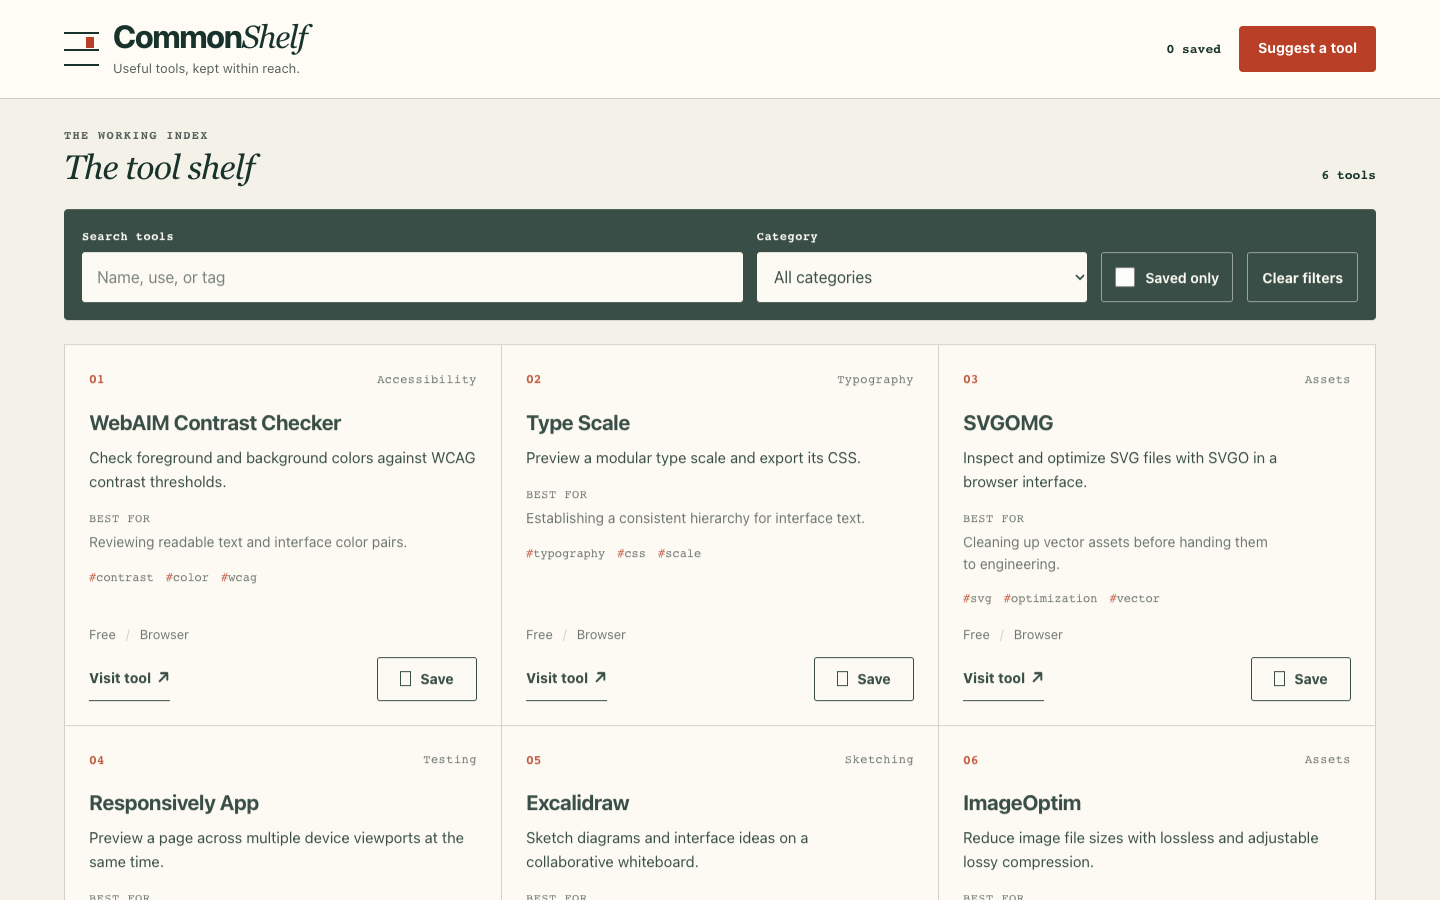
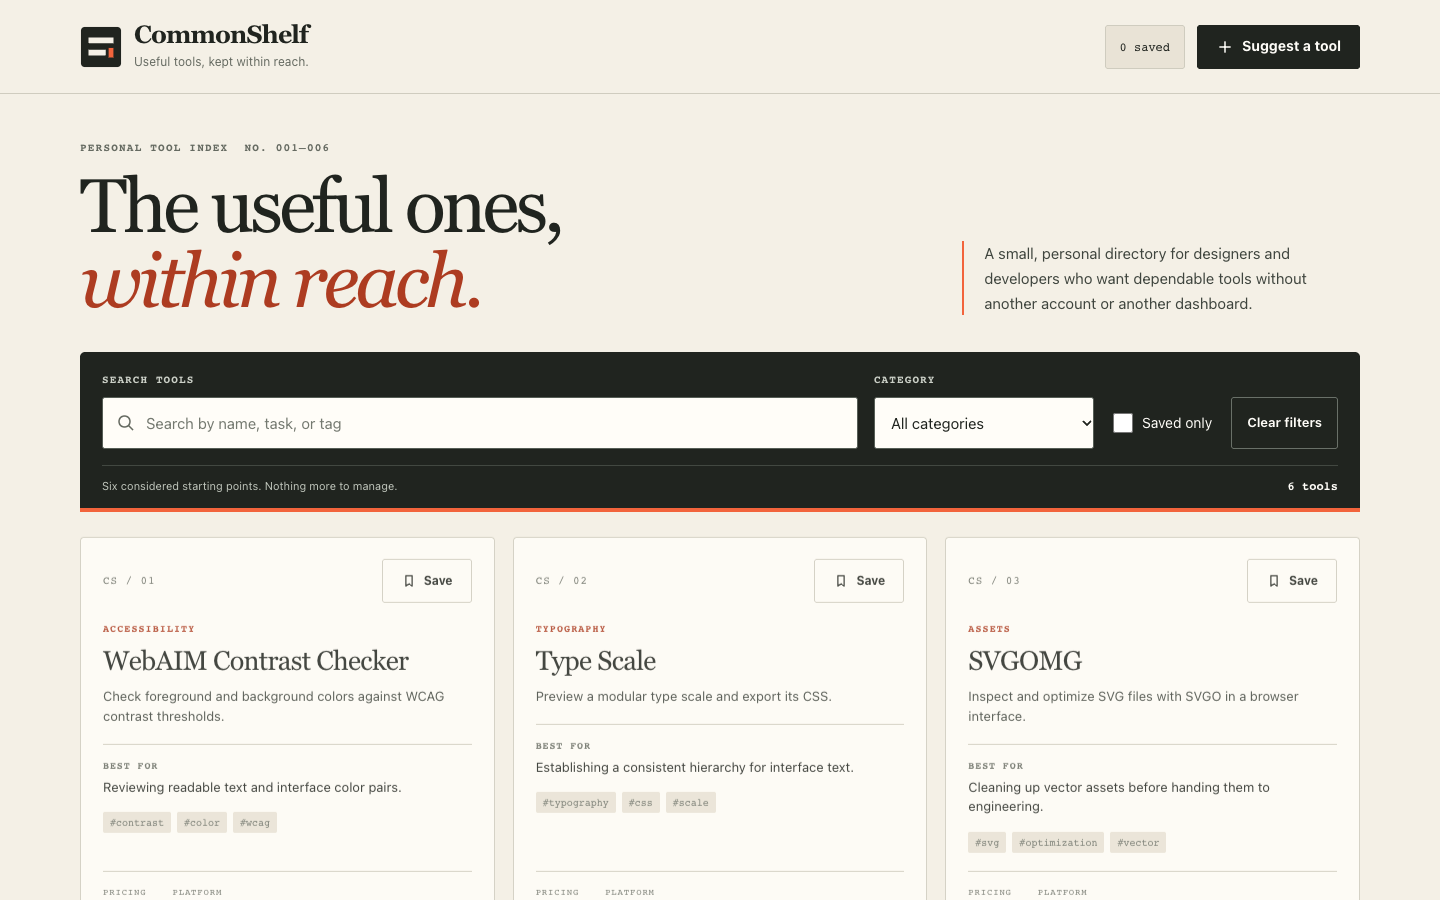
frontend-design: 88.0, kohärente „Work Drawer“-Gestaltung mit wiederholten Akzenten
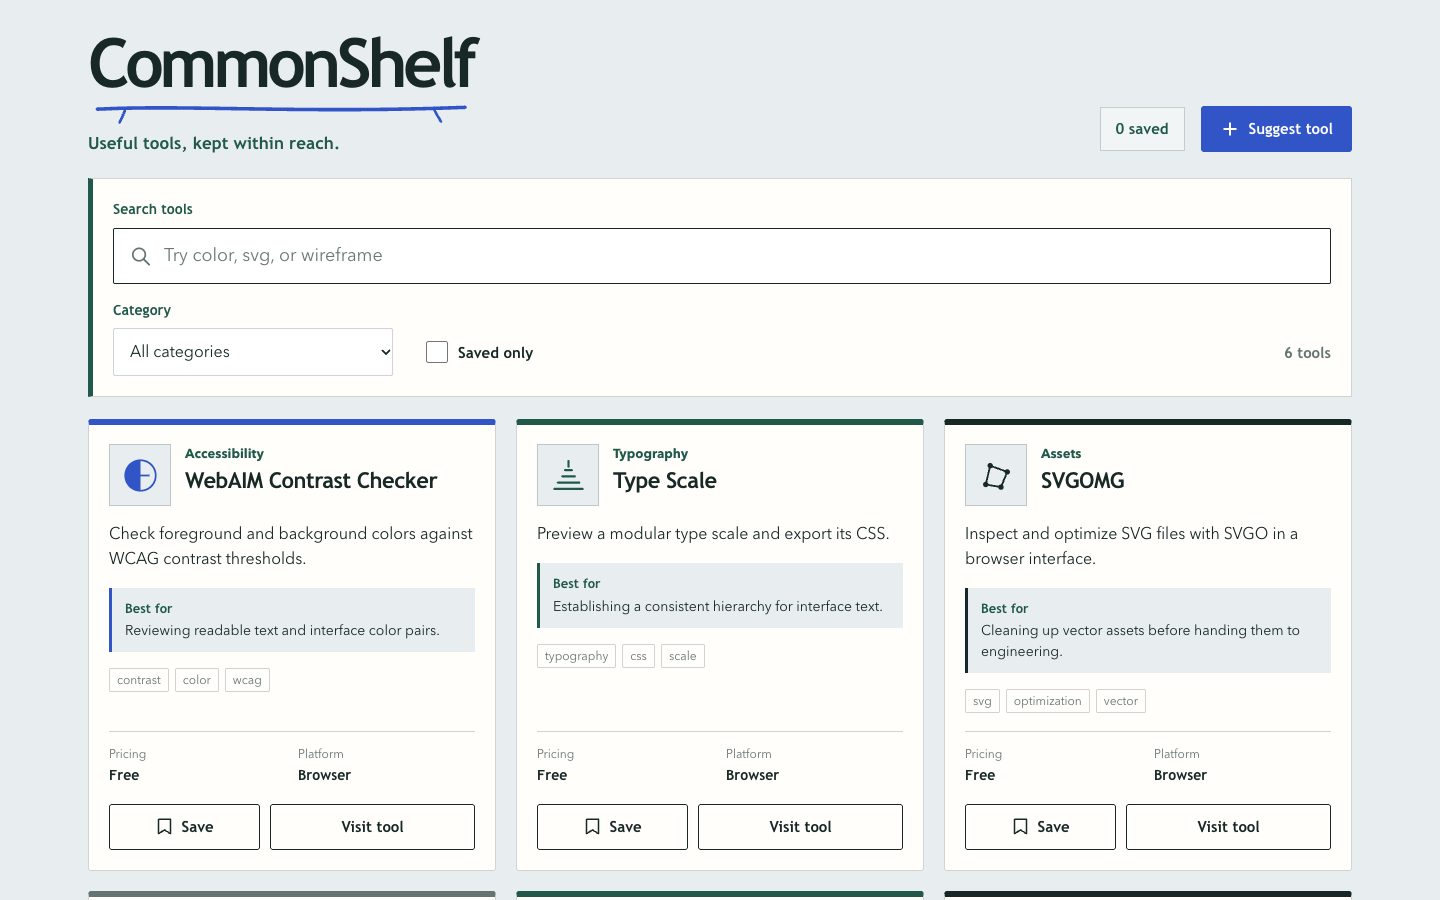
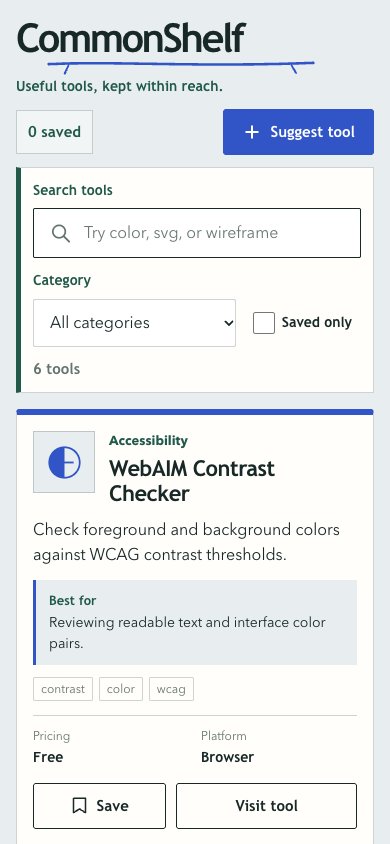
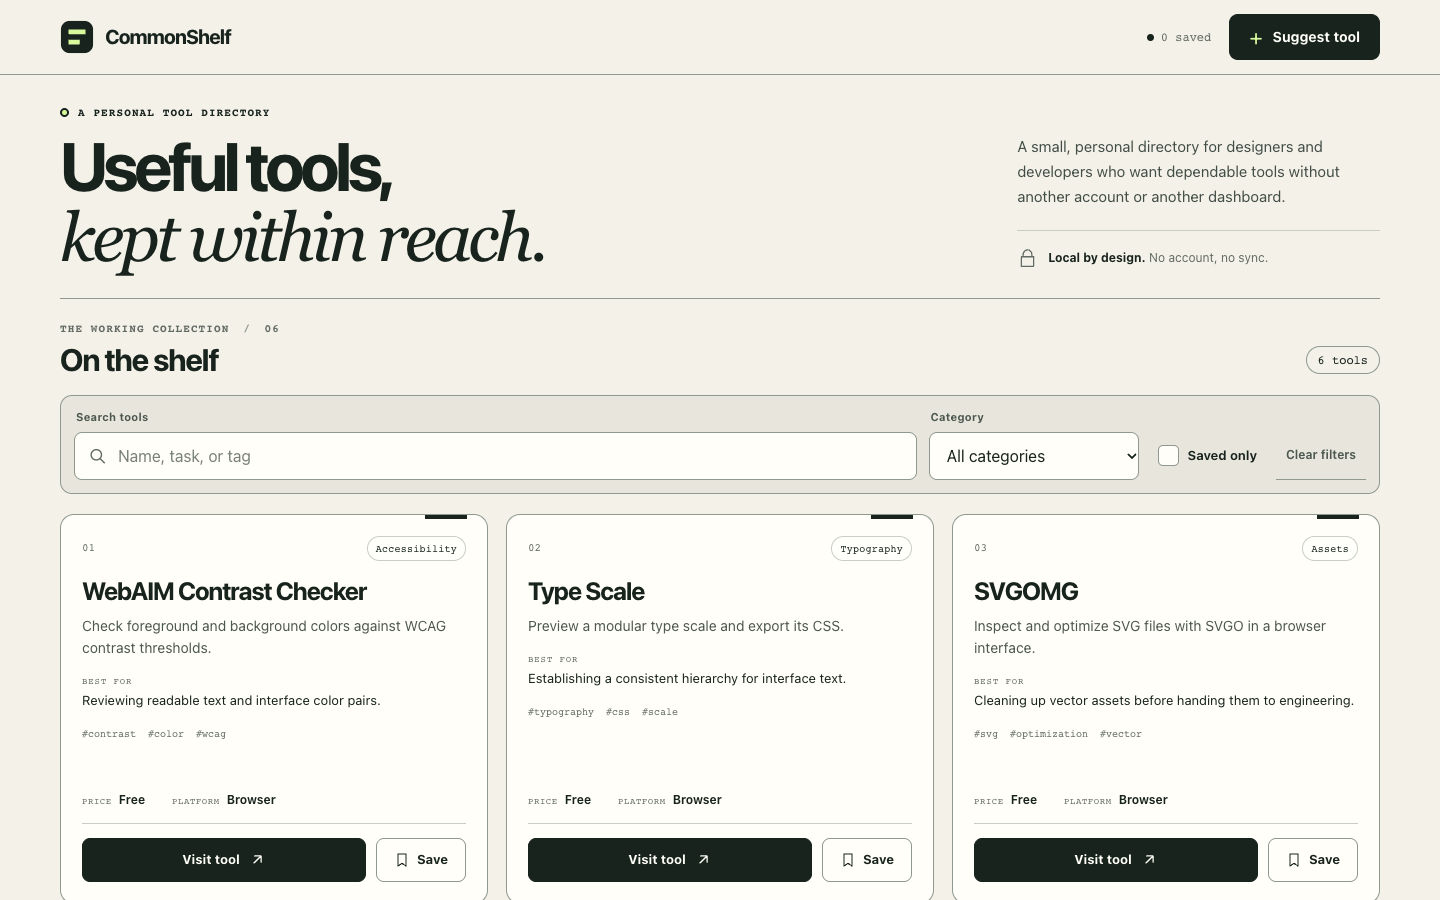
Die visuellen Bewertungen waren 87, 87 und 90; bei jedem Durchlauf wurden 6/6 Funktionsszenarien bestanden. Run-1 gestaltete eine „Arbeitsschublade“ aus kühlen grauen Flächen, Etikettenpapier, handgezeichneten Regallinien, Lesezeichen und unterschiedlichen Werkzeugsymbolen und hielt Zusammenfassungen und Anwendungsfälle im Mittelpunkt. Das Speichern veränderte Text, Lesezeichenfüllung und Flächenfarbe; die erste mobile Karte und die Aktionen des ungültigen Formulars waren vollständig sichtbar.
Run-2 behielt die klare Hierarchie bei, kombinierte jedoch eine 6px-Akzentleiste am oberen Kartenrand, eine kräftige untere Kartenlinie und linke Linien um Filter und Vorschläge, wodurch die Gestaltung visuell schwerer wurde. Der mobile Fehlerdialog platzierte Abbrechen und Speichern unterhalb des anfänglichen Viewports von 844px und erforderte einen Bildlauf. Run-3 wiederholte ebenfalls blaue linke Linien und verwendete kleine Labels und Metadaten. Der Durchschnitt entspricht dem von Impeccable, aber Bildschirme und Schwächen unterscheiden sich.
UI UX Pro Max 2.15.0: 86.7, vollständige Zustände mit Abzügen für mobile Dichte und Aktionspositionen
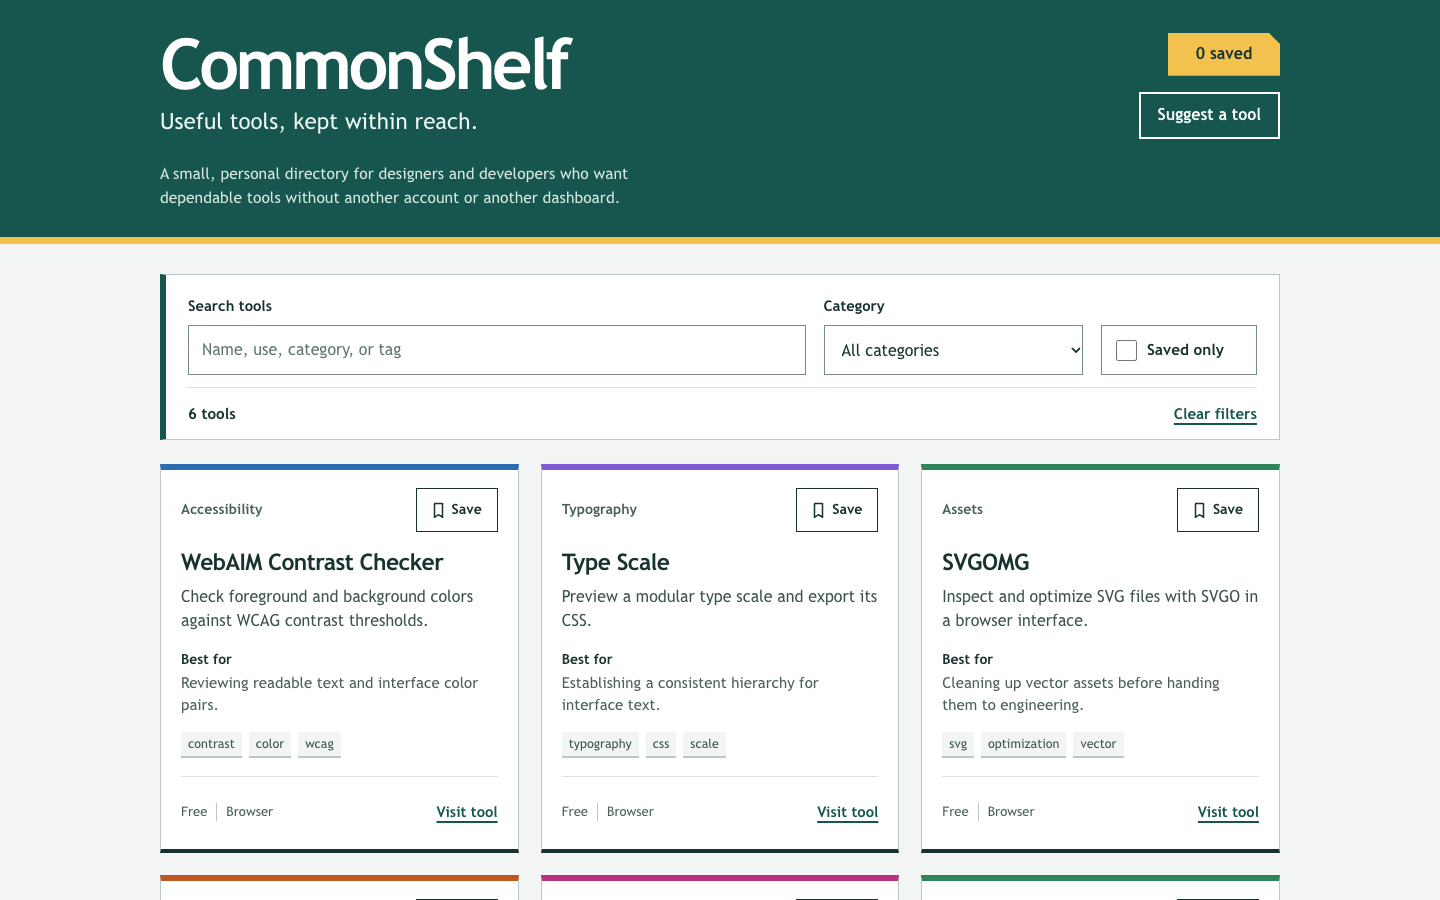
Die visuellen Bewertungen waren 86, 88 und 86; bei jedem Durchlauf wurden 6/6 Funktionsszenarien bestanden. Alle 3 Versionen organisieren die 6 Werkzeuge nach Name, Zusammenfassung, Anwendungsfall, Tags, Preis und Plattform. Das Speichern aktualisiert den Text Save/Saved, das Lesezeichen, den Zähler und den Zustand Saved only. Ladefehler, eingeschränkte Speicherung und Formularfehler haben jeweils einen Weg zur Wiederherstellung.
Run-2 wiederholte eine 4px-Akzentleiste am oberen Rand der Werkzeugkarten und linke Linien bei Vorschlägen und Spezifikationen; häufige Kategorien, Nummern und Tags mit 12px ließen die Gestaltung schematisch wirken. In run-3 begann die erste mobile Werkzeugkarte erst bei etwa 712px, sodass in einem Viewport von 844px nur ihre Oberkante sichtbar war; die gesamte Seite war etwa 4695px hoch. Bei langen Fehlerformularen auf Desktop und Mobilgeräten musste zum Absenden und Abbrechen gescrollt werden; sie bestanden die Abnahme, aber der Abschluss war weniger direkt.
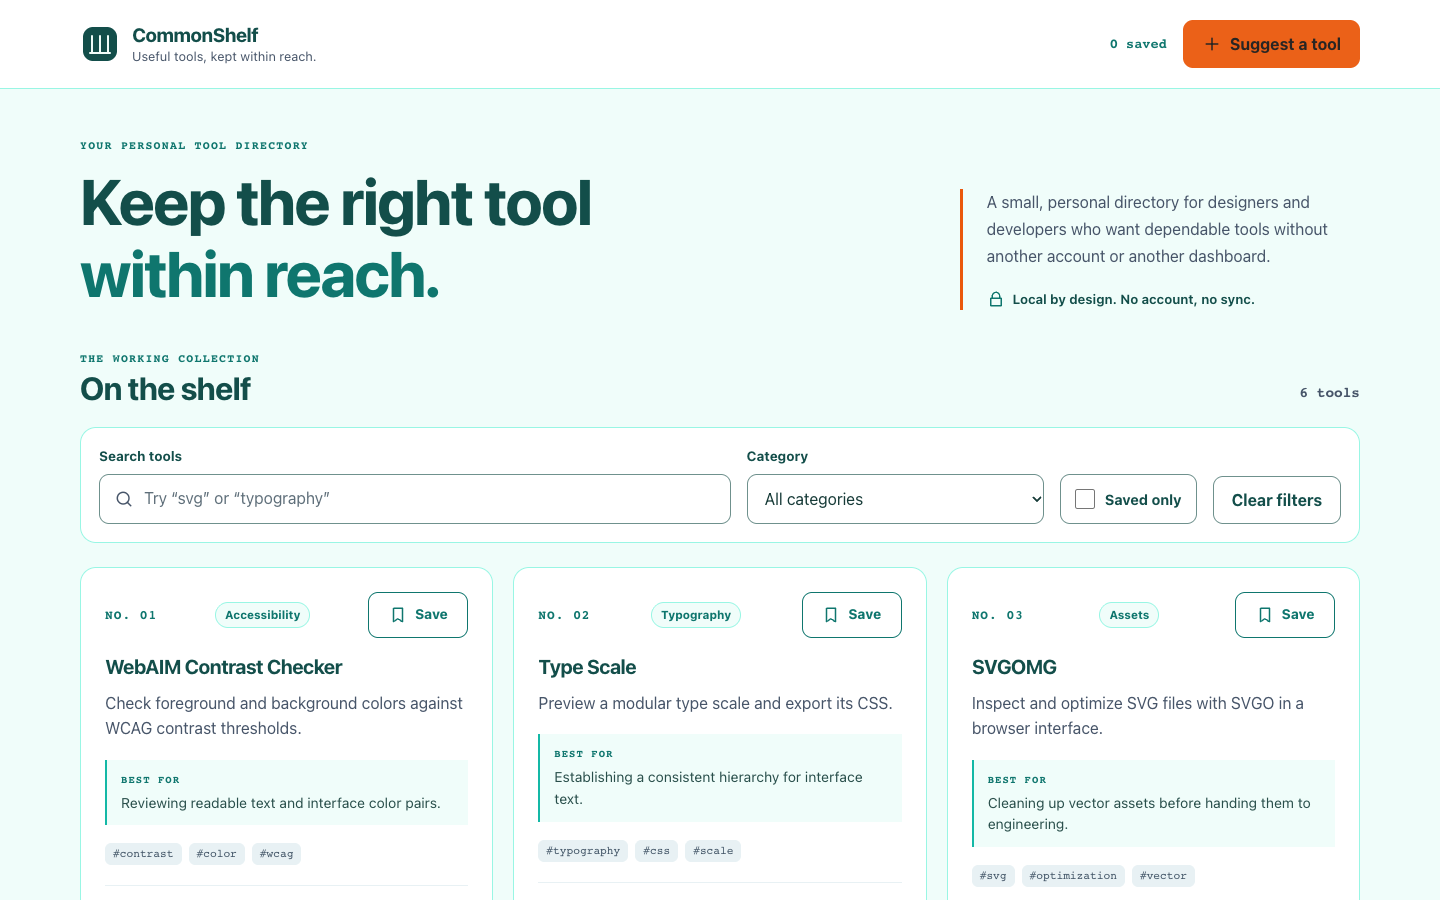
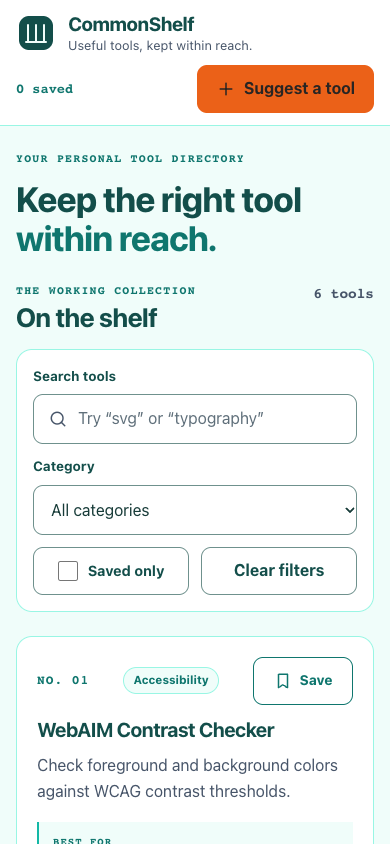
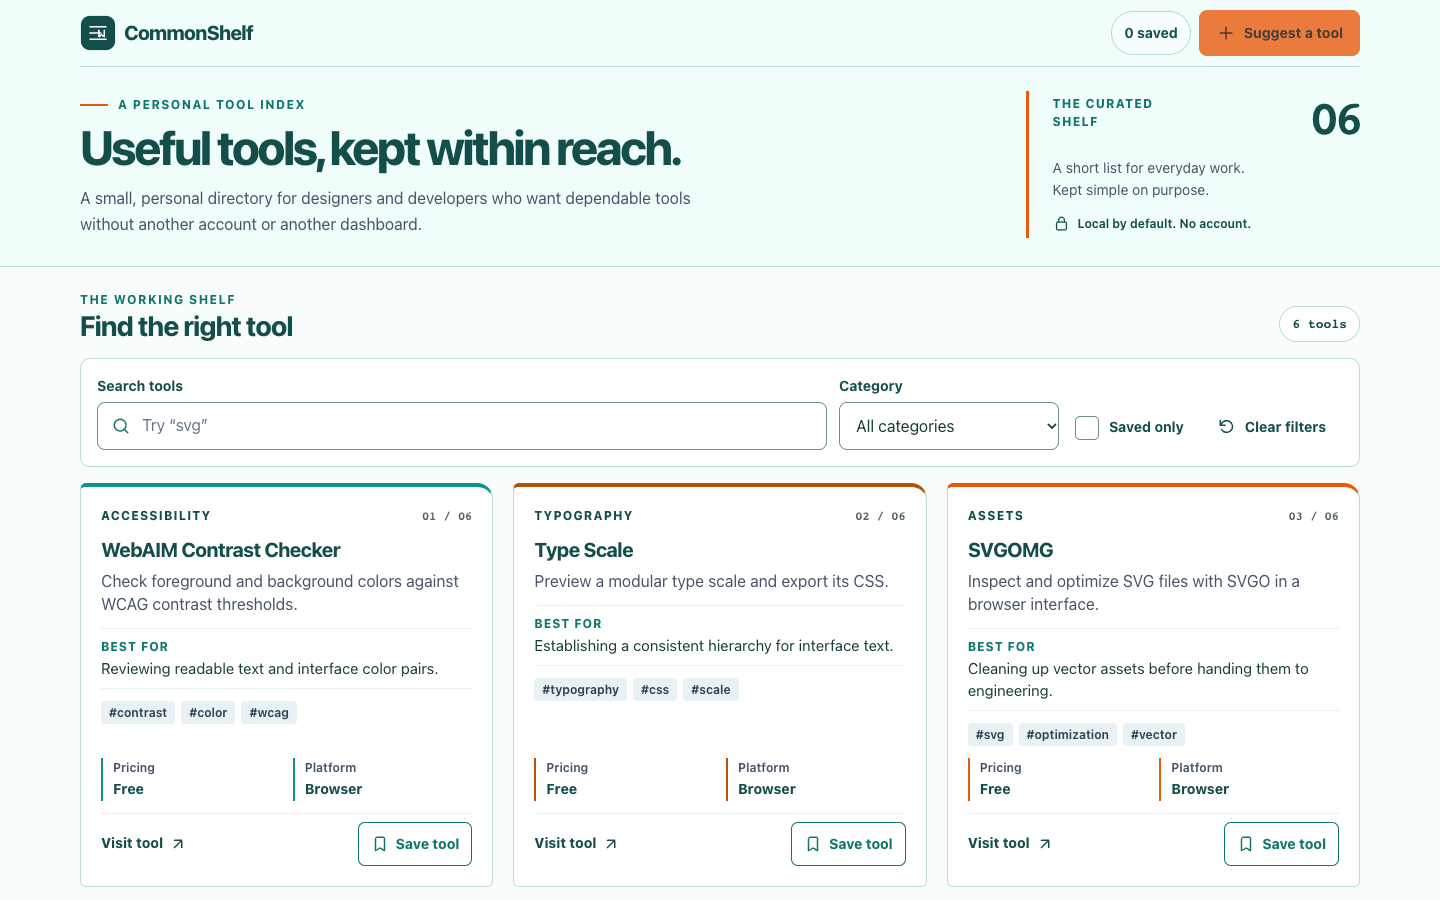
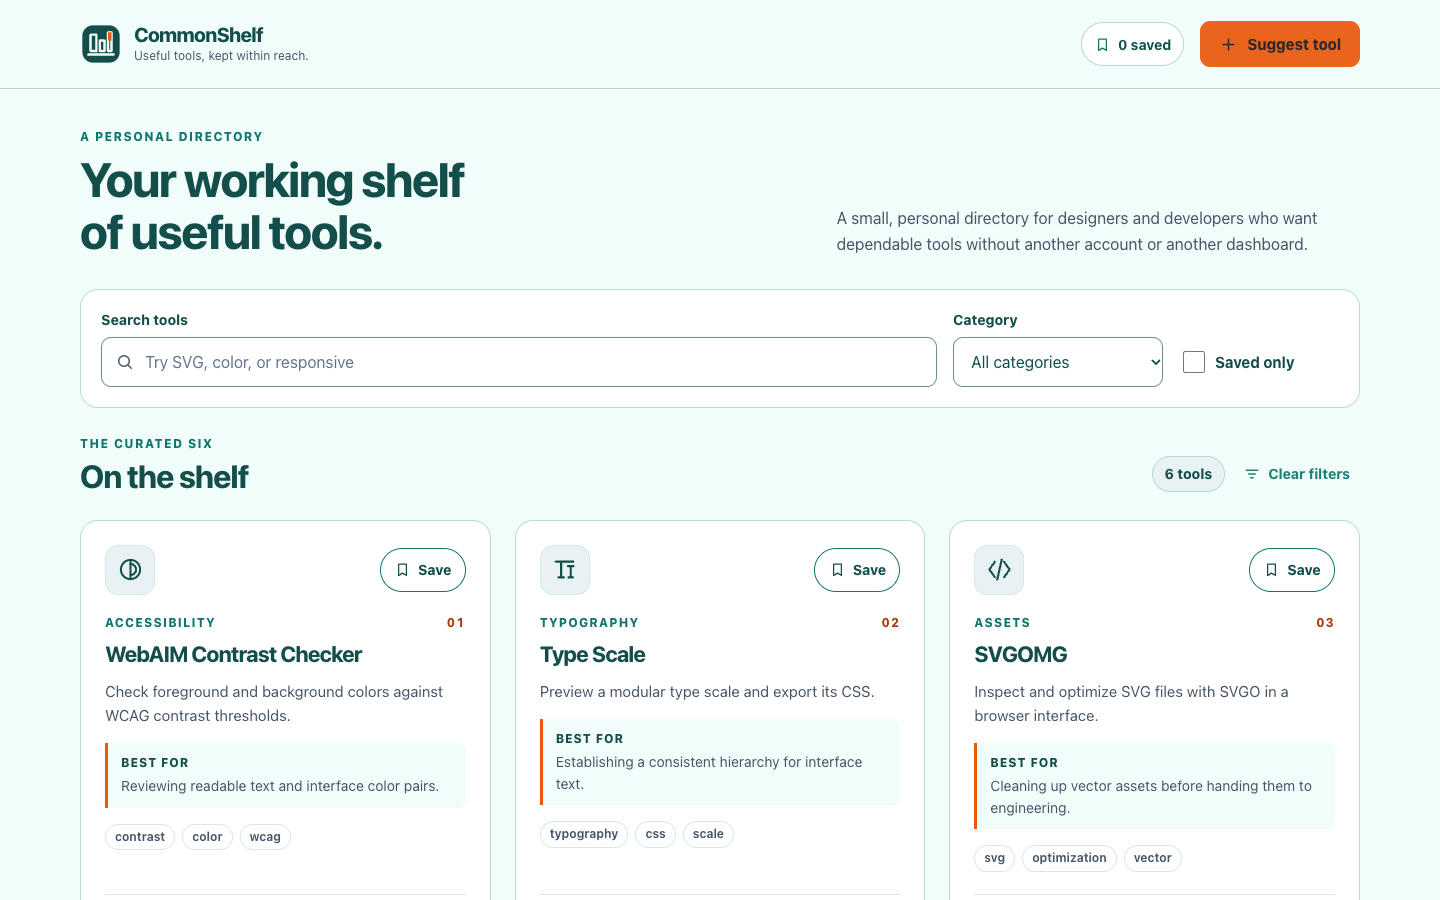
Impeccable 4.7.0: 88.0, Katalogdetails mit Bezug zum tatsächlichen Zustand
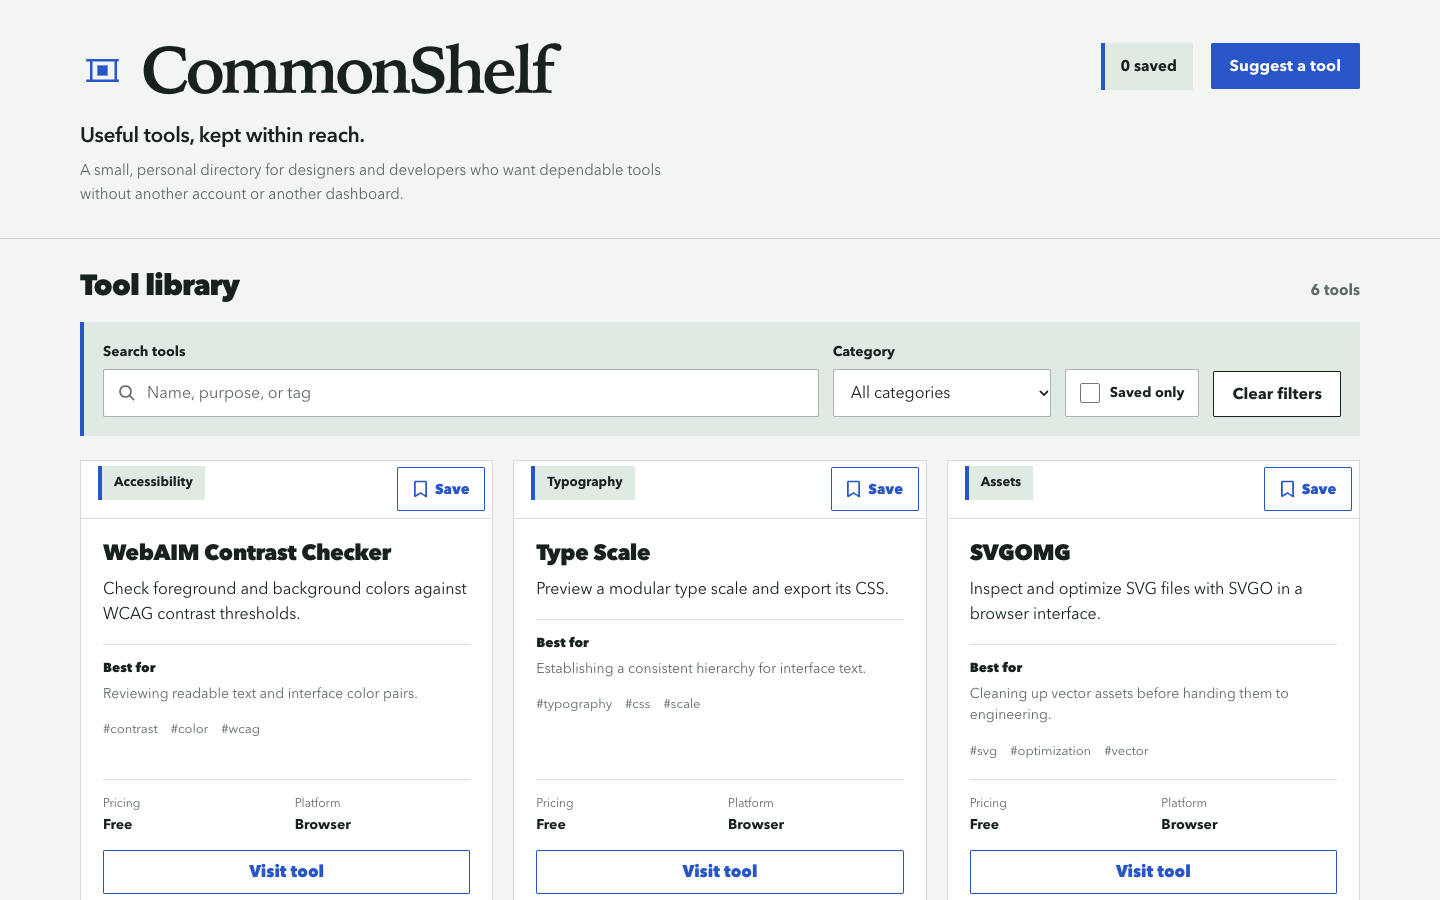
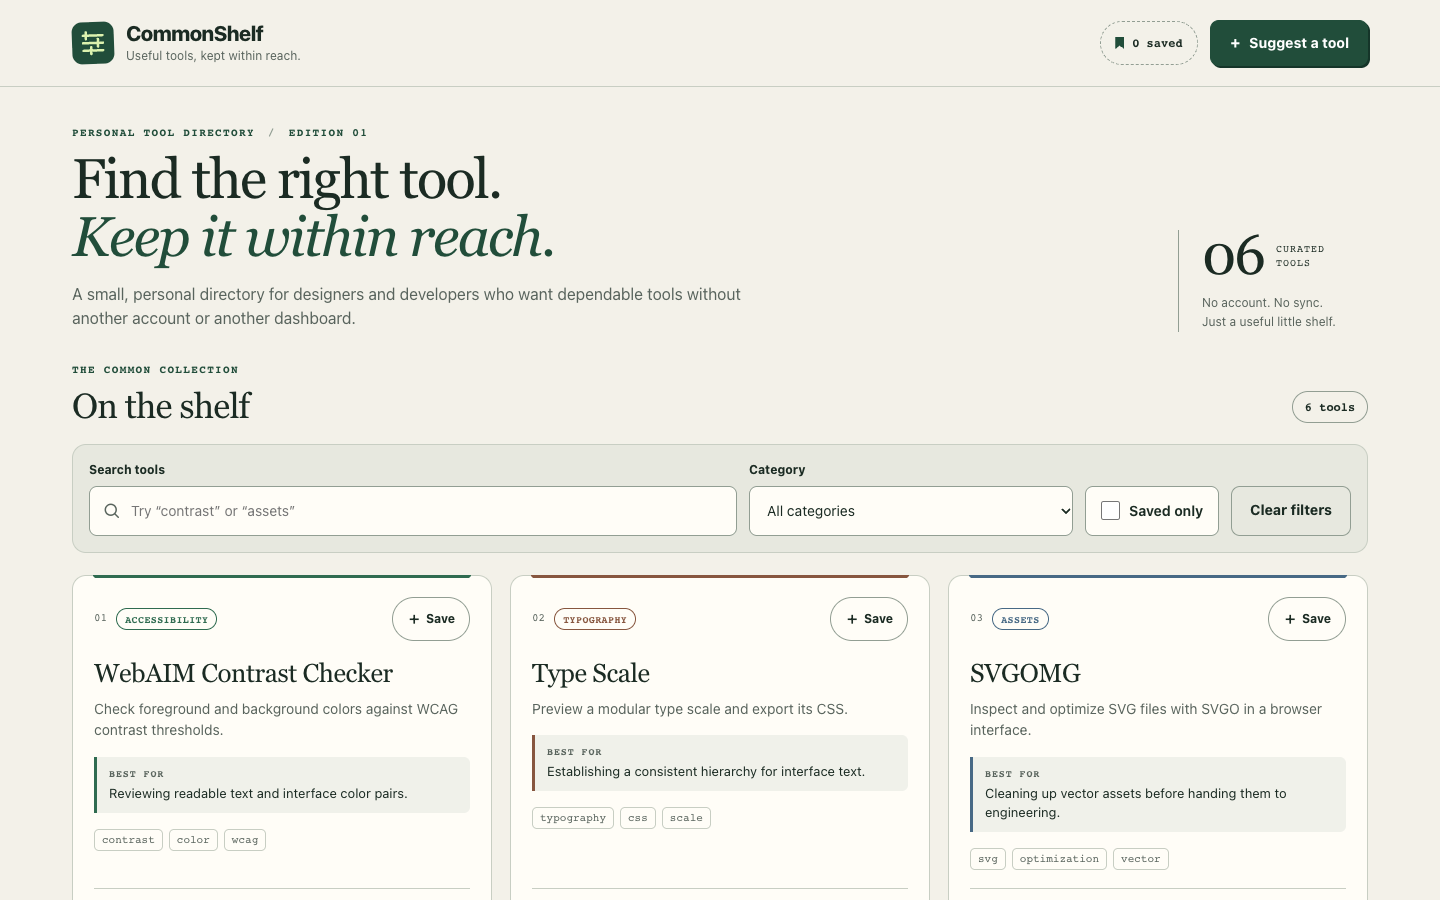
Die visuellen Bewertungen waren 88, 87 und 89; bei jedem Durchlauf wurden 6/6 Funktionsszenarien bestanden. Run-1 verband Perforationen, gestrichelte Linien und Nahtmarkierungen zu einer kohärenten Gestaltung im Stil von Ticketmustern. In run-3 änderte das Catalog register seine Linienstile als Reaktion auf Suche, Speichern und Filtern und verband damit Dekoration mit dem tatsächlichen Zustand. Die Speicherbestätigung kombinierte Text, Markierungen, Füllung oder Rahmen; leere Ergebnisse und Ladefehler boten jeweils eine nächste Aktion.
Abzüge gab es vor allem für Dichte und Abläufe auf kleinen Bildschirmen. In run-1 lagen Zusammenfassungen, Tags und Metadaten bei Karten derselben Reihe mit unterschiedlichen Inhaltslängen nicht auf gemeinsamen Grundlinien, und Metadaten mit 12px waren schwach. Run-2 kombinierte einen hohen Seitenkopf mit mehreren Filterebenen, sodass im ersten mobilen Viewport weniger Werkzeugaktionen Platz hatten und die Seite 3149px erreichte. Auch bei mehreren mobilen Fehlerdialogen musste weiter gescrollt werden, um Abbrechen und Speichern sichtbar zu machen.
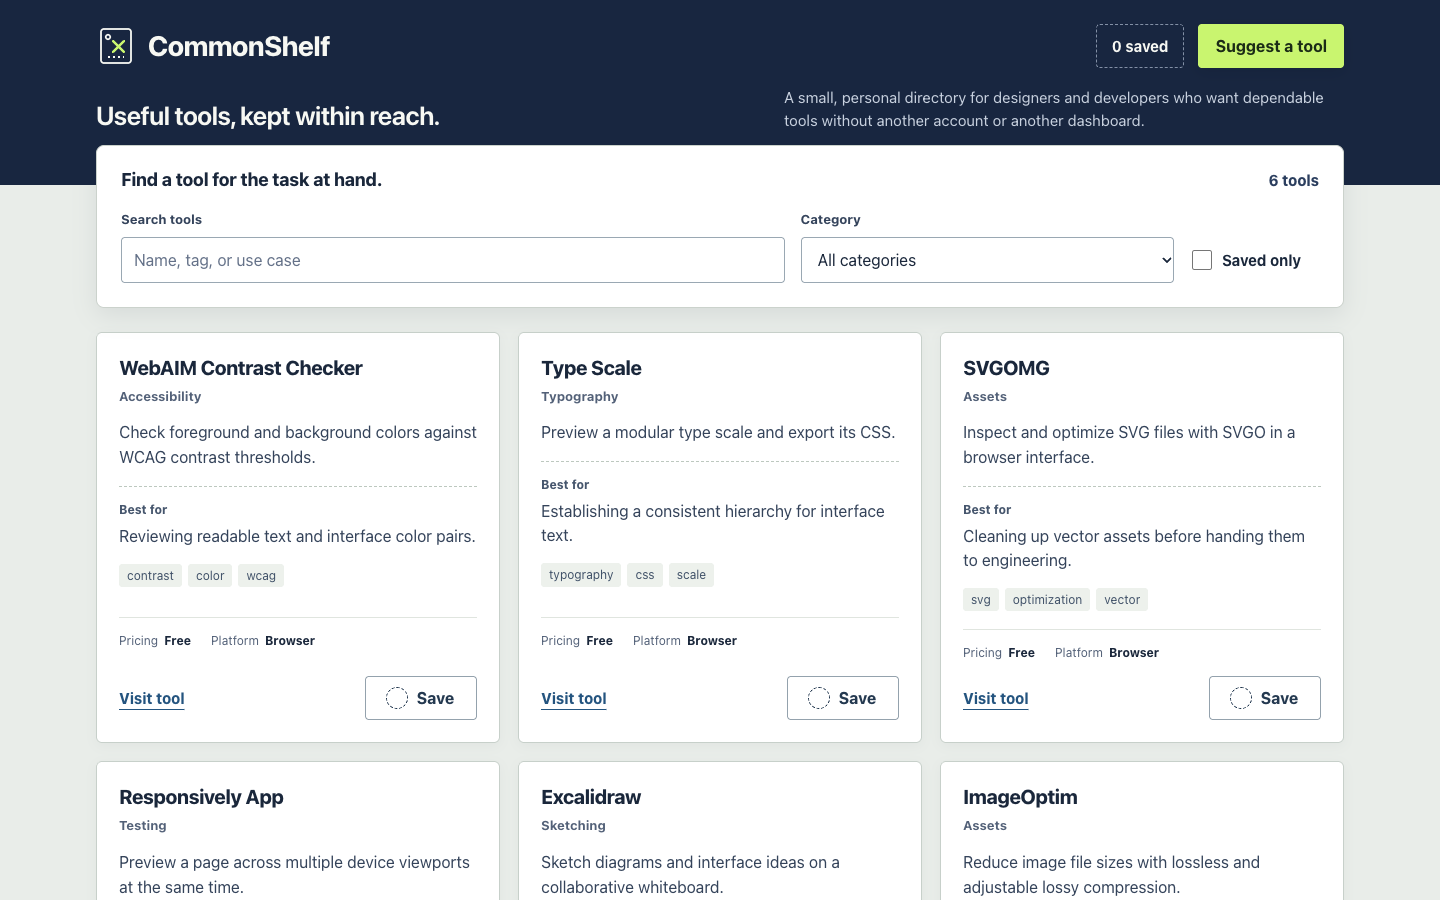
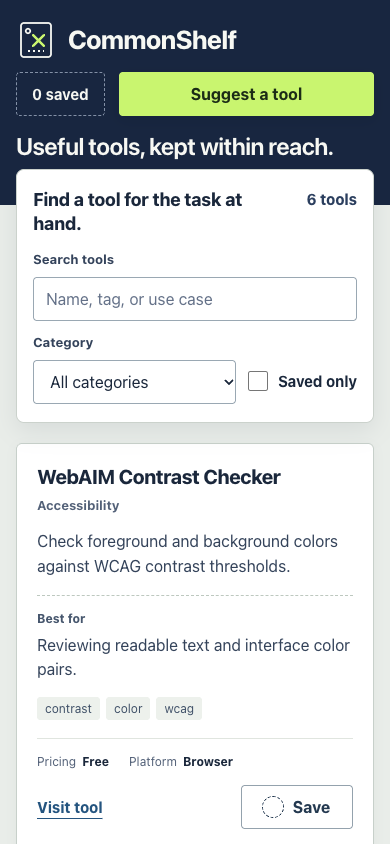
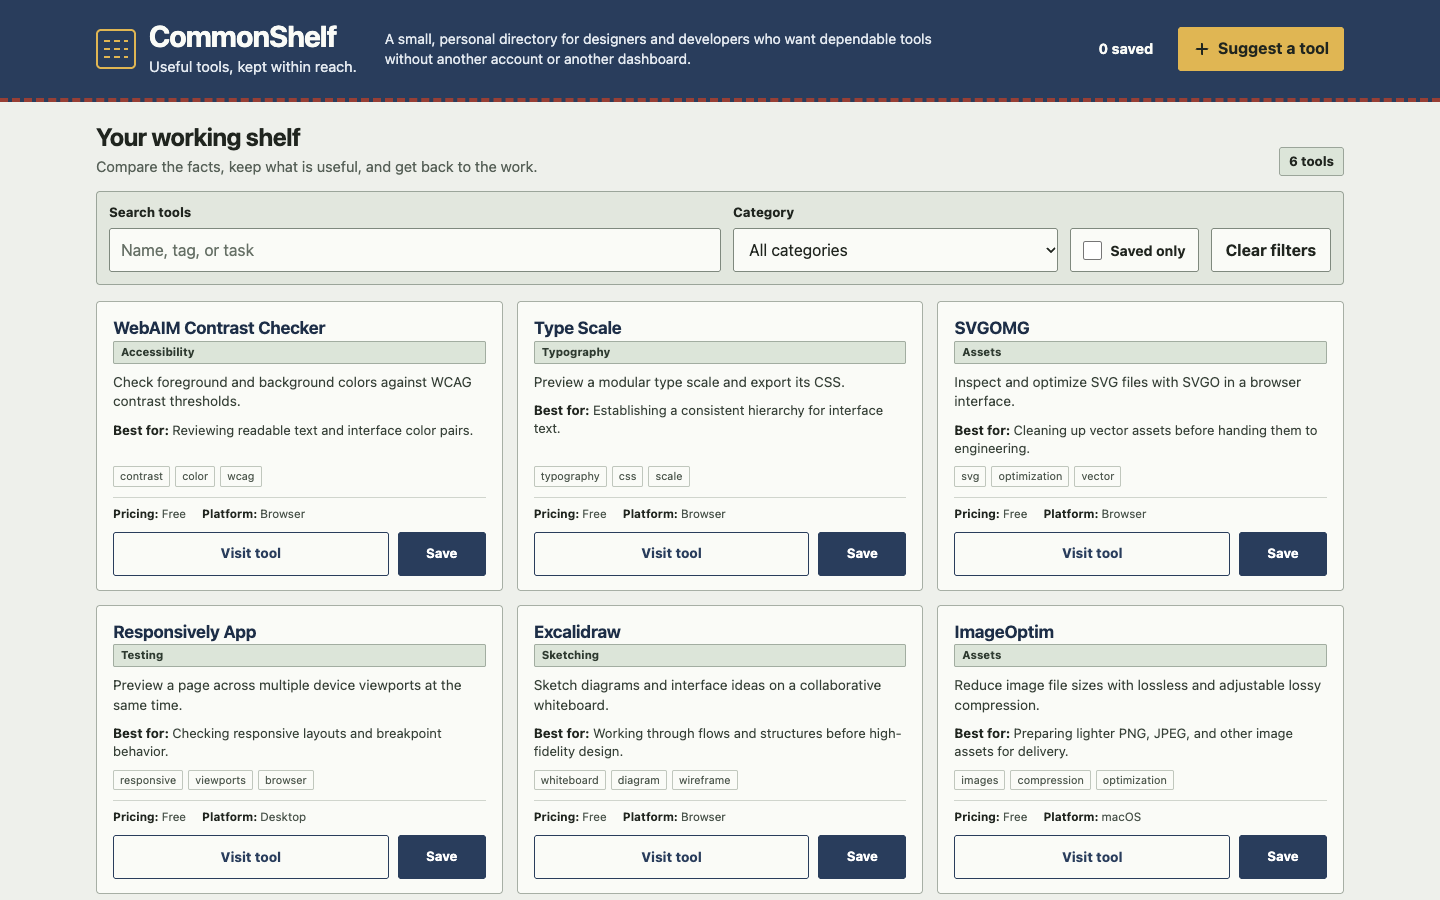
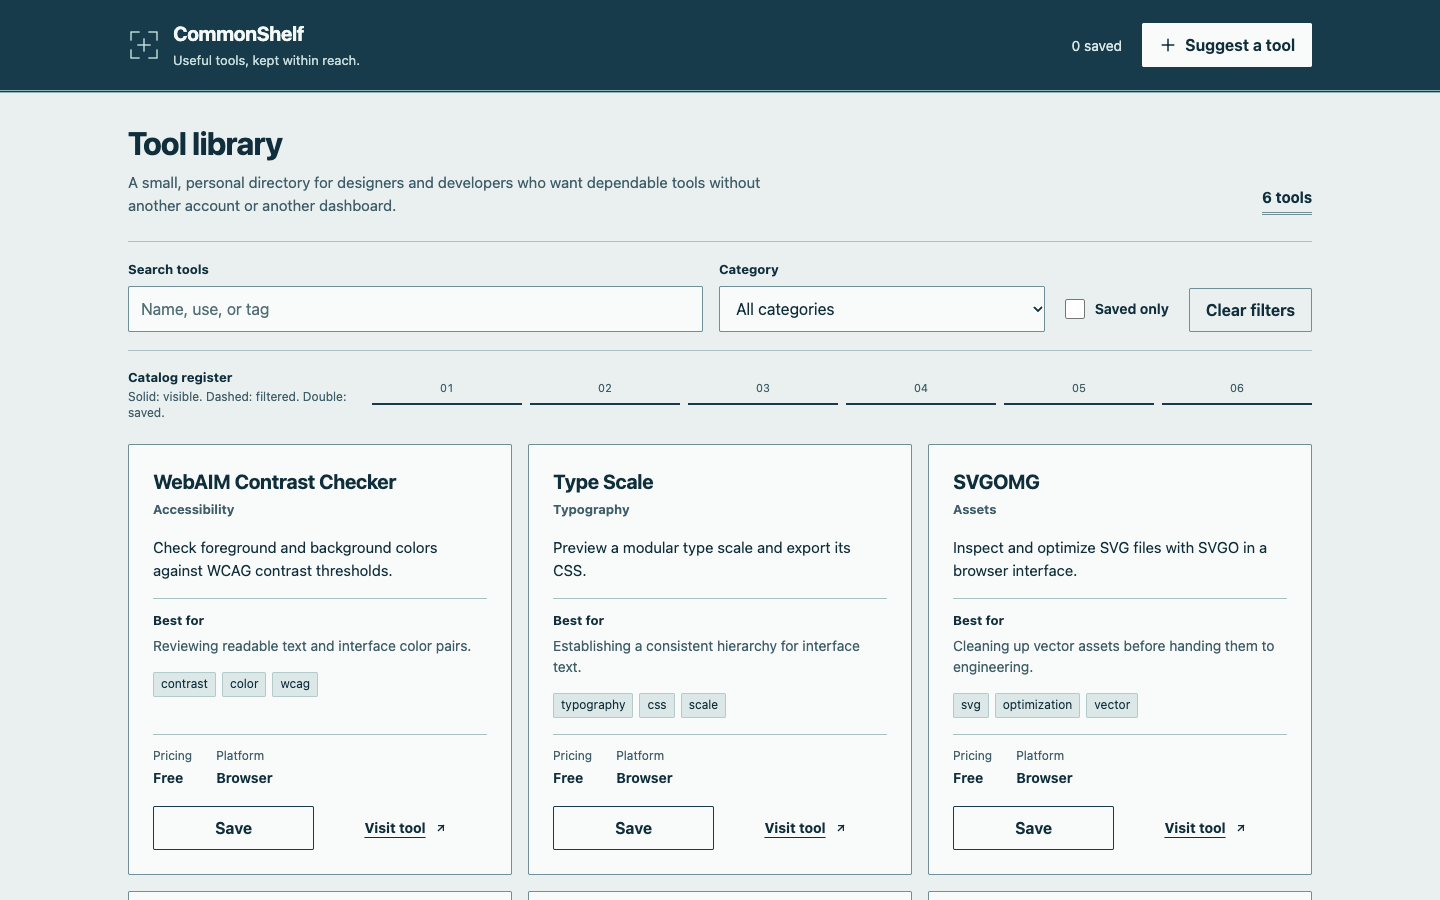
Kontrolle ohne Skill: 84.3, vollständige Oberflächen und 2 weiterhin sichtbare Fehlschläge
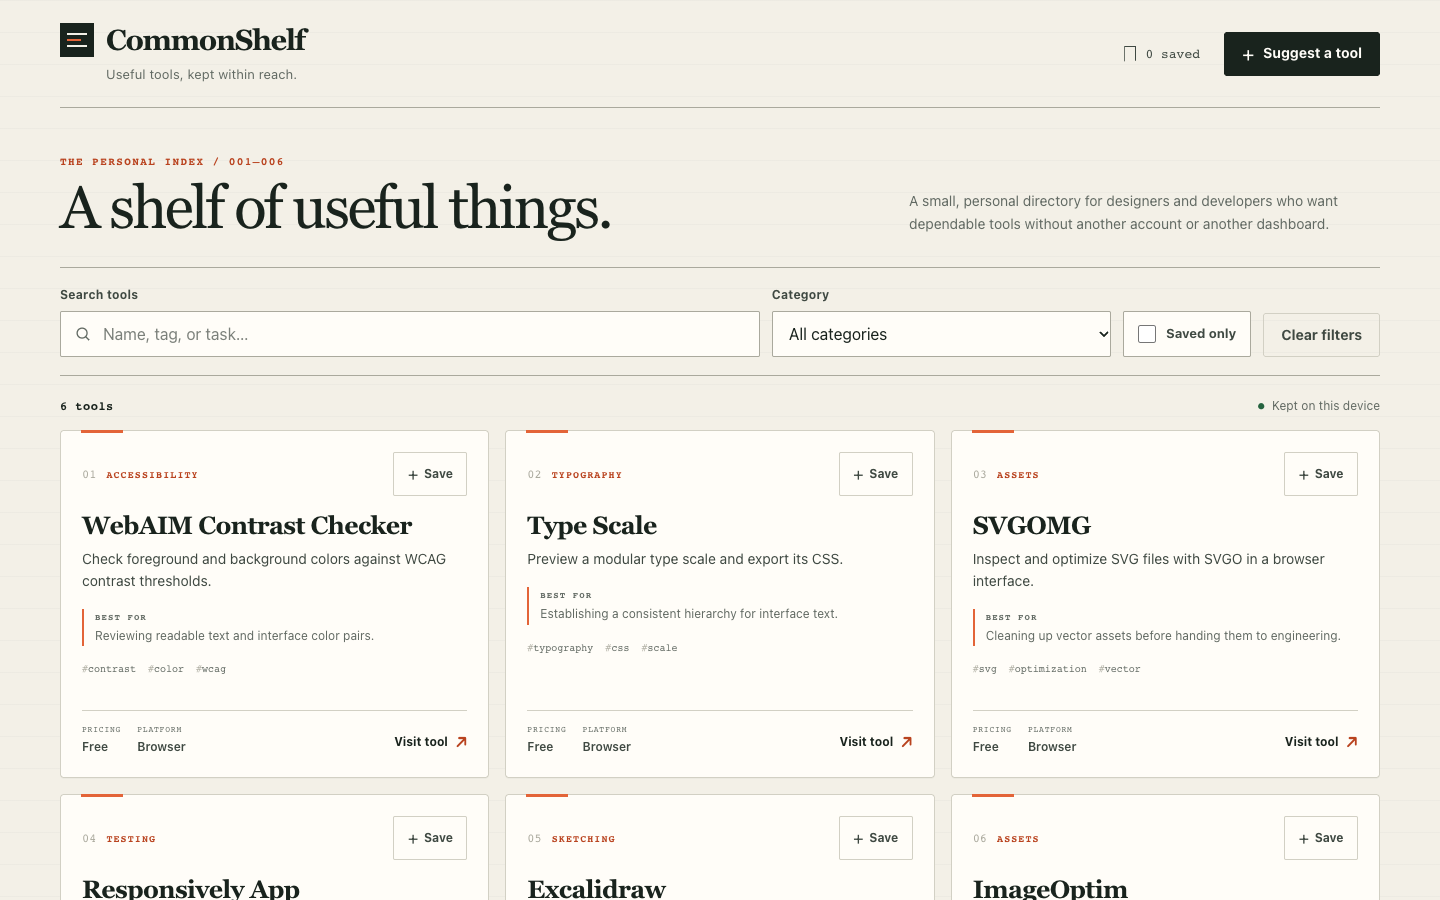
Die visuellen Bewertungen waren 83, 86 und 84. Warmes Papier, Nummerierung und Indexlinien bildeten kohärente Werkzeugkataloge mit weitgehend klaren dreispaltigen Desktop- und einspaltigen mobilen Layouts; das Speichern und leere Zustände nutzten häufig mehr als nur Farbe als Rückmeldung. Das zugrunde liegende Modell kann bereits ohne Skill vollständige Oberflächen erzeugen; Bewertungen brauchen daher konkrete Vergleiche statt der Annahme eines Nullpunktestands.
Run-1 und run-3 scheiterten bei interaction-and-persistence jeweils an der exakten Toast-Textprüfung: Der Vertrag erwartete „Suggestion saved.“, während der tatsächliche Text ein Häkchen und Leerraum hinzufügte. In run-3 war dieses Häkchen im HTML als aria-hidden markiert. Das Ergebnis beweist daher nicht, dass Vorschläge oder Persistenz vollständig defekt waren. Nach dem festgelegten Vertrag bleiben beide Durchläufe jedoch failed mit 5/6, und Schritte nach der fehlgeschlagenen Prüfung dürfen nicht als abgenommen gezählt werden.
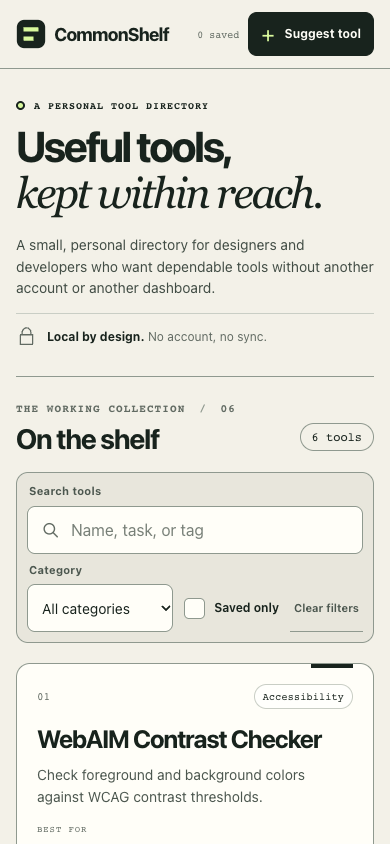
Hilfstext war wiederholt zu klein oder zu blass. In run-3 ergaben Stichproben der Farbwerte schwache Kontraste für Werkzeugnummern und Platzhalter; von den unteren Aktionen des mobilen Fehlerdialogs war anfangs nur die Oberkante sichtbar. In run-1 nahmen Einleitung und Filter den größten Teil des ersten mobilen Bildschirms ein.
Anhang | Oil UI 0.24.2: ein Nachtest des unabhängigen Optimierungskandidaten
Dieser Anhang behandelt einen Nachtest eines unabhängigen Optimierungskandidaten auf Basis von Oil UI 0.24.2, erneut mit Kimi AgentSwarm und kimi-1021-preview. Der Kandidat ist kein offizielles Release, liegt außerhalb der ursprünglichen Stichprobe von 15 Durchläufen und verändert oder ersetzt diese Ergebnisse nicht; ein Versuch belegt keine allgemeine Verbesserung.
Die unabhängige Funktionsabnahme bestand 6/6 Szenarien, die erweiterte Prüfung fortlaufender Interaktionen bestand 2/2 über 11 Kontrollpunkte. Die beiden unabhängigen Prüfer im Blindreview gaben 89 und 90 Punkte, im Mittel 179/2 = 89.5. Sie führten Playwright nicht erneut aus; Funktionsnachweise und visuelle Bewertungen bleiben getrennt. Direkte Belege umfassen nur Chromium bei 1440×900 und 390×844; echte Smartphones, alle Breakpoints, andere Browser und vollständige Barrierefreiheitsprüfungen sind nicht abgedeckt.
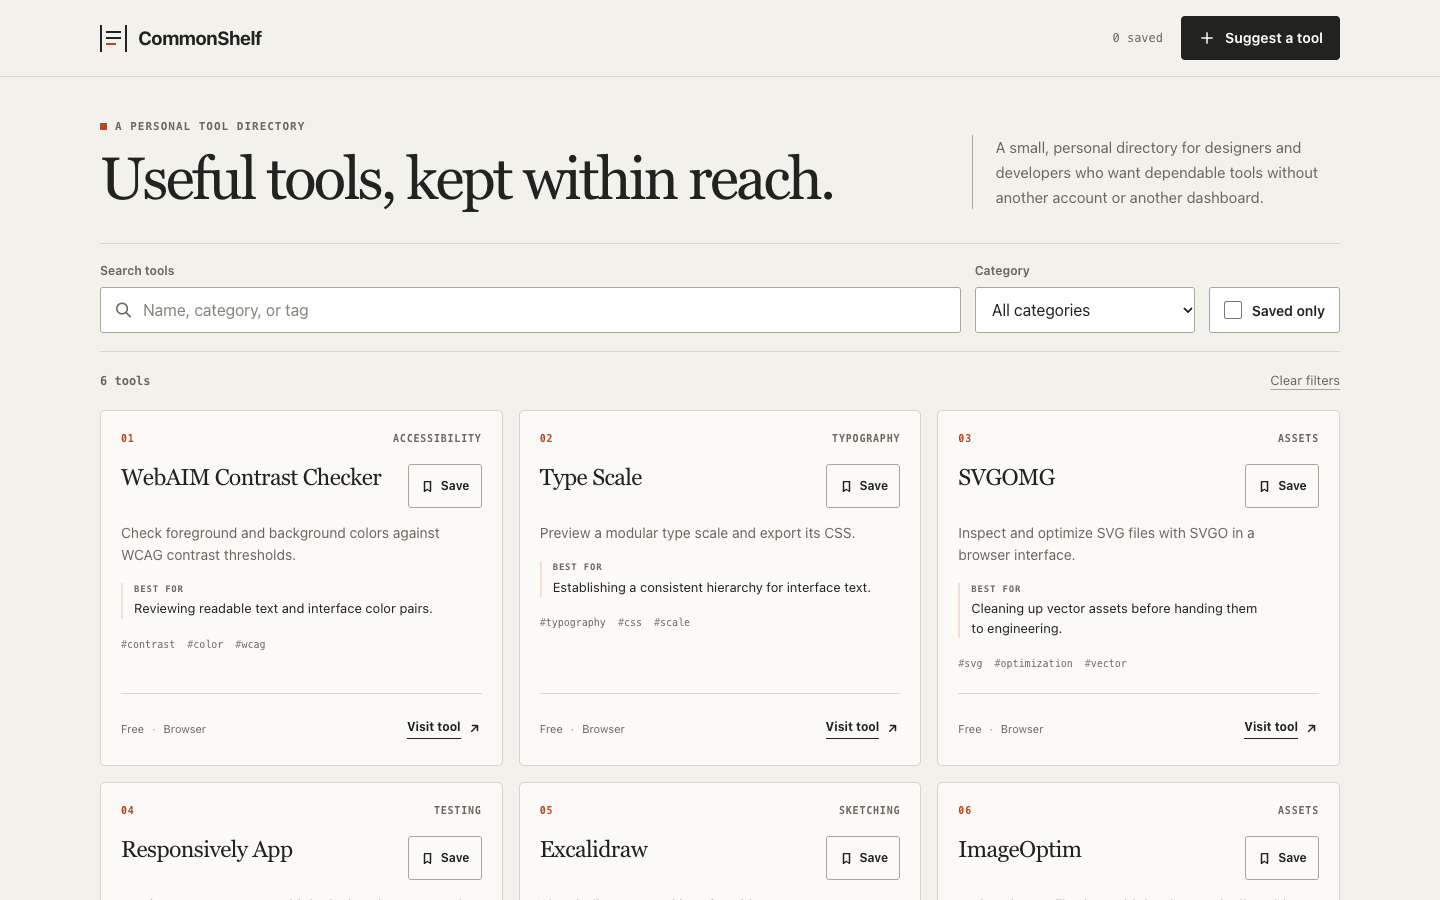
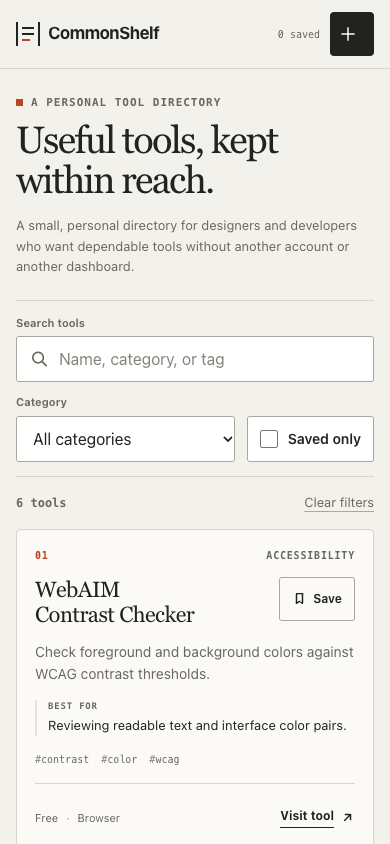
- DOM und Bewegung: keine erneute Listenanimation bei fortlaufender Nutzung oder Wiederherstellung beobachtet
- Bei allen 11 fortlaufenden Kontrollpunkten wurde für erhaltene Karten sameOriginalNode=true aufgezeichnet, statt den vollständigen Kartensatz neu aufzubauen. Die animationstart-Aufzeichnungen für Karten und Vorschläge waren leer, und beide Prüfer sahen das Video der fortlaufenden Interaktion. Eine lokale CSS Transition auf dem Speicherbutton wurde separat erfasst, nicht als Wiederholung der Listenanimation. Nach der Aktualisierung hatten alle 6 wiederhergestellten Karten und der Vorschlag cssAnimations=0, restoreAnimationStarts war leer, und Speicherstatus und Vorschlagsinhalt wurden wiederhergestellt.
- Mobile Aktionen und visuelle Hierarchie
- Bei 4 Fehlern im Viewport 390×844 waren die Buttons zum Abbrechen und Absenden jeweils 48px hoch; ihre Unterkante lag bei 819px und damit innerhalb des Viewports. Beide Aktionen wurden als echte Touch-Klicks ausgeführt, und die korrigierte Übermittlung blieb nach einer Aktualisierung erhalten. Beide Prüfer im Blindreview bestätigten, dass Dialog und Fehlerzusammenfassung keine kräftige Akzentleiste am oberen Rand hatten; ihre Hierarchie blieb dennoch klar.
- Alte Fehler, kleine Schrift und Placeholder-Kontrast bleiben offene Punkte
- Nachdem Felder korrigiert wurden und vor der nächsten Übermittlung blieben die alte Fehlerzusammenfassung und die Fehler auf Feldebene sichtbar. Das entspricht der Validierung beim Absenden und ist kein Funktionsfehler, schwächt aber die Aktualität der Rückmeldung. Einige Hilfstexte blieben 9–11px klein. Prüfer A maß den Kontrast des Placeholder-Textes in Eingabefeldern mit ungefähr 3.76:1 und damit unter der Referenz von 4.5:1 für normalen Text; dies war eine lokale Punktmessung, keine vollständige Kontrastprüfung.
Grenzen: was diese Belege zeigen und was nicht
Der Test umfasst ein englisches statisches CommonShelf-Briefing, ein Modell und 3 endgültige Stichproben pro Bedingung. Die Regel mit 6 Dimensionen enthält weiterhin Urteilsleistung: Ein Review entspricht einem anonymisierten Paket, nicht einer groß angelegten Nutzerstudie oder einem Experiment auf statistische Signifikanz. Eine andere Aufgabe, Inhaltssprache, ein anderes Framework oder Modell könnte das Ergebnis verändern.
Die Funktionsabnahme umfasste 6 vordefinierte Chromium-Szenariogruppen, keine vollständige Produktprüfung. Für gewöhnliche Tablet-Layouts lagen Stylesheet-Belege, aber keine eigenen Screenshots vor. Safari, Firefox, echte Touch-Geräte, Screenreader, 200% Zoom und vollständige WCAG-Prüfungen wurden nicht durchgeführt. Statische Screenshots können den zeitlichen Verlauf kontinuierlicher Animationen nicht beschreiben: Die transparenten Frames in Oil UI run-3 belegen ein Feedbackproblem, aber nicht die Qualität des stabilen Frames nach der Animation.
Die öffentlichen Demos bewahren die tatsächlichen Seiten nach der Generierung und die Funktionsfehler. Technische Unterbrechungen und Wiederherstellungen innerhalb des Protokolls wurden nicht als Funktionsfehler der Kandidaten gezählt und nicht zum Vergleich der verstrichenen Zeit verwendet; sie sind von der unabhängigen Abnahme nach der Generierung zu unterscheiden.
Reproduzieren: Belege prüfen und anschließend selbst vergleichen
Nutze die 15 Demos, 20 Ausgangsbilder und results.json oben, um diesen Artikel zu prüfen. Für einen vergleichbaren neuen Durchlauf behalte Briefing, fixierte Versionen und Modell bei, starte jedes Mal einen neuen Agenten, bewahre alle 3 Ergebnisse und führe nach der Generierung eine unabhängige Abnahme durch. Die öffentliche Inhaltsdatei ist Byte-identisch mit der Kopie in der Demo. Der folgende Prompt ist ein gekürztes Briefing für einen neuen Durchlauf, nicht die ursprüngliche eingefrorene Aufgabendatei.
Der Open-Source-Installationsbefehl installiert die Version, die beim Ausführen aufgelöst wird, nicht unbedingt 0.24.2. Halte für einen strengen Vergleich die installierte Version fest und verwende die fixierten Commits aus der Tabelle. Behandle eine neuere Version als neuen Test, statt diese Zahlen zu überschreiben.
Oil UI Open Source installieren und Version festhalten
Probiere den Open-Source-Skill zuerst an deiner eigenen Aufgabe aus. Oil UI Pro wurde in diesem Vergleichstest nicht verwendet.
npx skills add oil-oil/oil-ui3 unabhängige Generierungen pro Bedingung ausführen
Halte Modell und Inhaltsdaten konstant. Starte jeden Durchlauf mit einem neuen Agenten und Arbeitsbereich, liefere nur eine Richtung und importiere oder repariere niemals die Seite eines anderen Durchlaufs; ersetze auch kein schwächeres Ergebnis.
Funktionsabnahme und anonymes visuelles Review trennen
Prüfe die 6 Szenariogruppen bei 1440×900 und 390×844 und bewahre jedes Bestehen und jeden Fehlschlag. Verbirg die Identität der Bedingungen für das visuelle Review, wende dieselben 6 Dimensionen an und veröffentliche jedes Ergebnis statt nur der Durchschnittswerte.
Build one complete CommonShelf static web app with plain HTML, CSS and JavaScript. Use the supplied content.json unchanged. Make one coherent direction without asking for a selection. At 1440×900 and 390×844, the first viewport must help a visitor find, understand and save tools. Implement combined search, category and saved-only filters; local-storage saves; a validated suggestion dialog; exactly three keyboard-operable FAQ items; actionable content-unavailable and storage-unavailable states; visible focus; and reduced motion. Keep suggestions outside the curated tool grid. Make no external requests except user-activated official links. Do not import another run or replace a weak result. Preserve every failure, then independently verify the actual page and review anonymized screenshots and runtime files.Dies ist ein gekürztes Briefing für einen vergleichbaren neuen Durchlauf. Eine strenge Reproduktion erfordert außerdem die oben fixierten Versionen, die 6 Abnahmeszenarien und dieselbe Bewertungsregel.
Funktionierende Beispiele und Prompts aus der Galerie
Öffne die Live-Demos bei 1440 px oder 390 px und untersuche, wie Modell und Prompt die fertige Oberfläche geprägt haben.
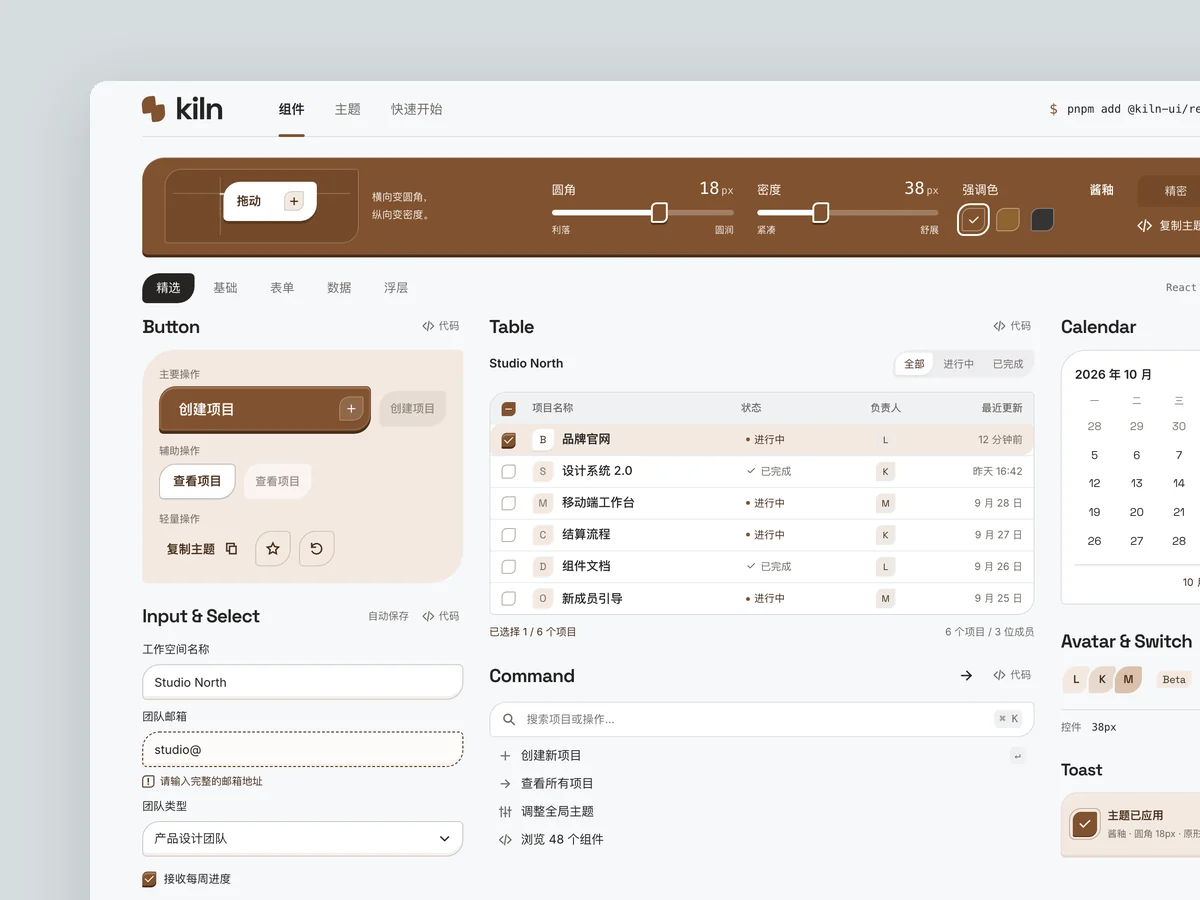
Kiln
Website einer Komponentenbibliothek
Produkt: Kiln, eine quelloffene Komponentenbibliothek für React-Entwickler mit mehr als 40 Komponenten, darunter Schaltflächen, Eingaben, Dropdowns, Befehlspaletten, Dialoge, Tooltips, Tabellen und Datumsauswahlen. Sie unterstützt individuelle Themes. Erstelle ihre Website-Startseite, optional mit einer Komponentendetailseite: - Zeige echte interaktive Komponenten direkt auf der Startseite statt Screenshots. Eine „Komponentenwand“ soll funktionierende Komponenten enthalten, die Nutzer anklicken, mit Text füllen und umschalten können. - Orientiere dich an der Präzision und Zurückhaltung führender Entwicklertool-Websites: überwiegend Schwarz und Weiß, höchstens eine Akzentfarbe, ein strenges Raster und Monospace-Schrift für Code und Zahlen. - Mach einen Theme-Controller einprägsam: Das Ziehen von Radius-, Dichte- oder Akzentfarbreglern verändert sofort jede Komponente auf der Seite. - Füge einen kopierbaren Installationsbefehl, Codeausschnitte, Navigation nach Komponentenkategorie und realistische Nutzungszahlen wie GitHub-Sterne und wöchentliche Downloads hinzu, ohne übermäßig runde Zahlen.
Arbeit und Prompt ansehen →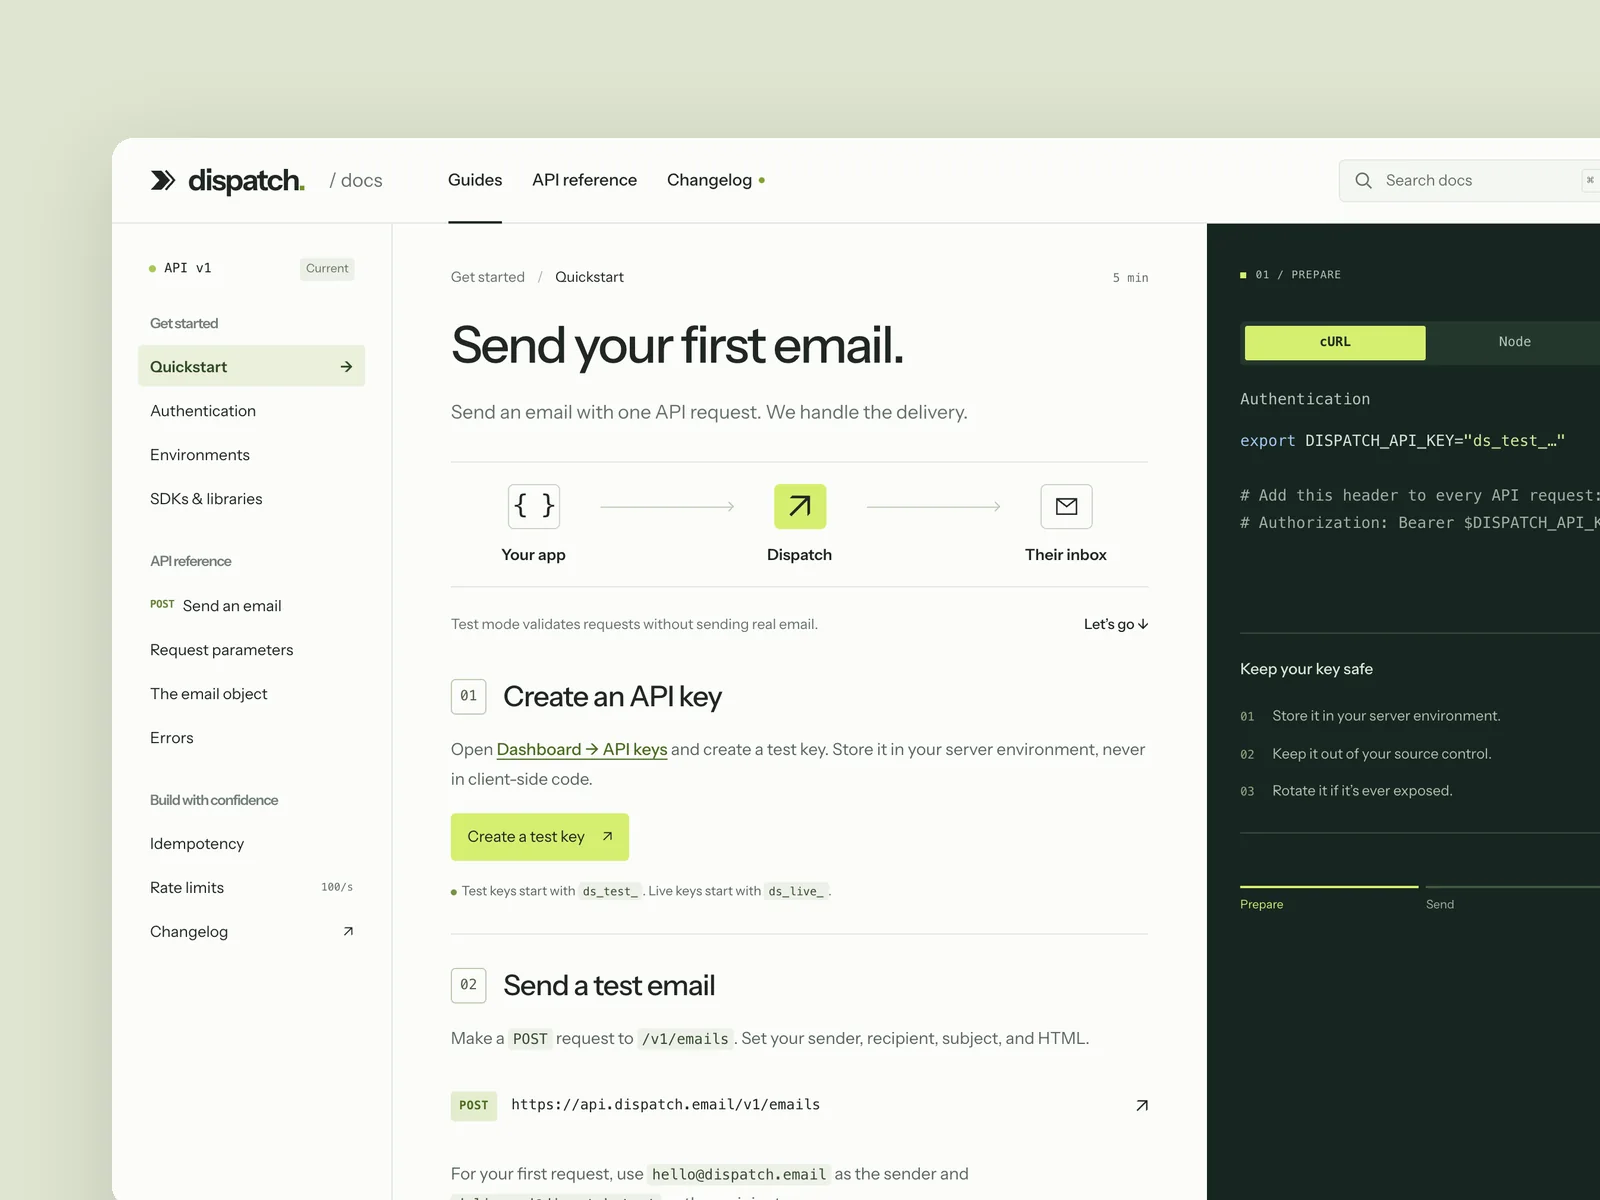
Dispatch
API-Dokumentation für Entwickler
Die Entwicklerdokumentation eines Zahlungs- oder Messaging-API-Unternehmens (ab 1440×900, responsiv bis 390 Pixel Breite): Navigation links, Artikel in der Mitte und Codebeispiele rechts, die zwischen Sprachen wechseln (cURL, Node, Python). Sie enthält einen Schnellstart, eine vollständige Referenz für einen Endpunkt (Parametertabelle, Anfrage- und Antwortbeispiele, Fehlercodes) und Suche. Während des Lesens folgen die Codebeispiele dem aktuellen Abschnitt, und die gewählte Sprache wird auf der gesamten Website gespeichert. Entwirf die Schnellstartseite, eine Endpunkt-Referenzseite und die geöffnete Suche.
Arbeit und Prompt ansehen →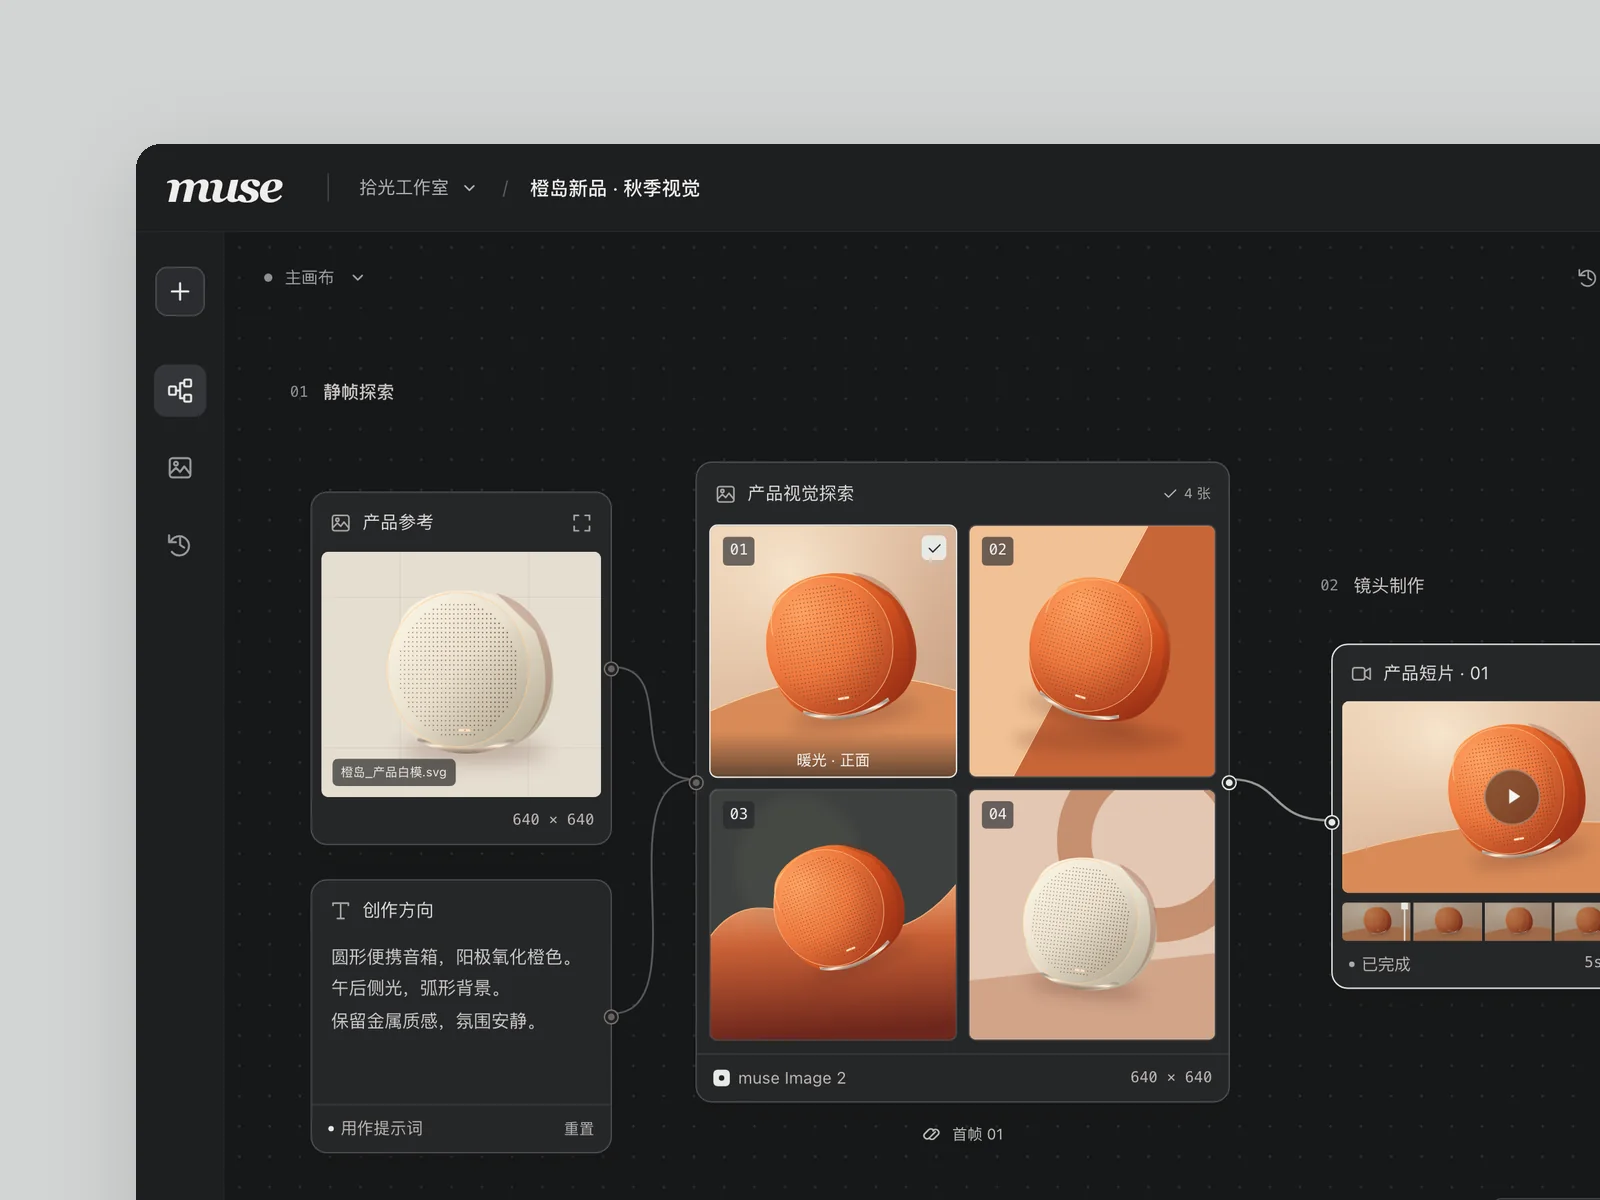
muse
AIGC-Kreativcanvas
Ein KI-Bild- und Videogenerierungstool für Designer und Kreativteams, mit allen Prompts, Referenzbildern und generierten Ergebnissen auf einer unendlichen Arbeitsfläche. Erstelle den Hauptarbeitsbereich.
Arbeit und Prompt ansehen →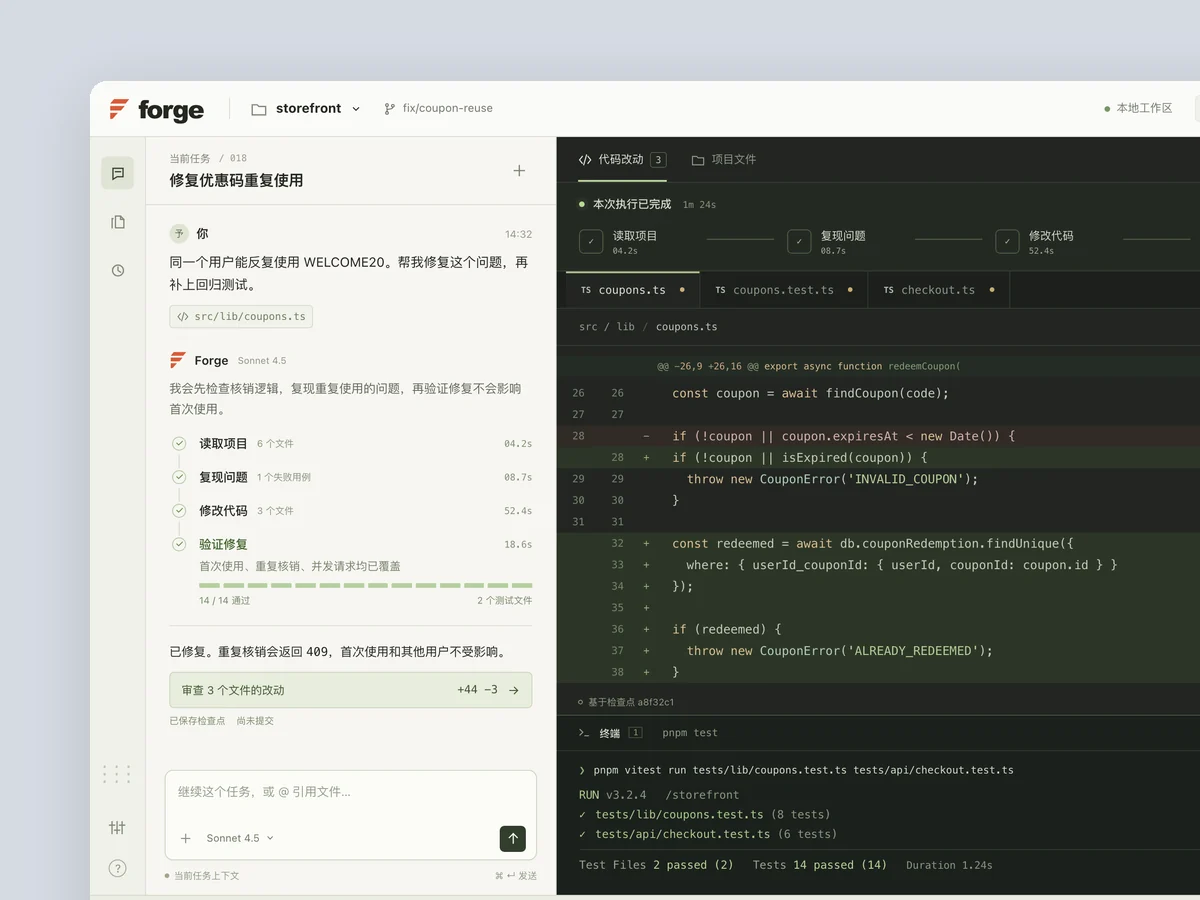
Forge
KI-Coding-Assistent
Produkt: Forge, ein KI-Coding-Assistent für den Desktop. Links befindet sich eine Unterhaltung, rechts der bearbeitete Code und das Terminal. Nutzer können schrittweise beobachten, wie Dateien gelesen, Code bearbeitet und Tests ausgeführt werden. Erstelle die Hauptschnittstelle (1440×900) mit realistischen Daten: Dateinamen, Diffs und Testausgaben, die wie ein echtes Projekt wirken. Mach die Arbeit der KI sichtbar und einprägsam: Schritte leuchten nacheinander auf, Diff-Zeilen erscheinen nach und nach, und Tests wechseln von Rot zu Grün. Erstelle außerdem einen Zustand, in dem die KI auf die Bestätigung einer riskanten Änderung durch den Nutzer wartet.
Arbeit und Prompt ansehen →Optional: Oil UI Pro war nicht Teil dieses Vergleichstests
Jedes Oil-UI-Ergebnis stammt von der Open-Source-Version 0.24.2; Pro spielte weder bei der Generierung noch bei der Abnahme oder Bewertung eine Rolle. Prüfe die Demos und Fehlschläge und führe den Open-Source-Skill zuerst erneut aus. Ziehe Pro separat in Betracht, wenn dein Arbeitsablauf die zusätzlichen Methoden benötigt.
npx github:oil-oil/oil-cli install oil-ui-proHäufige Fragen
Kann dieser Vergleich entscheiden, welchen Skill ich installieren sollte?
Entscheide nicht allein anhand der Durchschnittswerte. Vergleiche Kataloghierarchie, mobile Aktionen, Bewegung, Funktionsfehler und Quelllizenzen und öffne anschließend die Demos, die deinen Prioritäten entsprechen.
Warum erhielt Oil UI run-3 visuell 83 Punkte, obwohl alle Funktionsszenarien bestanden wurden?
Die Abnahme bestätigt, dass die festgelegten Verhaltensweisen funktionieren; das visuelle Review prüft auch die Rückmeldung. Jeder Karten-Neuaufbau in diesem Durchlauf spielte eine Animation ab Transparenz erneut ab, wodurch Ergebnisbereiche bei mehreren Such-, Speicher- und Vorschlagsaufnahmen fast leer blieben. Dieser sichtbare Feedbackfehler rechtfertigt die 83 Punkte, beweist aber keinen dauerhaften Datenverlust.
Bedeuten die 2 Fehlschläge ohne Skill, dass das Speichern vollständig defekt war?
Nein. Beide Durchläufe scheiterten an einer exakten Toast-Textprüfung, weil der tatsächliche Text ein Häkchen und Leerraum hinzufügte. Das beweist keinen vollständigen Speicher- oder Persistenzfehler, verletzt aber den vorher festgelegten Vertrag. Deshalb bleiben beide Durchläufe failed mit 5/6.
Wie kann ich die Zahlen und Bildschirme in diesem Artikel prüfen?
Lade results.json für jede Bewertung in 6 Dimensionen, jeden Gesamtwert und jedes Funktionsergebnis herunter und öffne anschließend für jeden Kandidaten die 3 Desktop-Ausgangsbilder, ein mobiles Bild und 3 funktionierende Demos. Jedes mobile Bild stammt aus run-1; es wurde weder ein besser bewerteter Durchlauf ersetzt noch ein Formular-Screenshot als primäres Bild verwendet.