
4 款 UI 设计 Skill 实测:同一模型、15 次生成与匿名视觉评审
我们在 Kimi AgentSwarm 中用 kimi-1021-preview,让 4 款固定版本的 UI 设计 Skill 和无 Skill 对照各生成 3 次 CommonShelf 工具目录,共 15 次。13 次功能验收通过,2 次失败均来自无 Skill 对照;视觉平均分依次为 Oil UI 87.0、frontend-design 88.0、UI UX Pro Max 86.7、Impeccable 88.0、无 Skill 84.3。若你正在挑选 UI 设计 Skill,尤其在意目录层级、移动操作、动效与功能稳定性,可以对照本文的演示和失败细节;结论只覆盖这次任务与模型。
核心要点
- 四个 Skill 均在生成前锁定版本。每轮由新 Agent 在新工作区独立完成,只交付一个方向,不用较强结果替换较弱结果。
- 两次功能失败都发生在无 Skill 对照的 Toast 精确文本断言处,不能据此认定保存功能整体失效。
- Oil UI run-3 虽通过 6/6 功能场景,但反复重播从透明开始的卡片动画,多张状态图因此近乎空白;视觉得分 83,问题完整公开。
任务与版本:同一份 CommonShelf 简报
CommonShelf 是无需账户的个人工具目录。简报提供六条固定工具数据,要求用纯 HTML、CSS 和 JavaScript 实现搜索、分类与收藏筛选、工具保存、带校验的工具建议和键盘可操作的 FAQ。除用户主动打开官方工具链接外,页面运行时不发外部请求。每个 Agent 只交付一个方向,不能生成多版后挑选。
每个 Skill 条件只读取指定的 SKILL.md 一次,无 Skill 条件不读取任何 Skill。版本在生成前锁定,不以全局同名或付费版替代;许可证随版本列出。
| 条件 | 固定版本 | 许可证 |
|---|---|---|
| Oil UI 开源版 | 0.24.2(tag v0.24.2) | MIT |
| frontend-design | commit-dbd4588f9e1033efb41dad4bef2f7947c8993d44 | Apache-2.0 |
| UI UX Pro Max | 2.15.0(tag v2.15.0) | MIT |
| Impeccable | 4.7.0(tag skill-v4.7.0) | Apache-2.0 |
| 无 Skill 对照 | 无上游 Skill 或版本 | 未提供上游许可证 |
方法:15 次独立生成,功能与视觉分开验收
所有生成均在 Kimi AgentSwarm 中由新 Agent 完成,模型为 kimi-1021-preview,thinking effort 为 max。不同条件可并行,同一条件的 run-1、run-2、run-3 依次进行。每次使用新工作区,不得读取其他运行的页面、截图或对话,也不替换较弱结果。调度和恢复会影响耗时,因此不比较耗时。
生成结束后,独立 Playwright 1.64.1 验收器在 Chromium 中检查六类场景:桌面基线、手机基线、交互与持久化、内容不可用、存储不可用、减少动态效果,视口为 1440×900 和 390×844。验收结果不反馈给同版生成,也不以视觉分替代功能结果。
视觉评审使用 15 个匿名材料包,隐去条件身份和生成过程,保留运行文件、截图与验收状态。每个材料包完成一份评审,按六个维度计算每次总分,再取三次算术平均值;六项合计 100 分,不额外加权,也不挑选高分 run 代表整组。
| 维度 | 满分 |
|---|---|
| 视觉层级与可读性 | 20 |
| 产品契合与原创性 | 20 |
| 响应式 | 15 |
| 交互与状态反馈 | 20 |
| 可访问性 | 15 |
| 细节与动效 | 10 |
结果总表:每次分数与功能状态
15 次生成和 15 份匿名视觉评审全部完成,功能验收 13 次通过、2 次失败。平均分由三次总分除以 3 得出,保留一位小数,例如 UI UX Pro Max 为 260/3,无 Skill 为 253/3。公开 JSON 保留每次六维分数、功能状态和素材地址。
| 条件 | run-1 | run-2 | run-3 | 三次总分 | 平均分 | 功能验收 |
|---|---|---|---|---|---|---|
| Oil UI 开源版 | 88 · 通过 | 90 · 通过 | 83 · 通过 | 261/300 | 87.0 | 3/3 通过 |
| frontend-design | 87 · 通过 | 87 · 通过 | 90 · 通过 | 264/300 | 88.0 | 3/3 通过 |
| UI UX Pro Max | 86 · 通过 | 88 · 通过 | 86 · 通过 | 260/300 | 86.7 | 3/3 通过 |
| Impeccable | 88 · 通过 | 87 · 通过 | 89 · 通过 | 264/300 | 88.0 | 3/3 通过 |
| 无 Skill 对照 | 83 · 失败 | 86 · 通过 | 84 · 失败 | 253/300 | 84.3 | 1/3 通过,2 次失败 |
Oil UI 开源版 0.24.2:87.0,run-3 的透明重播必须扣分
三次视觉分数为 88、90、83,功能验收均为 6/6。三版都把搜索、筛选和六件工具放在产品中心,卡片信息顺序稳定;收藏同步改变文字、图标或形状、底色与计数。空结果可重置,加载失败可重试,表单错误提供汇总与逐字段恢复说明。
run-1 的手机长表单报错后,需要滚动才能看到完整操作行,部分状态图还抓到后续卡片接近透明的入场帧。run-2 的共享索引线与保存插片更完整,但 420ms 入场效果让搜索和建议刷新截图短暂发白,小号等宽辅助文字也增加了长页阅读负担。
run-3 每次 renderTools() 重建卡片都会重播从 opacity: 0 开始的 180ms card-in 动画。搜索截图显示“1 tool”却没有可见结果卡,手机搜索、保存后刷新和建议刷新也出现近乎透明的卡片。功能验收虽通过,这些画面仍说明筛选反馈会被反复打断,因此视觉分为 83;它们不能证明结果永久丢失。
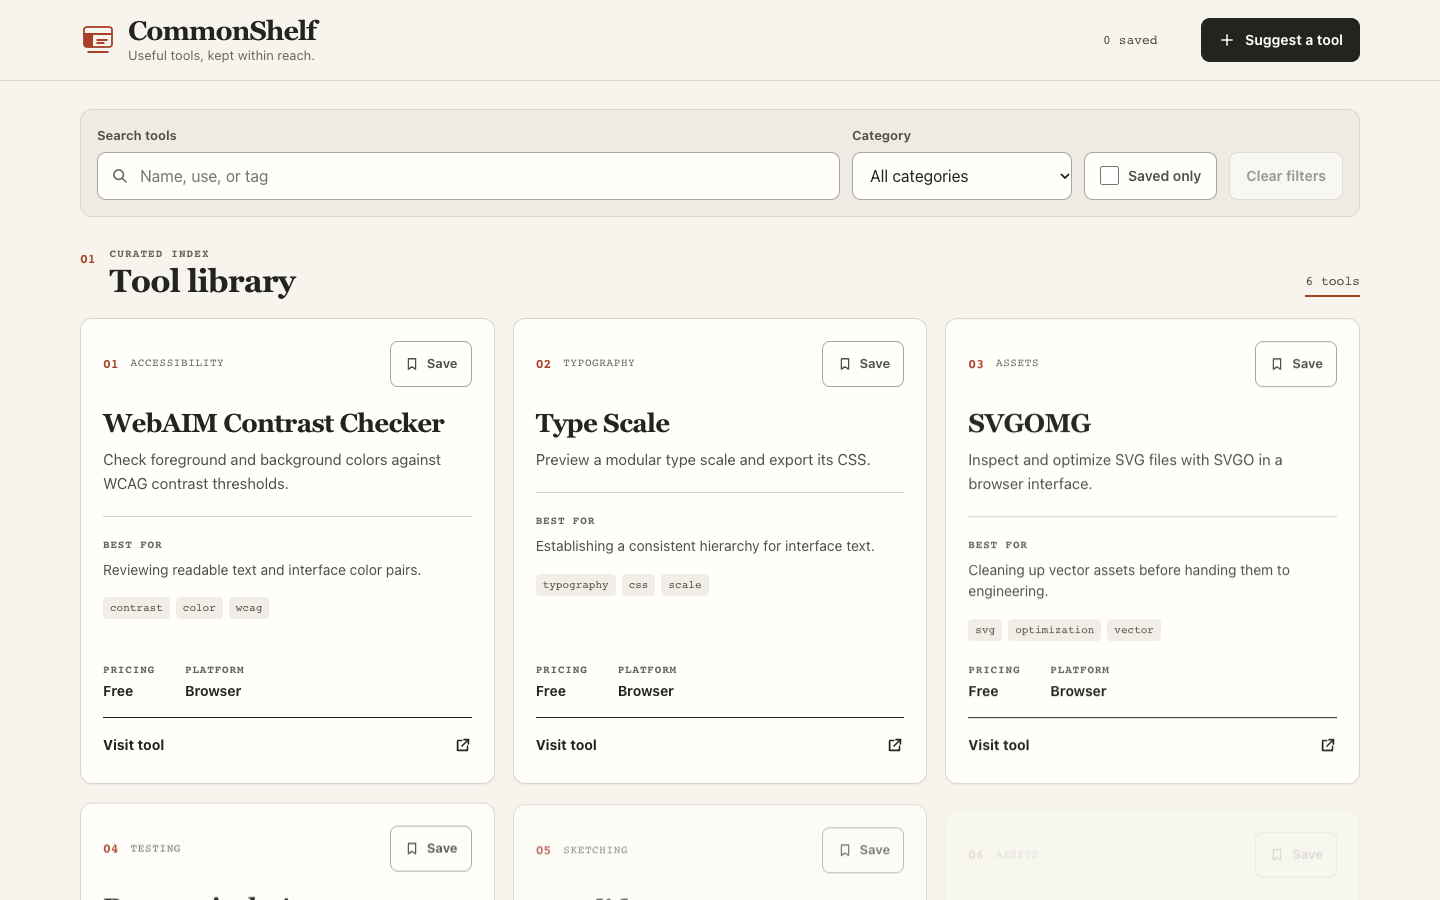
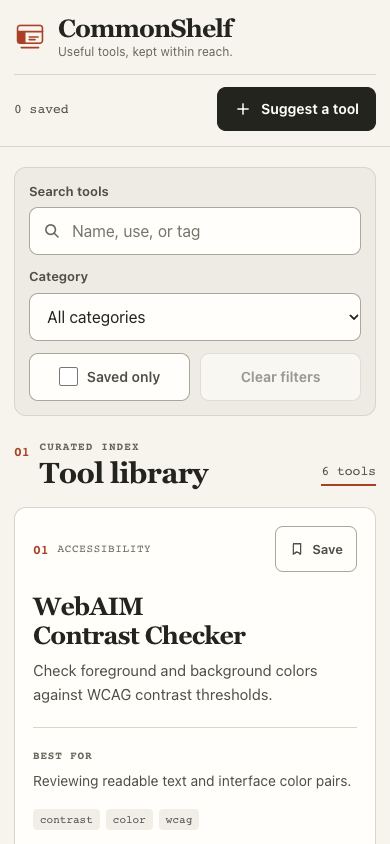
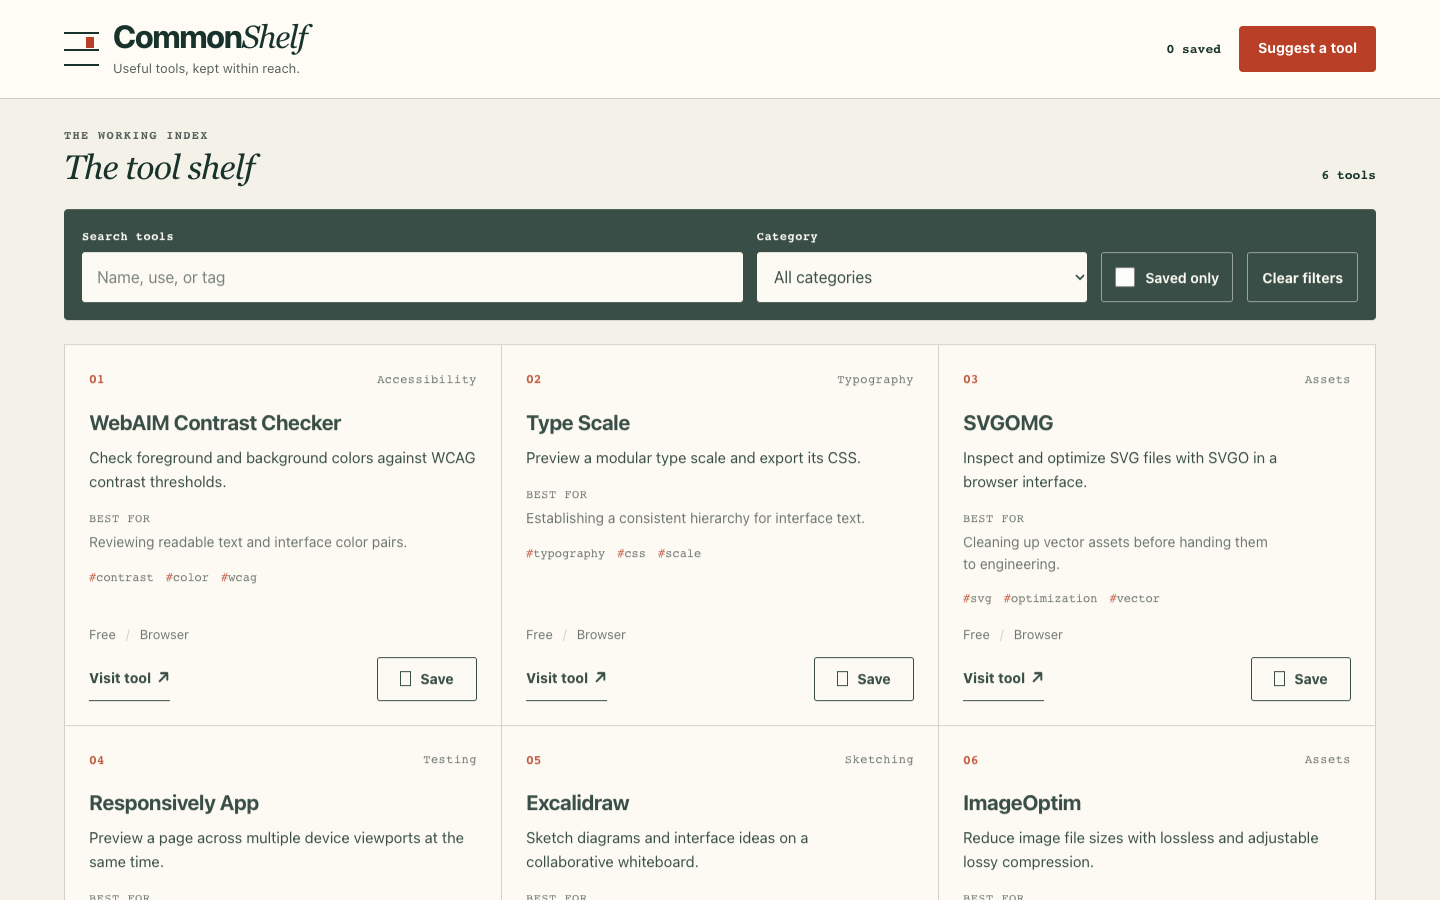
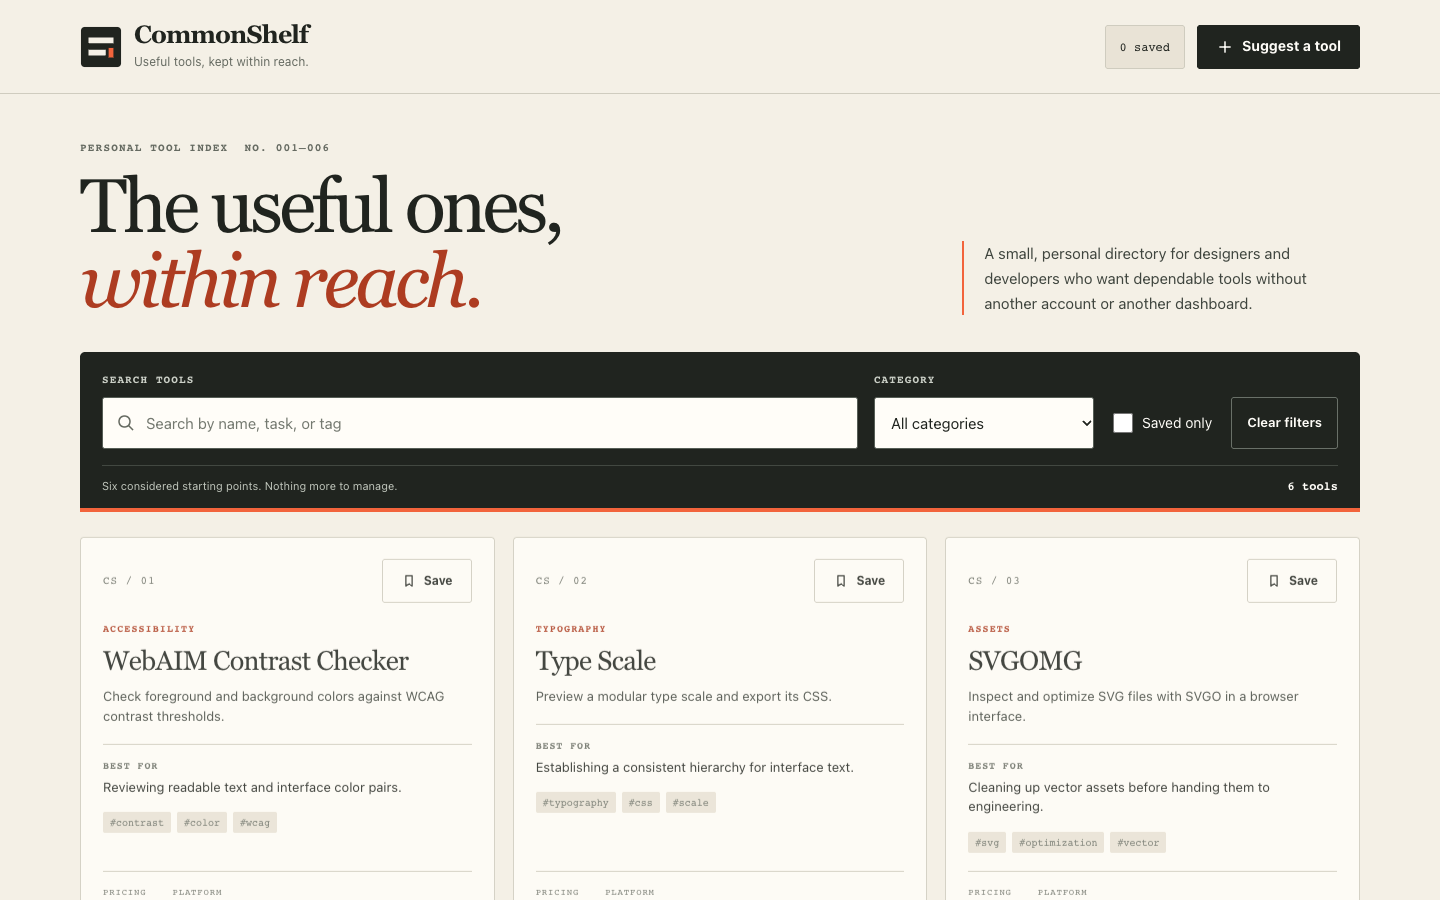
frontend-design:88.0,统一的工作抽屉语言与重复强调并存
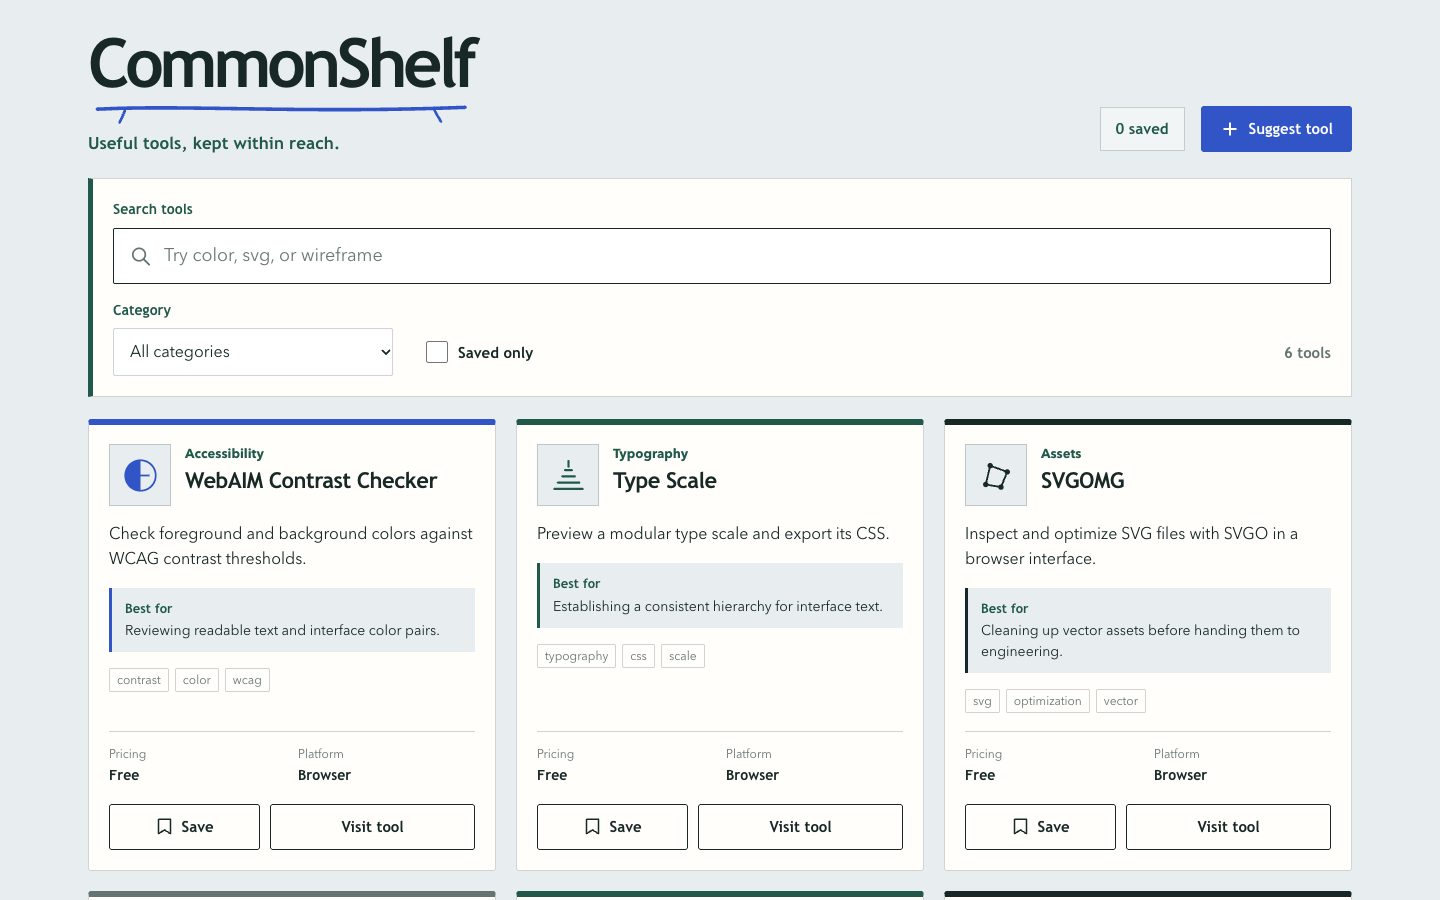
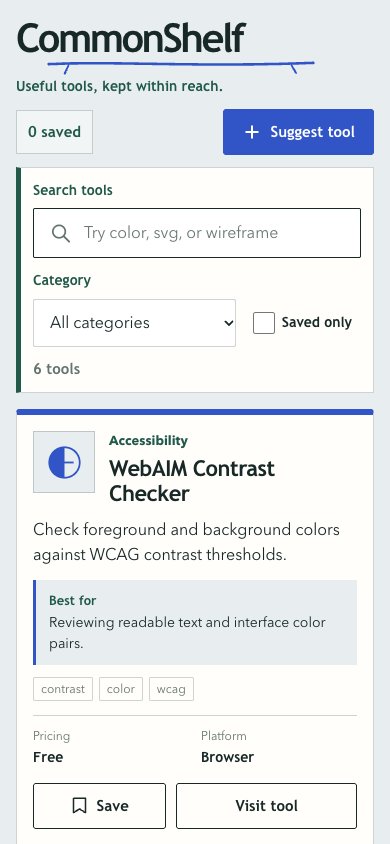
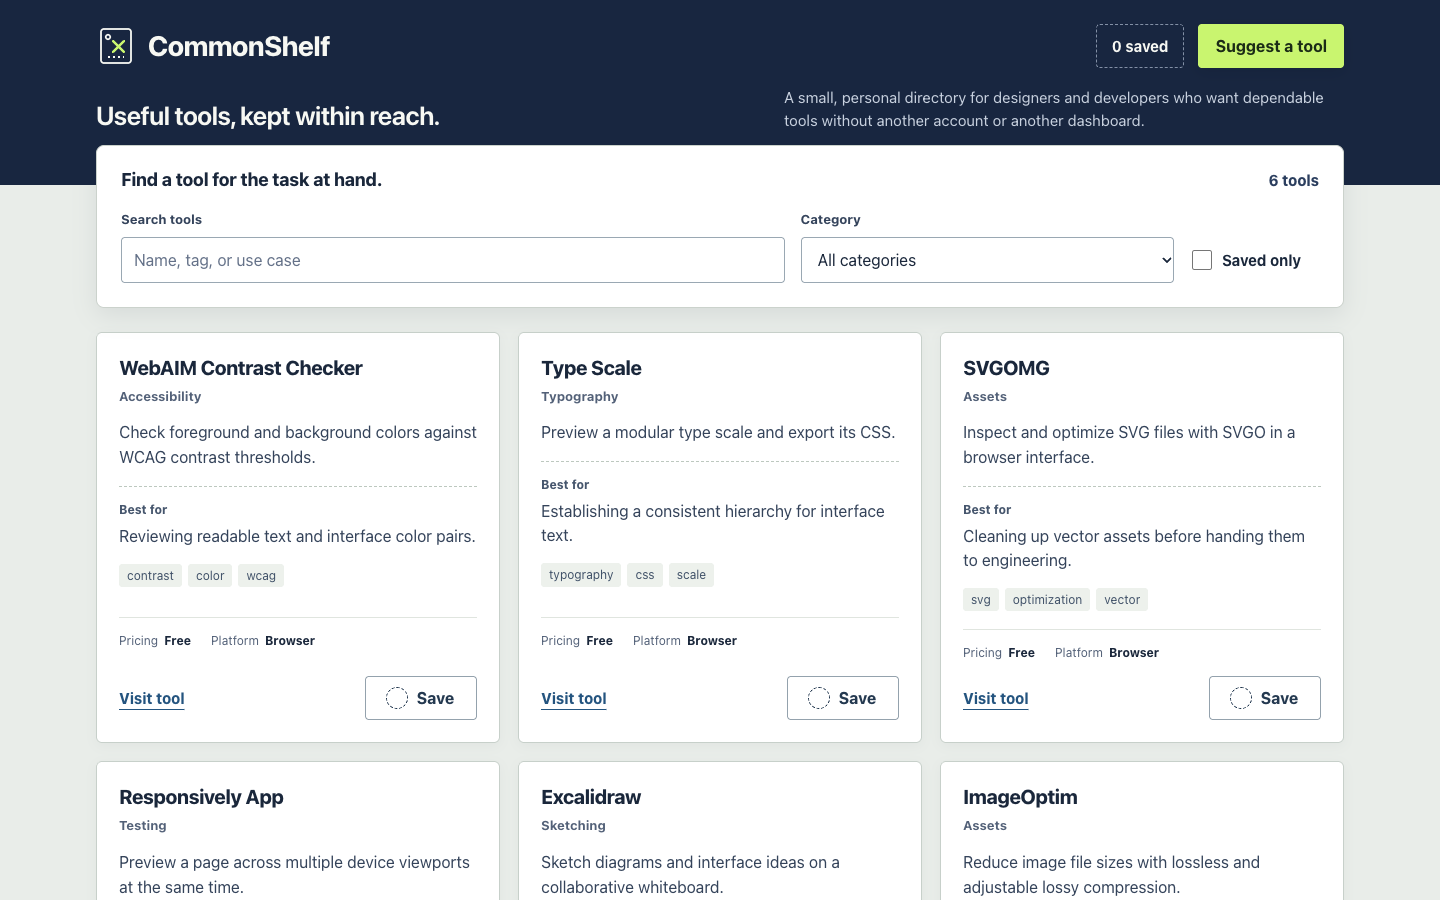
三次视觉分数为 87、87、90,功能验收均为 6/6。run-1 用冷灰底、标签纸、手绘层架线、书签和不同工具符号形成“工作抽屉”方向,工具摘要和适用场景是主角;收藏同步改变文字、书签填充和底色,手机首卡与无效表单操作完整可见。
run-2 的信息层级仍清楚,但工具卡 6px 顶条、卡片粗底线及筛选与建议区左边线叠加,视觉偏重;手机错误弹窗的取消与保存落在 844px 首屏之外,需要滚动。run-3 也重复蓝色左边线,标签与元信息偏小。它与 Impeccable 平均分相同,但画面与问题不同。
UI UX Pro Max 2.15.0:86.7,状态完整,移动端密度与操作位置拖分
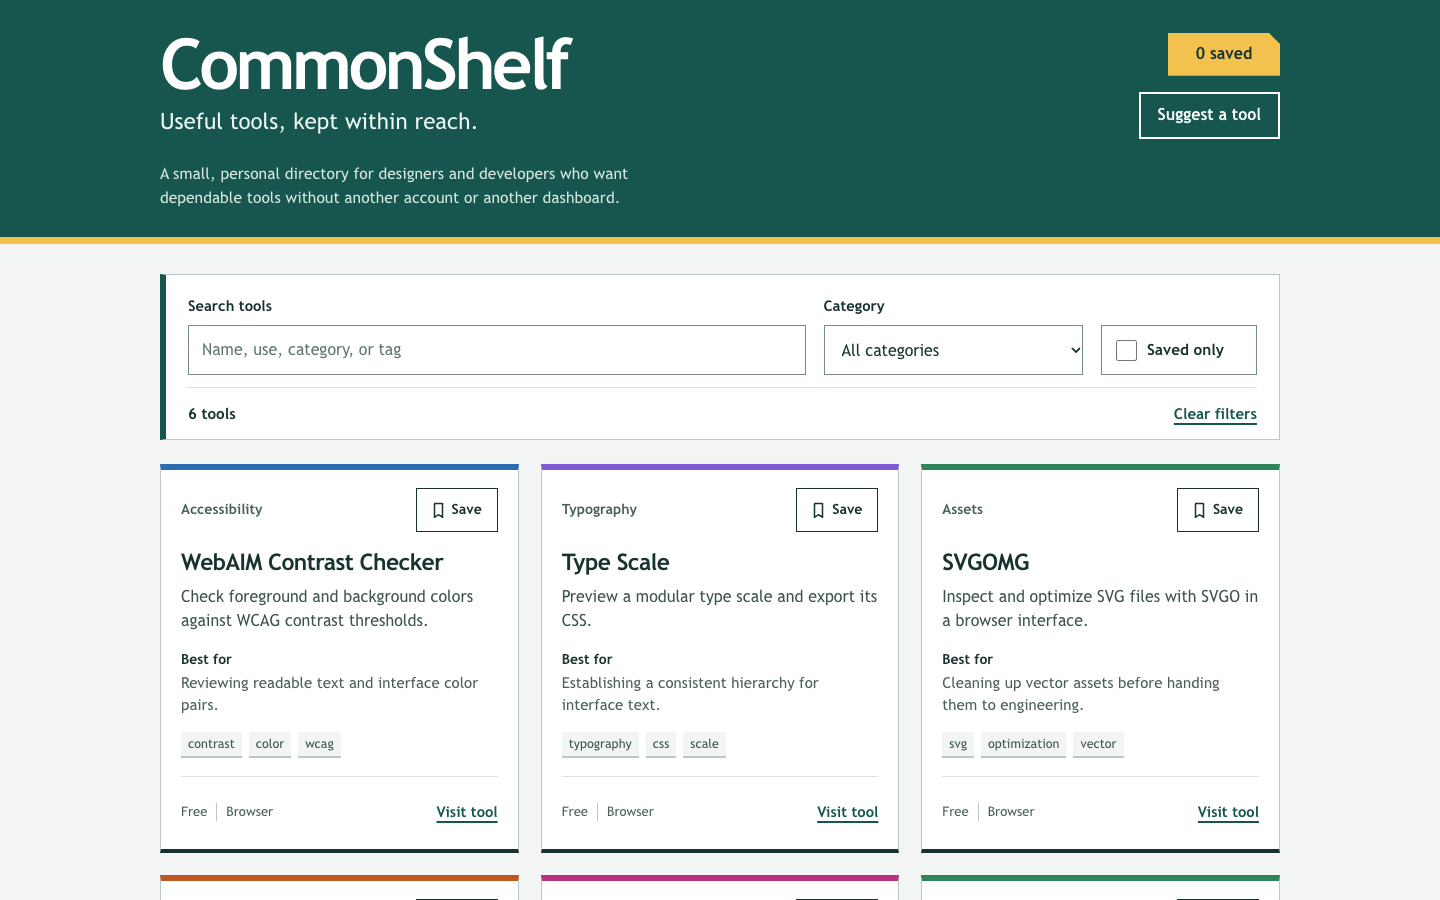
三次视觉分数为 86、88、86,功能验收均为 6/6。三版都按名称、摘要、适用场景、标签、价格与平台组织六件工具;收藏同步更新 Save/Saved 文案、书签、计数和 Saved only 状态,加载失败、存储降级和表单错误均有恢复路径。
run-2 的工具卡 4px 顶部强调条与建议项、规格区左边线重复,12px 分类、编号和标签偏多,显得公式化。run-3 的第一张手机工具卡约从 712px 开始,844px 视口只能看到卡片顶部,整页约 4695px。桌面与手机的长错误表单都要滚动寻找提交和取消,虽通过验收,完成流程仍不够直接。
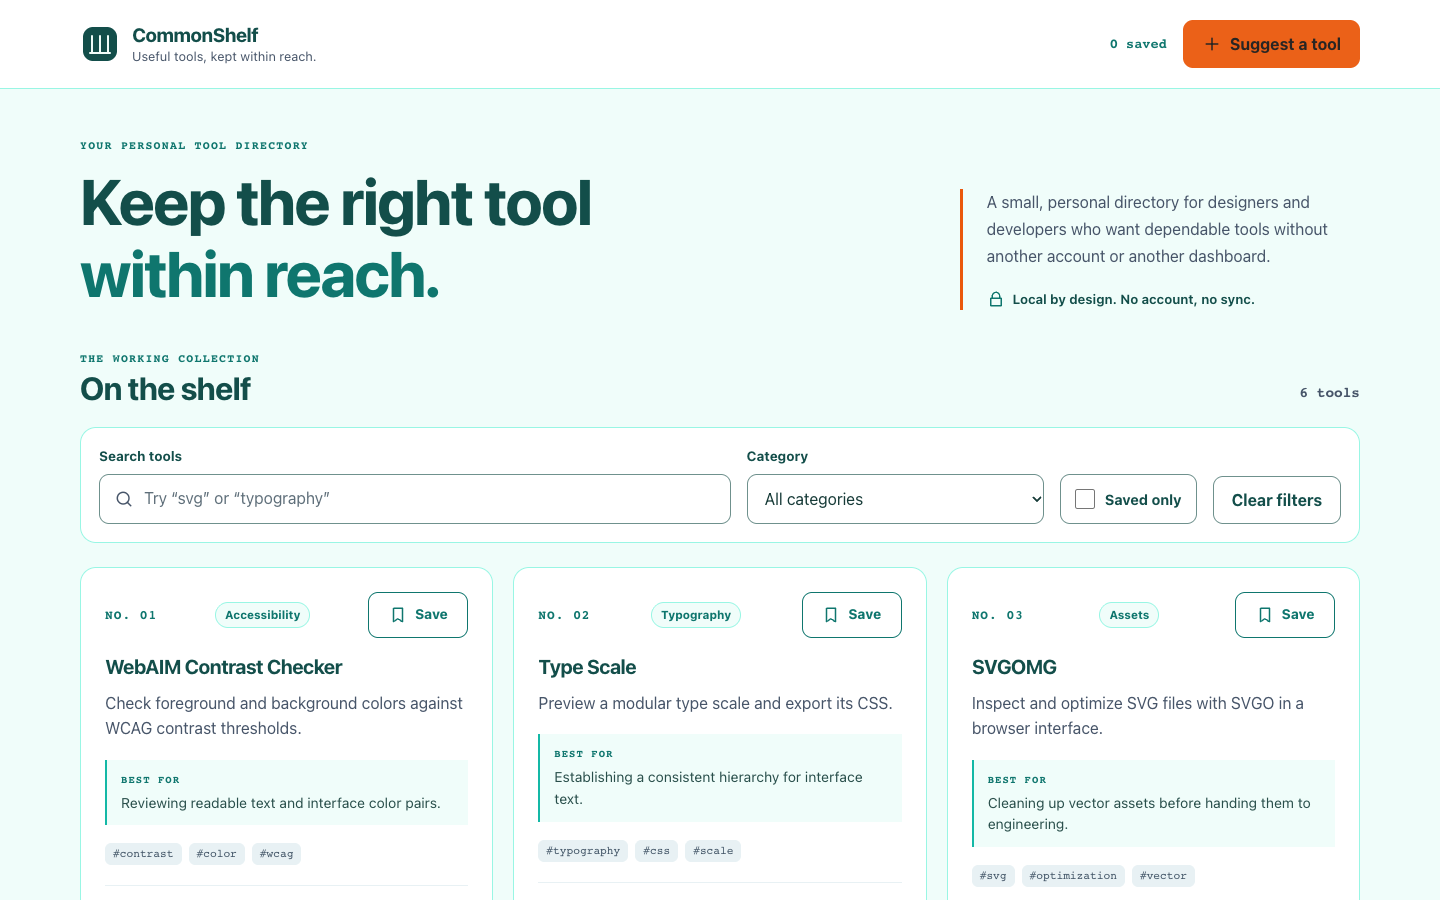
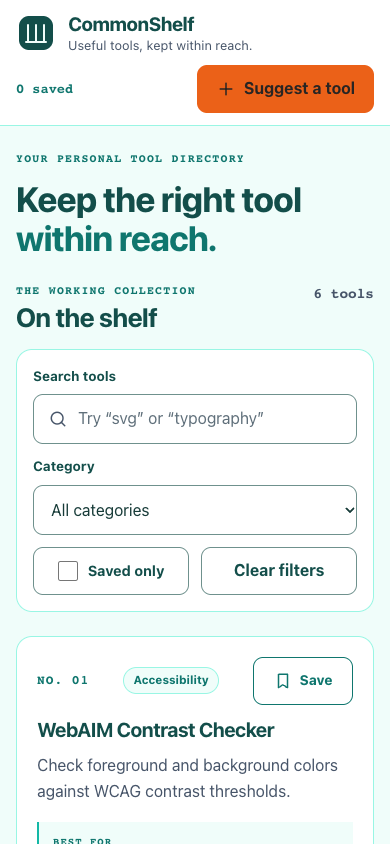
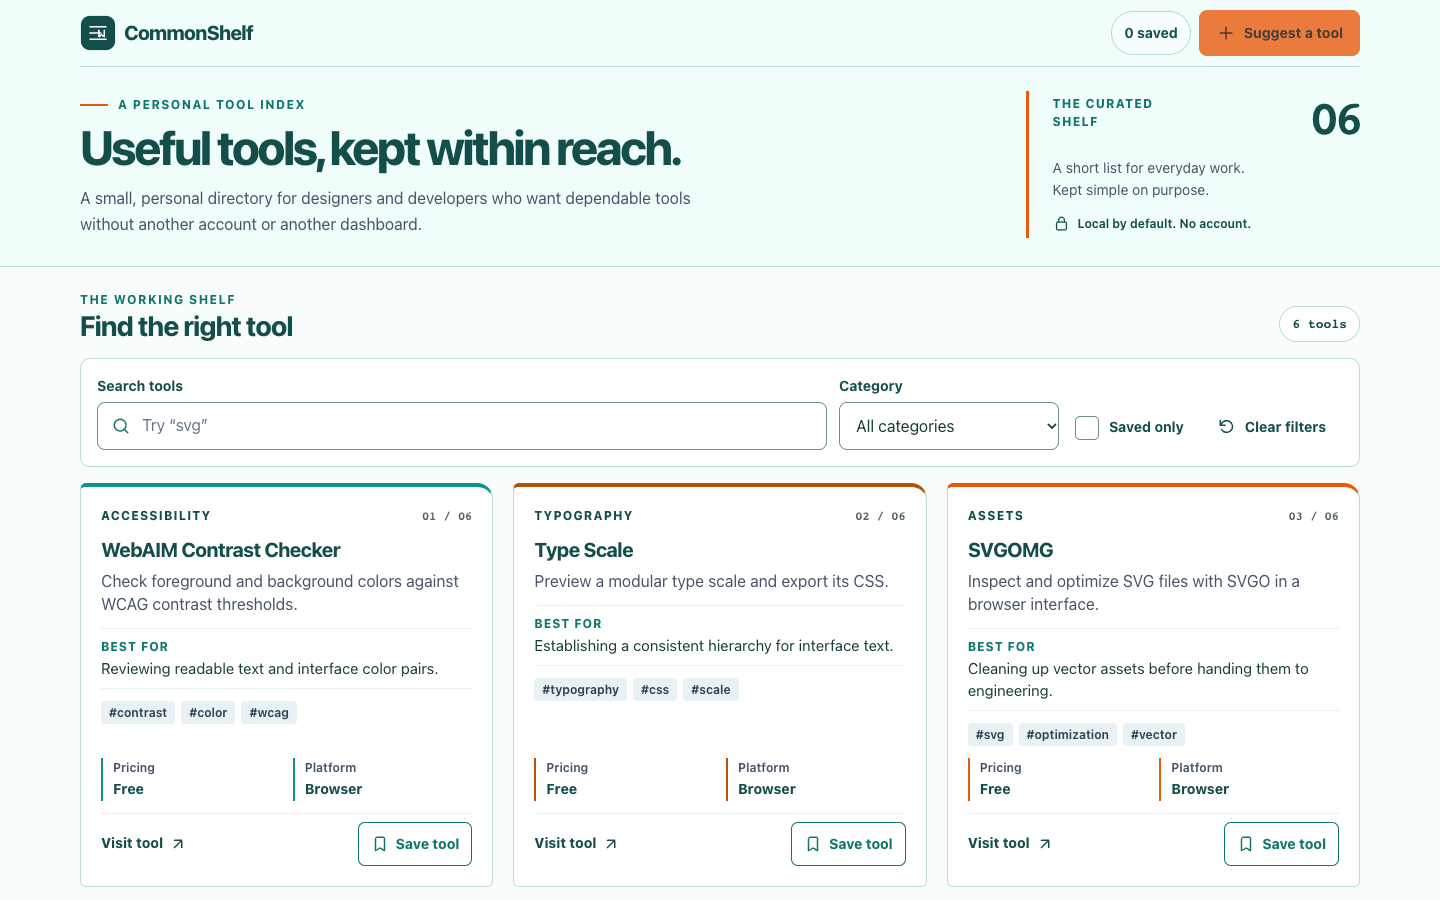
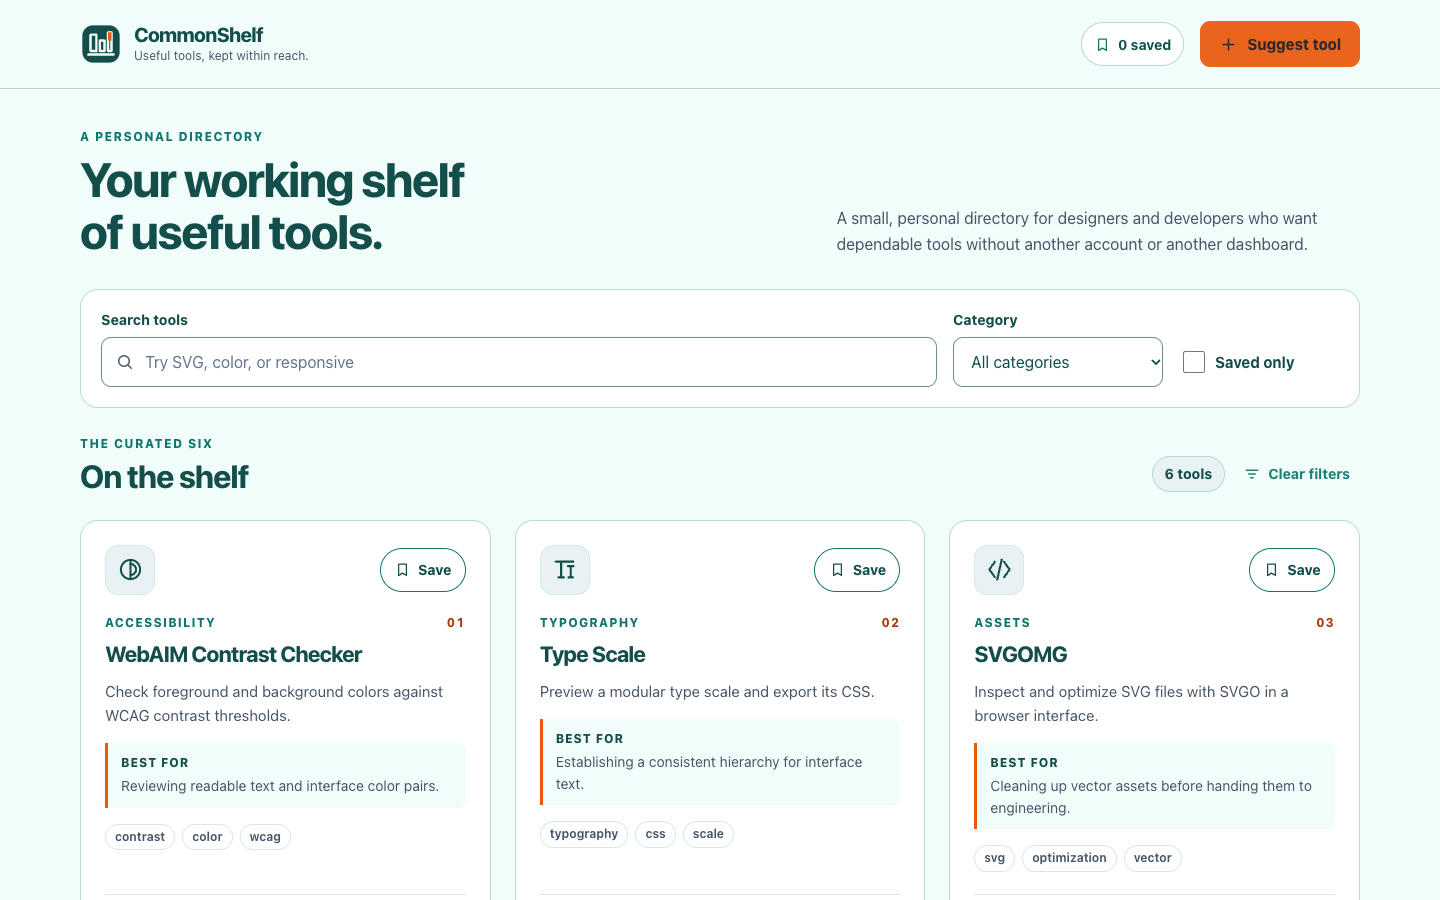
Impeccable 4.7.0:88.0,状态相关的目录细节较扎实
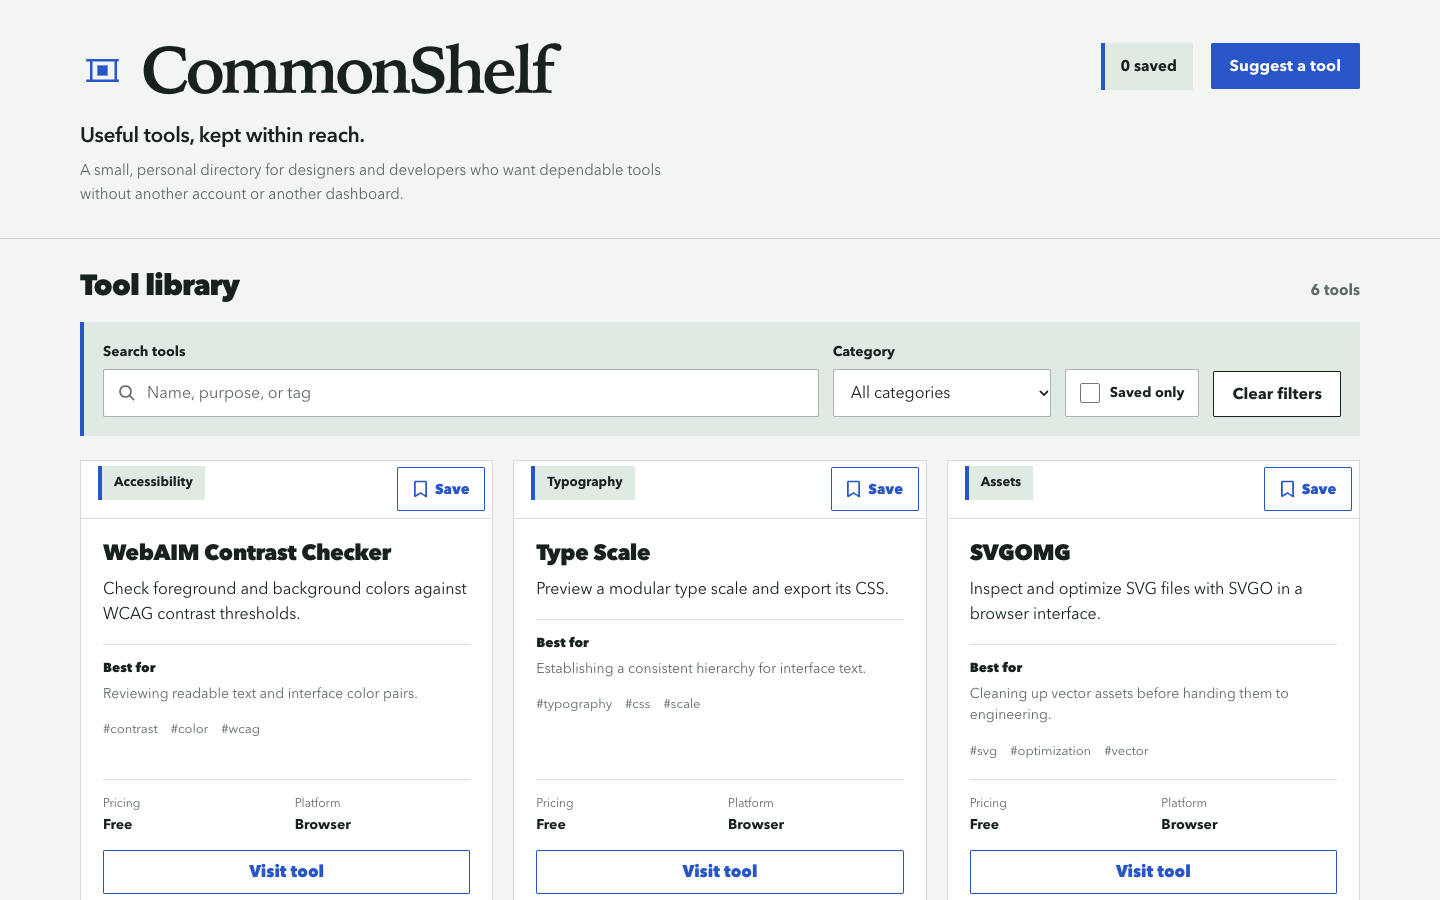
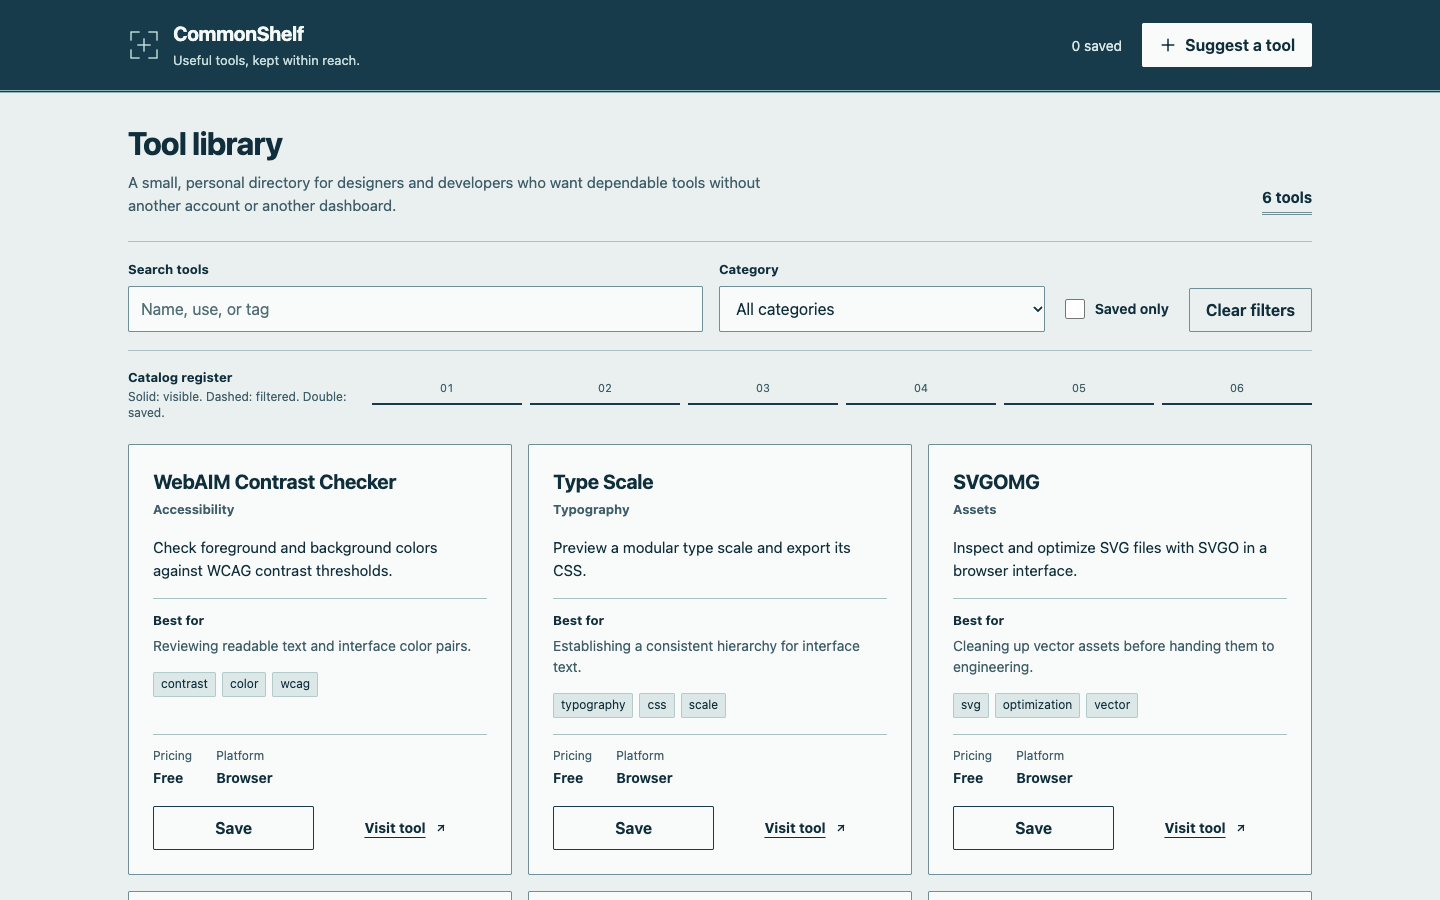
三次视觉分数为 88、87、89,功能验收均为 6/6。run-1 用票样打孔、虚线与缝合标记形成统一方向;run-3 的 Catalog register 随搜索、保存和筛选改变线型,让装饰对应真实状态。收藏反馈结合文字、标记、填充或边框,零结果与加载失败都提供下一步操作。
扣分点主要在密度和小屏流程。run-1 同排卡片的摘要、标签和元信息基线会随内容长度错位,12px 元信息偏弱。run-2 的高页头与多层筛选减少了手机首屏的工具操作,整页达到 3149px;多轮手机错误弹窗都要继续滚动才能看到取消与保存。
无 Skill 对照:84.3,能做出完整界面,但两次功能失败不能抹掉
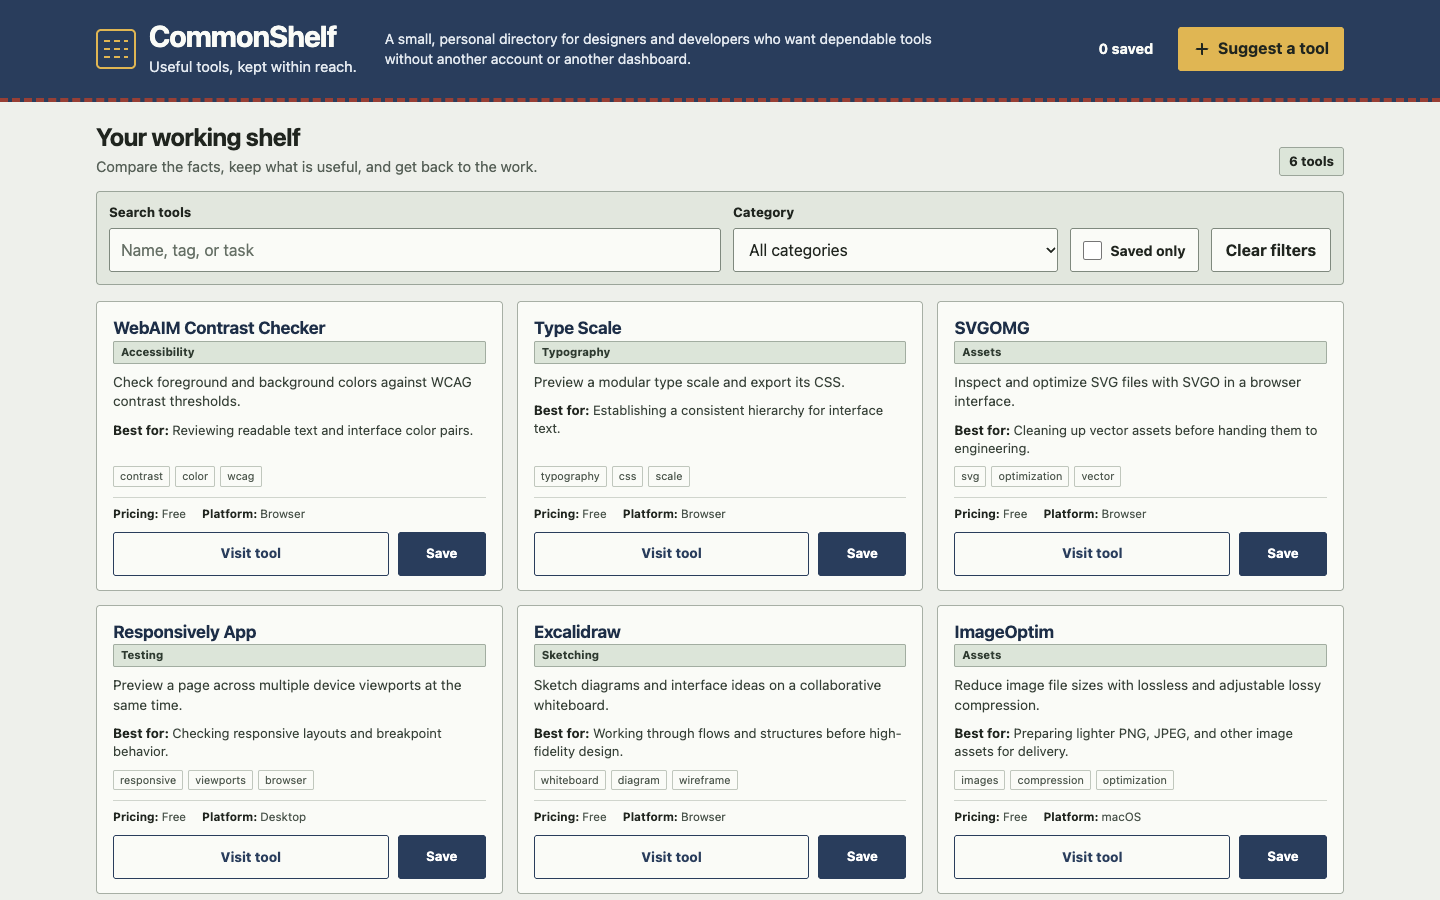
三次视觉分数为 83、86、84。暖纸、编号和索引线也能组成统一的工具目录,桌面三列与手机单列基本清楚,收藏和空结果通常不只用颜色反馈。底层模型本身已能完成完整界面,不能把对照组当成零分。
run-1 和 run-3 都在 interaction-and-persistence 场景的 Toast 精确文本断言处失败:预期纯文本“Suggestion saved.”,实际多了勾选符号与空白。run-3 的勾选符号在 HTML 中标为 aria-hidden,不能据此认定建议保存或持久化整体失效;但按预定契约,两轮仍为 failed,各通过 5/6,失败断言后的同场景步骤不计入已验收。
辅助文字多次过小、过淡。run-3 的工具序号与占位符在局部色值抽算中对比不足,手机错误弹窗的底部操作只露出上沿;run-1 的介绍与筛选占据大部分手机首屏。
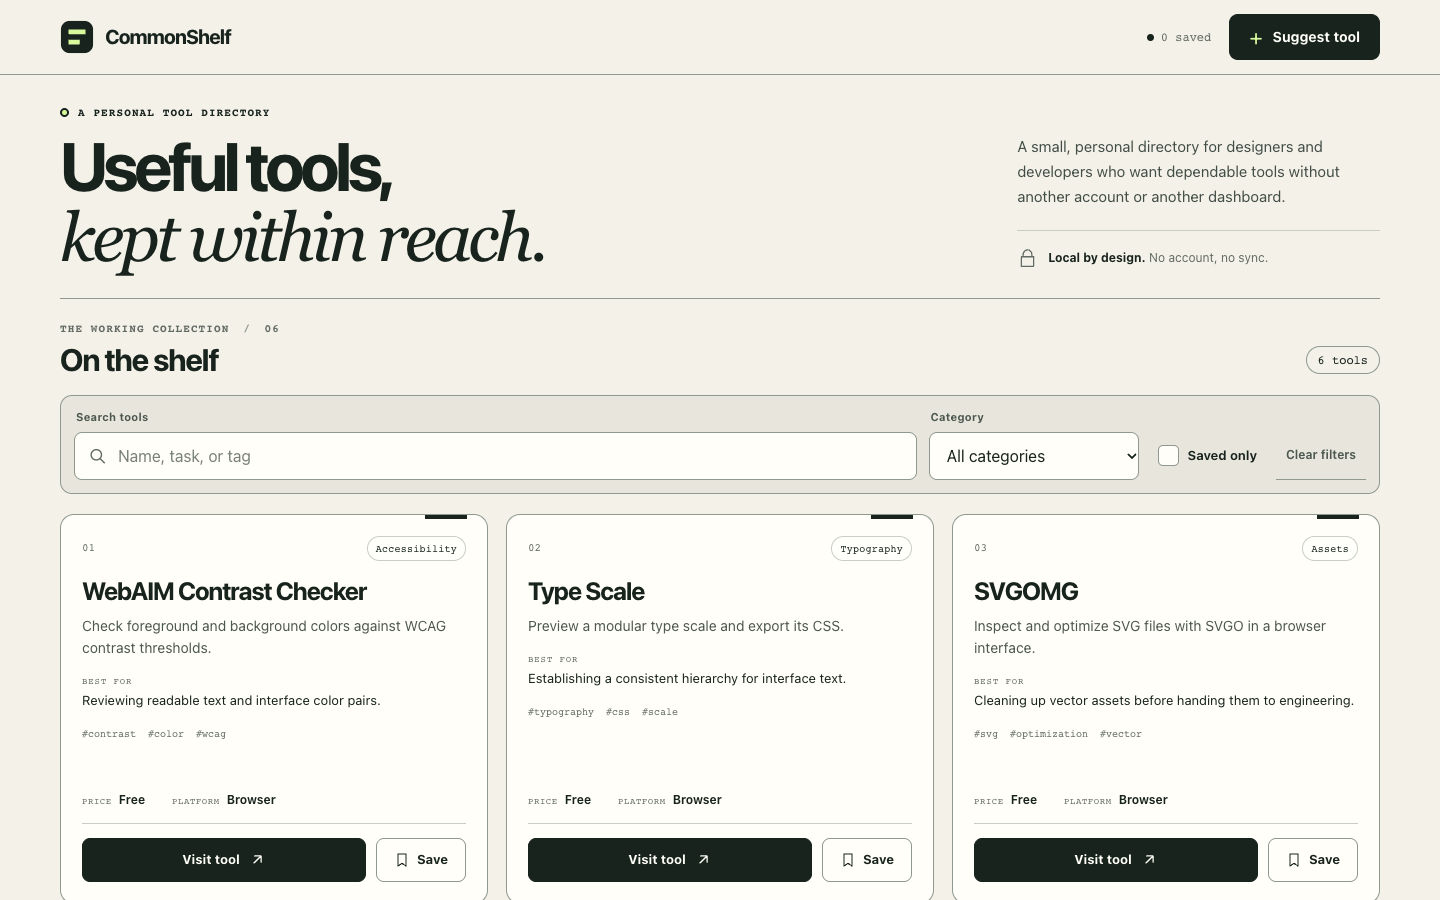
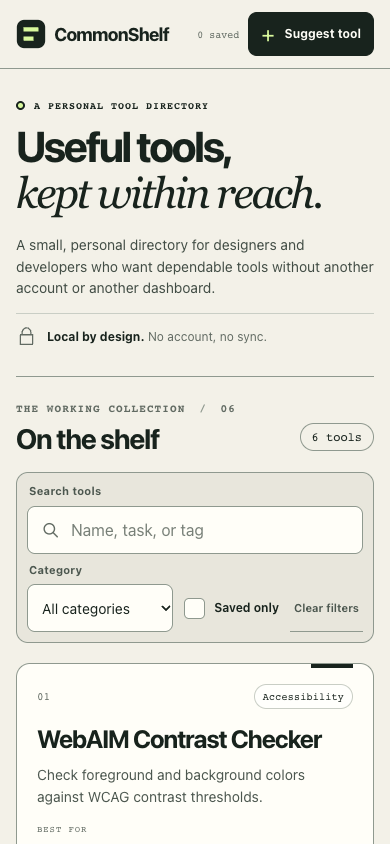
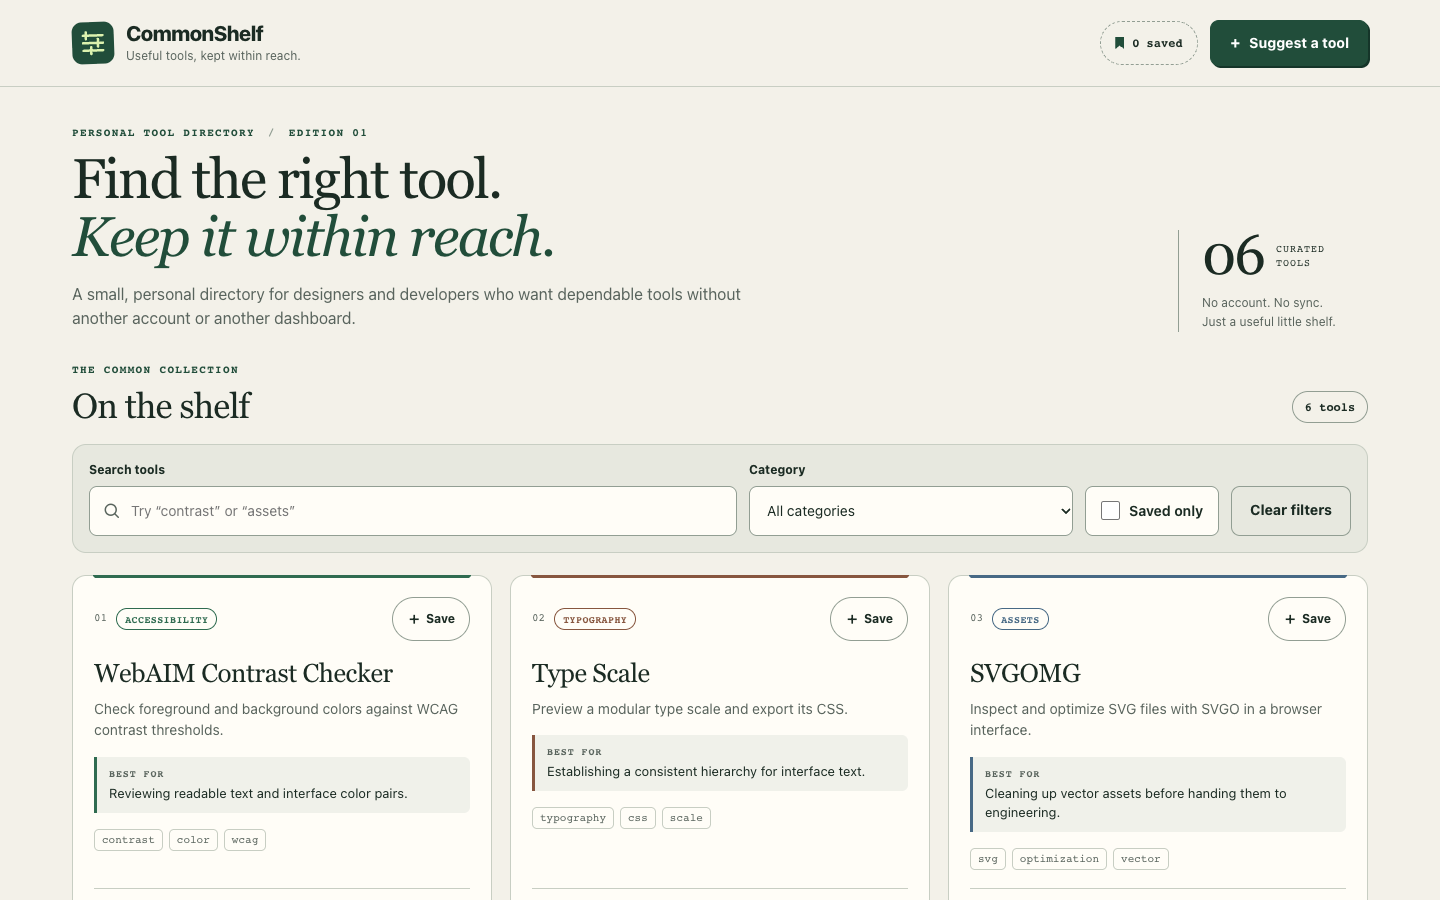
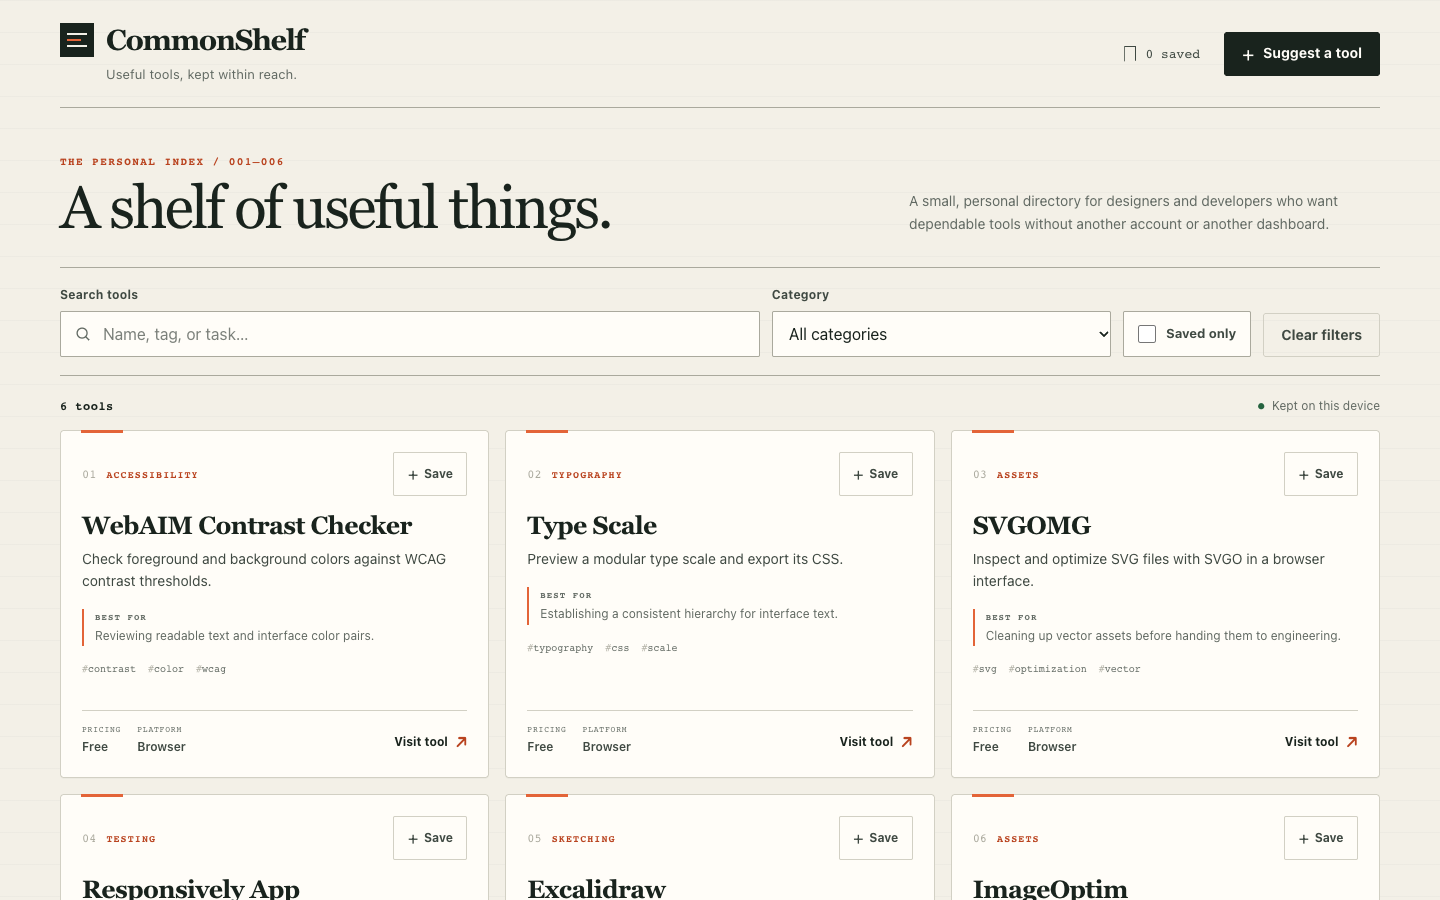
附录|Oil UI 0.24.2 优化候选复测:一次后续试验
这一附录记录 Oil UI 0.24.2 独立优化候选的一次后续复测,环境仍为 Kimi AgentSwarm + kimi-1021-preview。候选不是官方新版本,不在原 15 次样本内,也不修改或替代原结果;一次试验不能证明普遍提升。
独立功能验收为 6/6,补充连续交互为 2/2,覆盖 11 个连续检查点。两位独立盲评分别给出 89 和 90 分,平均为 179/2 = 89.5;评审没有重新运行 Playwright,功能与视觉证据分开记录。直接证据仅覆盖 Chromium 的 1440×900 与 390×844,不包含真实手机、所有断点、其他浏览器或完整无障碍审计。
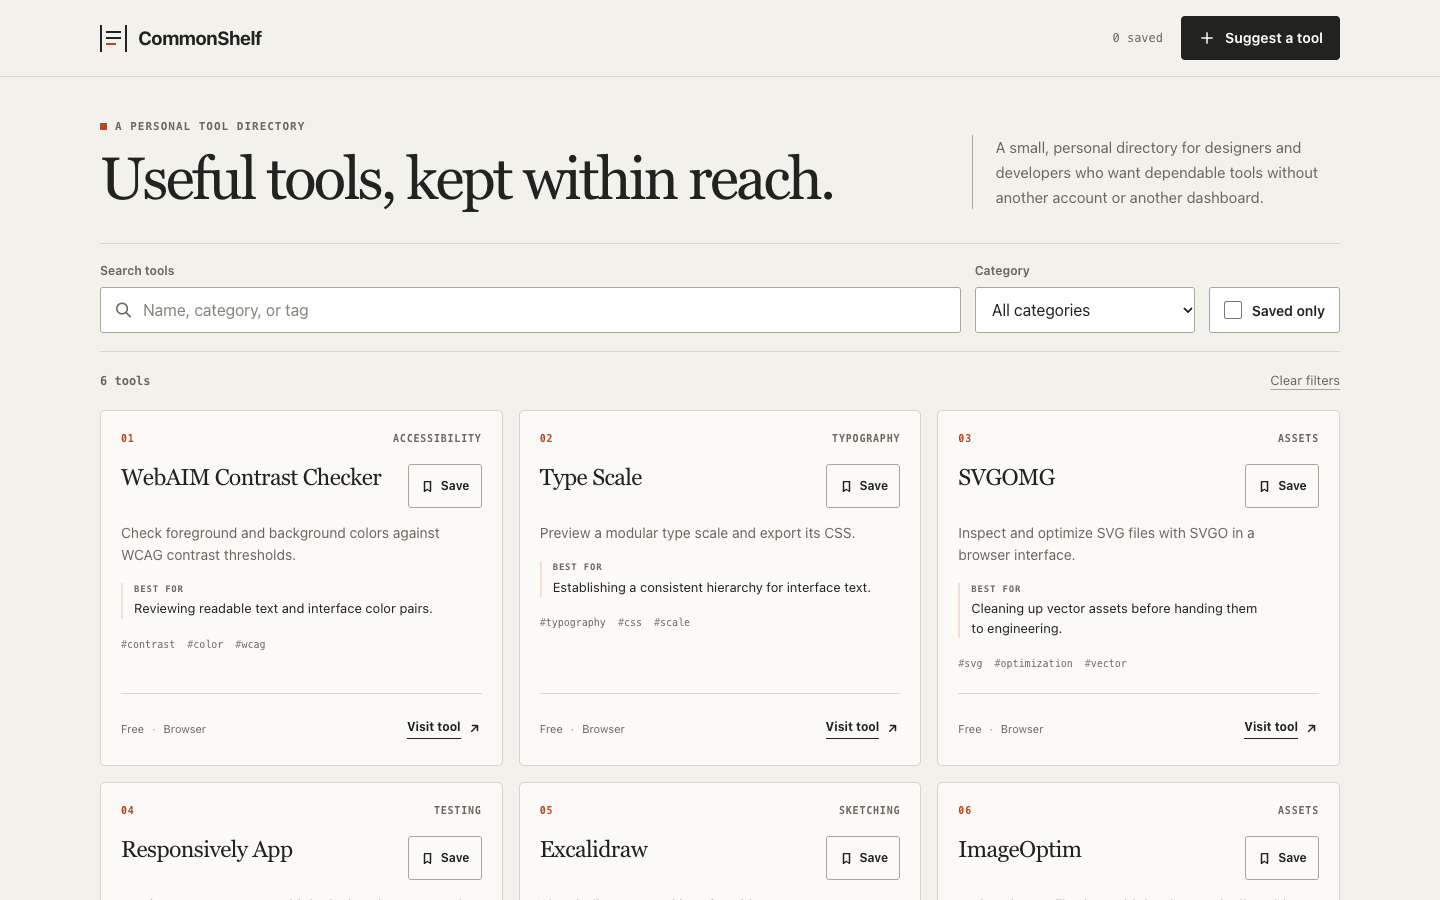
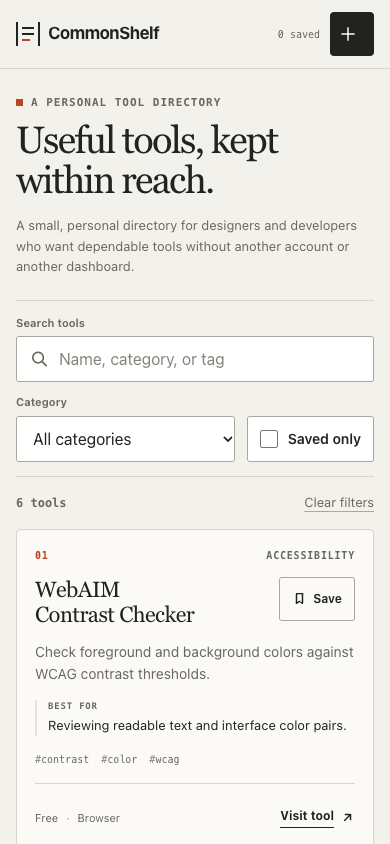
- DOM 与动效:连续操作和刷新未观察到整组卡片重播
- 11 个连续检查点中,保留卡片均记录 sameOriginalNode=true,不再每次重建整批卡片;卡片与建议的 animationstart 记录均为空,两位评审也查看了连续操作录屏。保存按钮的局部 CSS Transition 单独记录,不算列表重播。刷新恢复后,六张卡片与建议的 cssAnimations 均为 0,restoreAnimationStarts 为空,保存状态和建议内容均能恢复。
- 移动操作与视觉层级
- 在 390×844 视口和四项错误状态下,取消与提交按钮均高 48px、底边为 819px,仍在视口内;两次操作都是真实触控点击,改正后的提交也能在刷新后恢复。两位盲评均确认弹窗与错误摘要没有粗顶部强调条,错误和弹窗层级仍然清楚。
- 旧错误提示、小字与占位对比仍待改进
- 字段改正后、再次提交前,旧错误摘要与逐字段错误仍显示。这符合按提交校验的约定,不是功能失败,但反馈不够及时。部分次级文字仍为 9–11px;评审 A 点测输入占位文字对比度约为 3.76:1,低于普通文字 4.5:1 的参考线。这只是局部点测,不是完整对比度认证。
局限:这组证据能说明什么,不能说明什么
本次只测试一份英文 CommonShelf 静态页面简报、一个模型,每个条件三个最终样本。视觉评审虽有六维规则,仍包含判断;一份评审对应一个匿名材料包,不是大规模用户研究或统计显著性实验。换任务、内容语言、框架或模型,结果可能不同。
功能验收只覆盖预定的六类 Chromium 场景,不等于完整产品审计。普通平板只有样式断点证据,没有独立截图;未完成 Safari、Firefox、真实触屏、屏幕阅读器、200% 缩放或完整 WCAG 检查。静态截图不能完整呈现连续动画节奏:Oil UI run-3 的透明帧足以证明反馈问题,却不能说明动画结束后的稳定画面质量。
公开演示保留生成后的实际页面与功能失败。技术中断和协议内恢复不计为候选功能失败,也不用于比较耗时;它们与生成后的独立验收是不同证据。
复现:先看证据,再用自己的运行验证
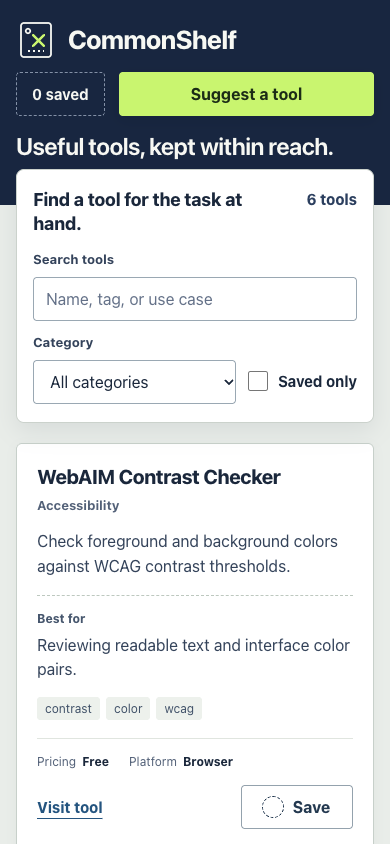
核对本文可直接查看 15 个演示、20 张初始图和 results.json。自行复测应保持同一简报、固定版本和模型,每次启用新 Agent,保留三次结果,并在生成后独立验收。公开内容数据与演示中的副本逐字节相同;下方提示是精简复测简报,不是原始冻结任务文件。
开源安装命令会安装执行时解析的版本,不保证仍是 0.24.2。严格比较时,先记录实际安装版本并使用表中的固定提交;换用新版本应视为新测试,不覆盖本次数字。
安装开源 Oil UI,记录实际版本
先在自己的任务上试用开源版;本次没有使用 Oil UI Pro。
npx skills add oil-oil/oil-ui为每个条件做三次独立生成
固定模型与内容数据,每次从新 Agent、新工作区开始,只交付一个方向;不读取或修补其他轮次,也不替换较弱结果。
分开做功能验收和匿名视觉评审
按六类场景检查 1440×900 与 390×844 页面,保留所有通过和失败。视觉评审隐去条件身份,按相同六维规则评分,公开每次结果而非只有平均值。
Build one complete CommonShelf static web app with plain HTML, CSS and JavaScript. Use the supplied content.json unchanged. Make one coherent direction without asking for a selection. At 1440×900 and 390×844, the first viewport must help a visitor find, understand and save tools. Implement combined search, category and saved-only filters; local-storage saves; a validated suggestion dialog; exactly three keyboard-operable FAQ items; actionable content-unavailable and storage-unavailable states; visible focus; and reduced motion. Keep suggestions outside the curated tool grid. Make no external requests except user-activated official links. Do not import another run or replace a weak result. Preserve every failure, then independently verify the actual page and review anonymized screenshots and runtime files.这只是同类复测的精简提示。严格复现还需固定本文所列版本,并执行六类验收场景与相同评分规则。
画廊真实案例与提示词参考
打开在线演示查看 1440px 或 390px 下的实际页面,对比不同模型与提示词做出的最终效果。
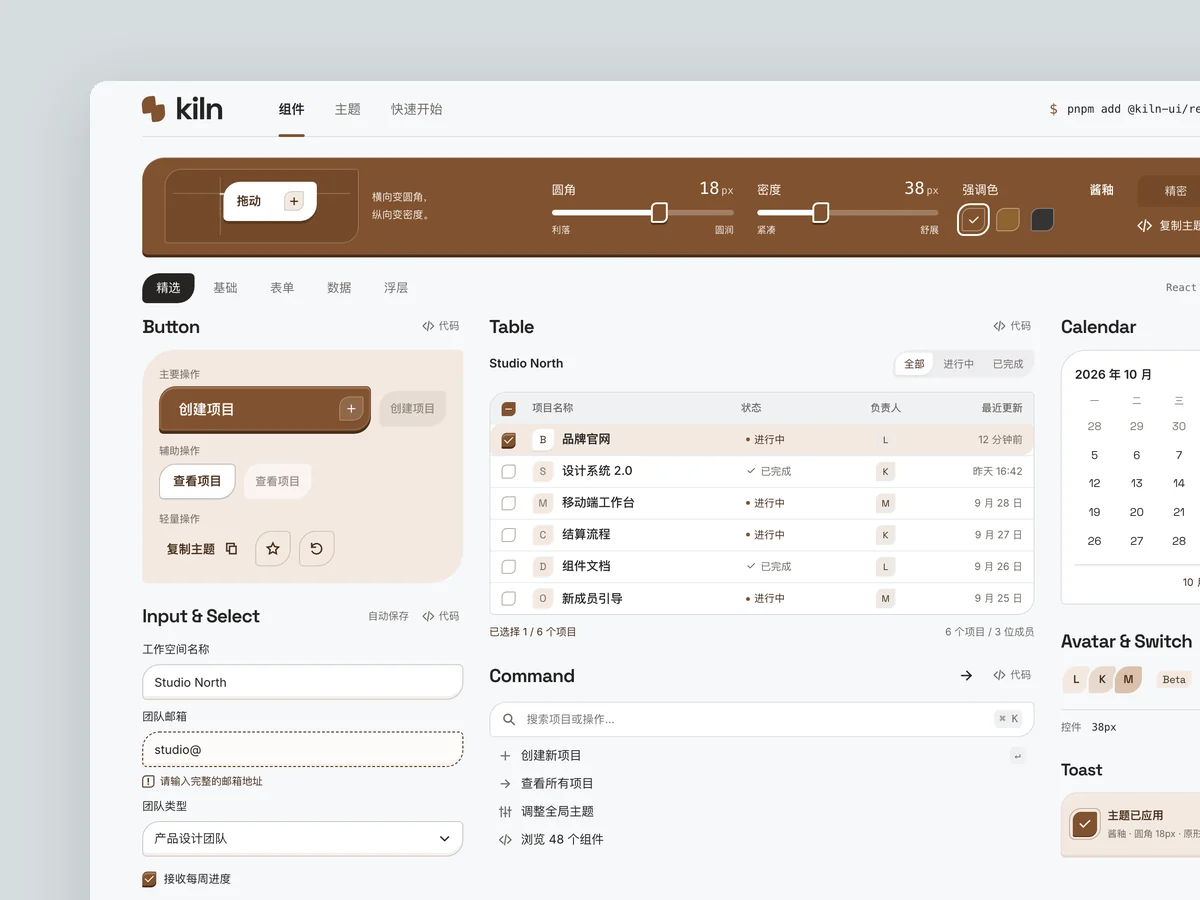
Kiln
组件库官网
产品:「Kiln」,一个给 React 开发者用的开源组件库:按钮、输入框、下拉、命令面板、弹窗、提示、表格、日期选择等 40 多个组件,支持主题定制。 做它的官网首页(可以加一个组件详情页): - 首页要直接展示真实可交互的组件,而不是截图:一块“组件墙”里放着能点、能输入、能切换的真组件。 - 气质参考一线开发者工具官网的精确与克制:黑白为主,最多一种强调色,严格的网格,等宽字体用在代码和数字上。 - 记忆点:一个主题调节器,拖动圆角、密度或强调色,整页所有组件当场一起变化。 - 要有:安装命令(可复制)、代码片段、组件分类导航、一段真实的使用数据(例如 GitHub 星数、周下载量,数字不整齐)。
查看作品与提示词 →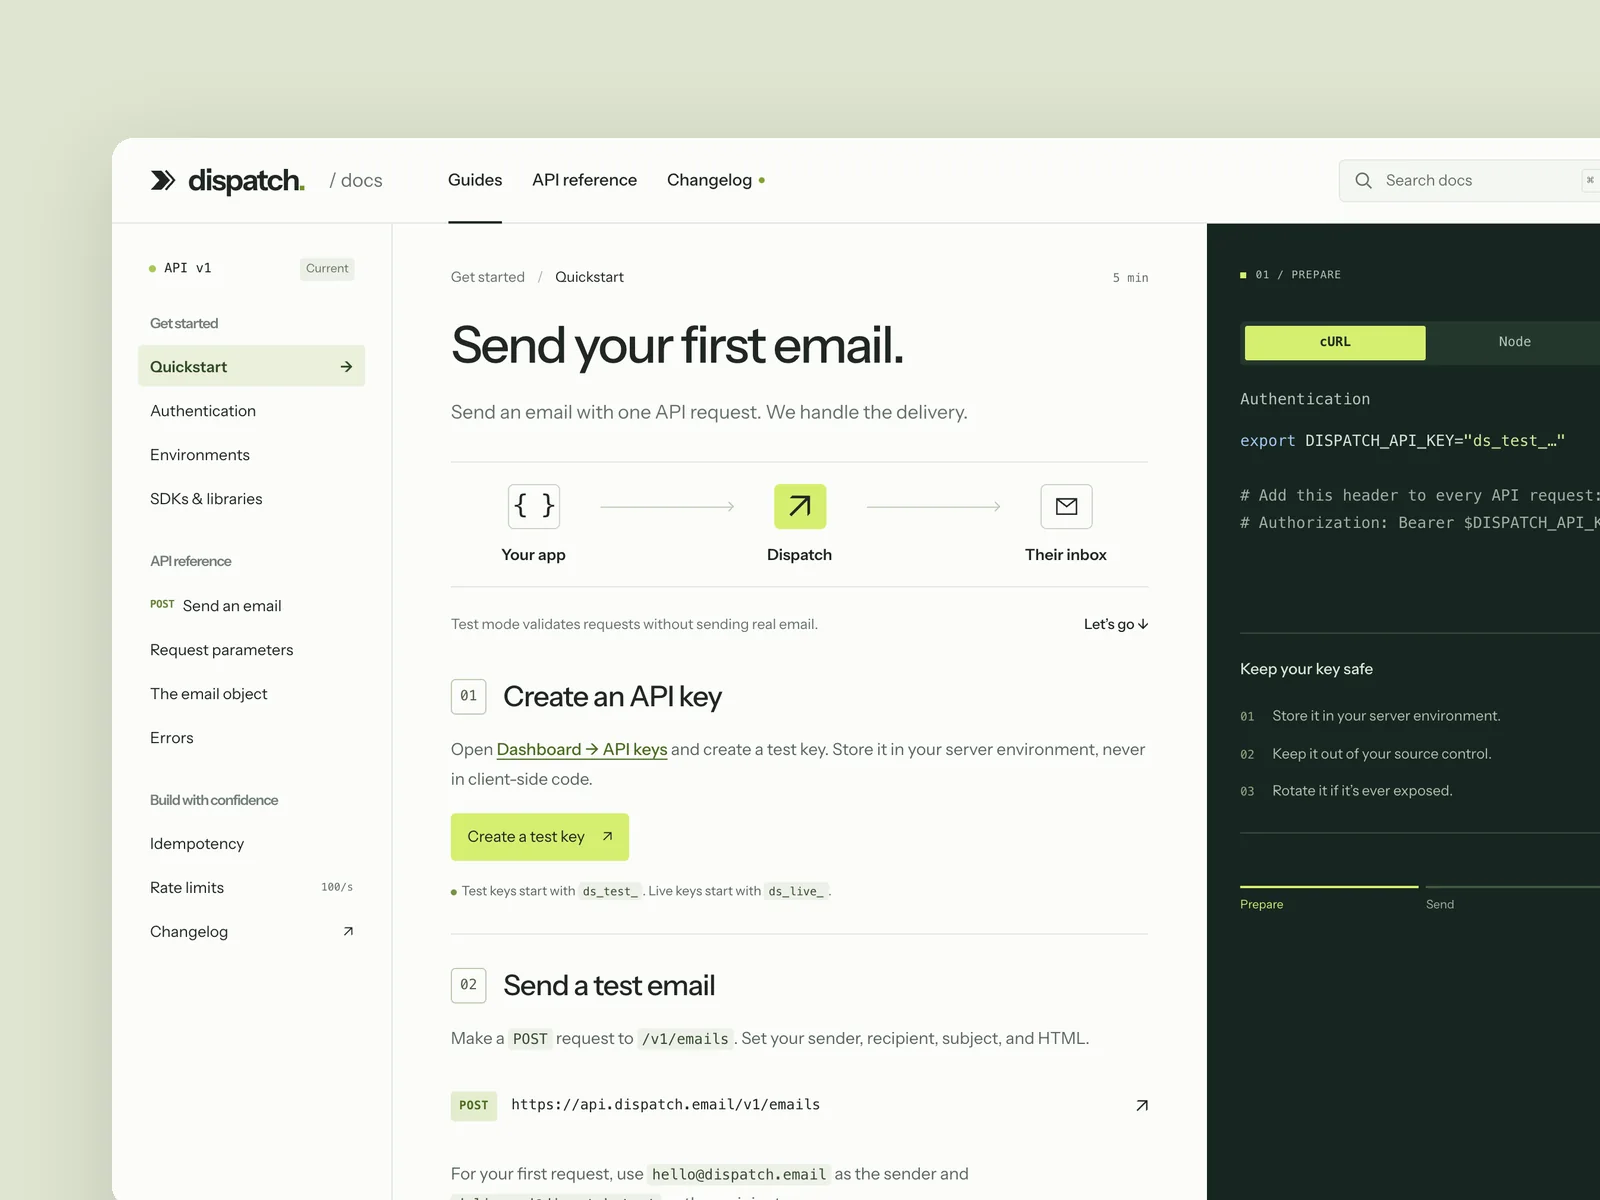
Dispatch
开发者 API 文档站
一家支付或消息类 API 公司的开发者文档站(1440×900 起,响应式到 390 宽):左侧导航、中间正文、右侧可切换语言(cURL、Node、Python)的代码示例;有快速开始、某个接口的完整参考(参数表、请求与响应示例、错误码)、搜索。 读文档时代码示例跟着当前段落走,切换语言后全站记住。设计快速开始页、接口参考页、搜索打开三个状态。
查看作品与提示词 →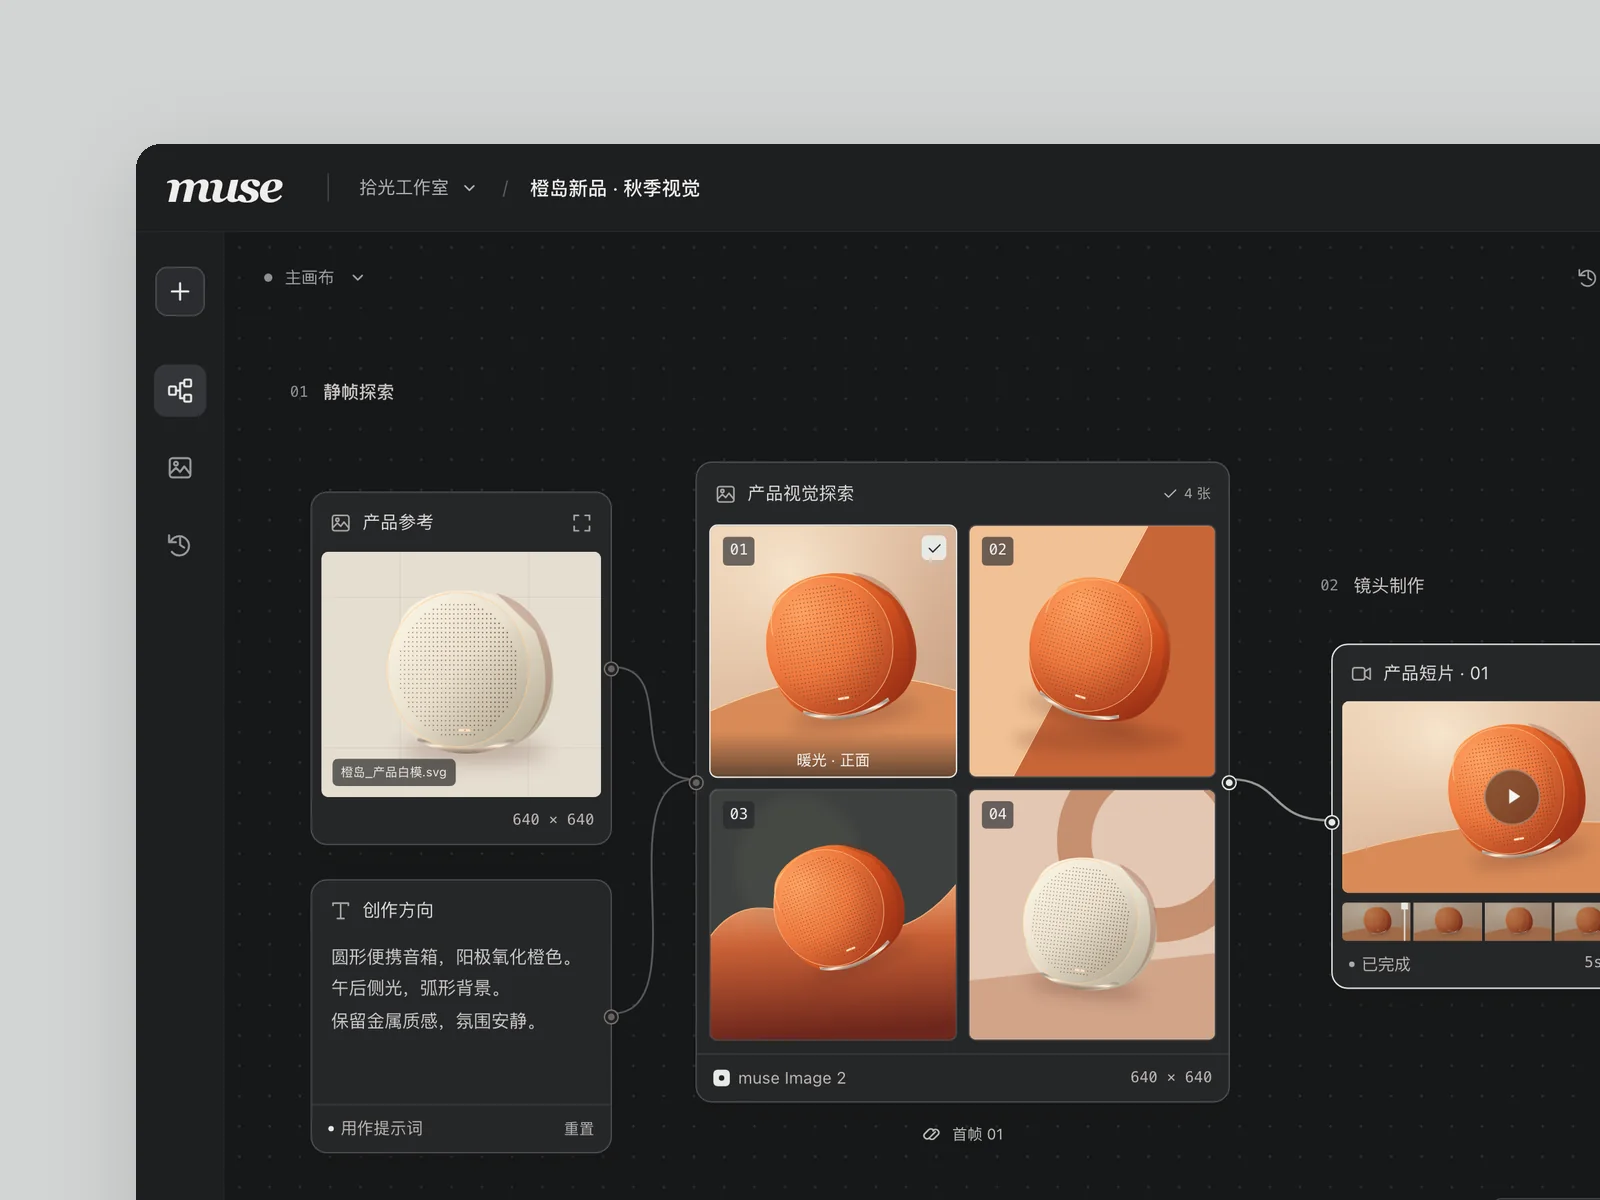
muse
AIGC 创作画布
一个给设计师和创意团队用的 AI 生图、生视频工具,所有提示词、参考图和生成结果都放在一张无限画布上。做工作区主界面。
查看作品与提示词 →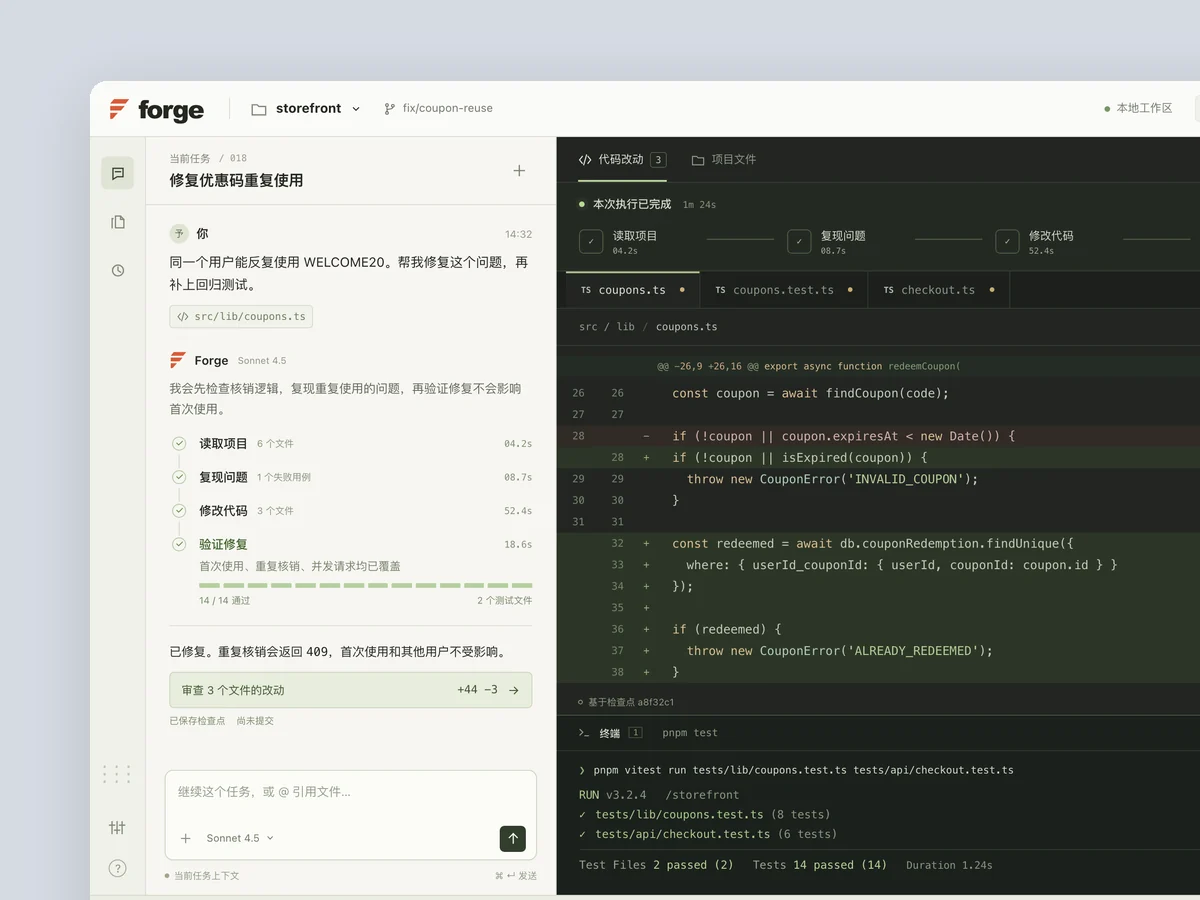
Forge
AI 编程助手
产品:「Forge」,一个桌面端的 AI 编程助手:左边是对话,右边是它正在改的代码和终端,能看到它一步步读文件、改代码、跑测试。 做它的主界面(1440×900),数据要真实(像真实项目的文件名、diff、测试输出)。 记忆点:让 AI 干活的过程看得见,步骤一个个亮起、diff 一行行出现、测试从红变绿。 再截一张“等待用户确认一处危险修改”的状态。
查看作品与提示词 →可选了解:Oil UI Pro 未参与本次横评
本次 Oil UI 数据全部来自开源版 0.24.2,Pro 未参与生成、验收或评分。先打开演示、核对失败并复跑开源版;确认自己的工作流需要更深入的方法后,再单独了解 Pro。
npx github:oil-oil/oil-cli install oil-ui-pro常见问题
这份横评能直接决定我应该安装哪款 Skill 吗?
不宜只看平均分。先按目录层级、移动端操作、动效、功能失败和源码许可证筛选,再打开对应演示,核对是否符合自己的需求。
Oil UI run-3 功能全部通过,为什么视觉只有 83 分?
功能验收确认预定行为可运行,视觉评审还看反馈是否清楚。该轮每次重建工具卡都会重播从透明开始的动画,搜索、保存和建议刷新截图多次近乎空白。这是实际可见的反馈问题,但不能证明永久丢卡,因此视觉分为 83。
无 Skill 的两次失败是否说明保存完全不可用?
不是。两轮都因 Toast 实际文本多了勾选符号与空白而未通过精确文本断言,不能据此宣称保存或持久化完全失效;但既定契约未满足,所以仍为 failed 和 5/6。
怎样核对文章里的数字和画面?
先下载 results.json,查看每次六维分数、总分和功能状态;再打开每个候选的三张桌面初始图、一张手机图和三个实际演示。手机图统一取 run-1,未按高分挑选,也不用表单截图充当主视觉。