Nightwatch
Resumen del diseño
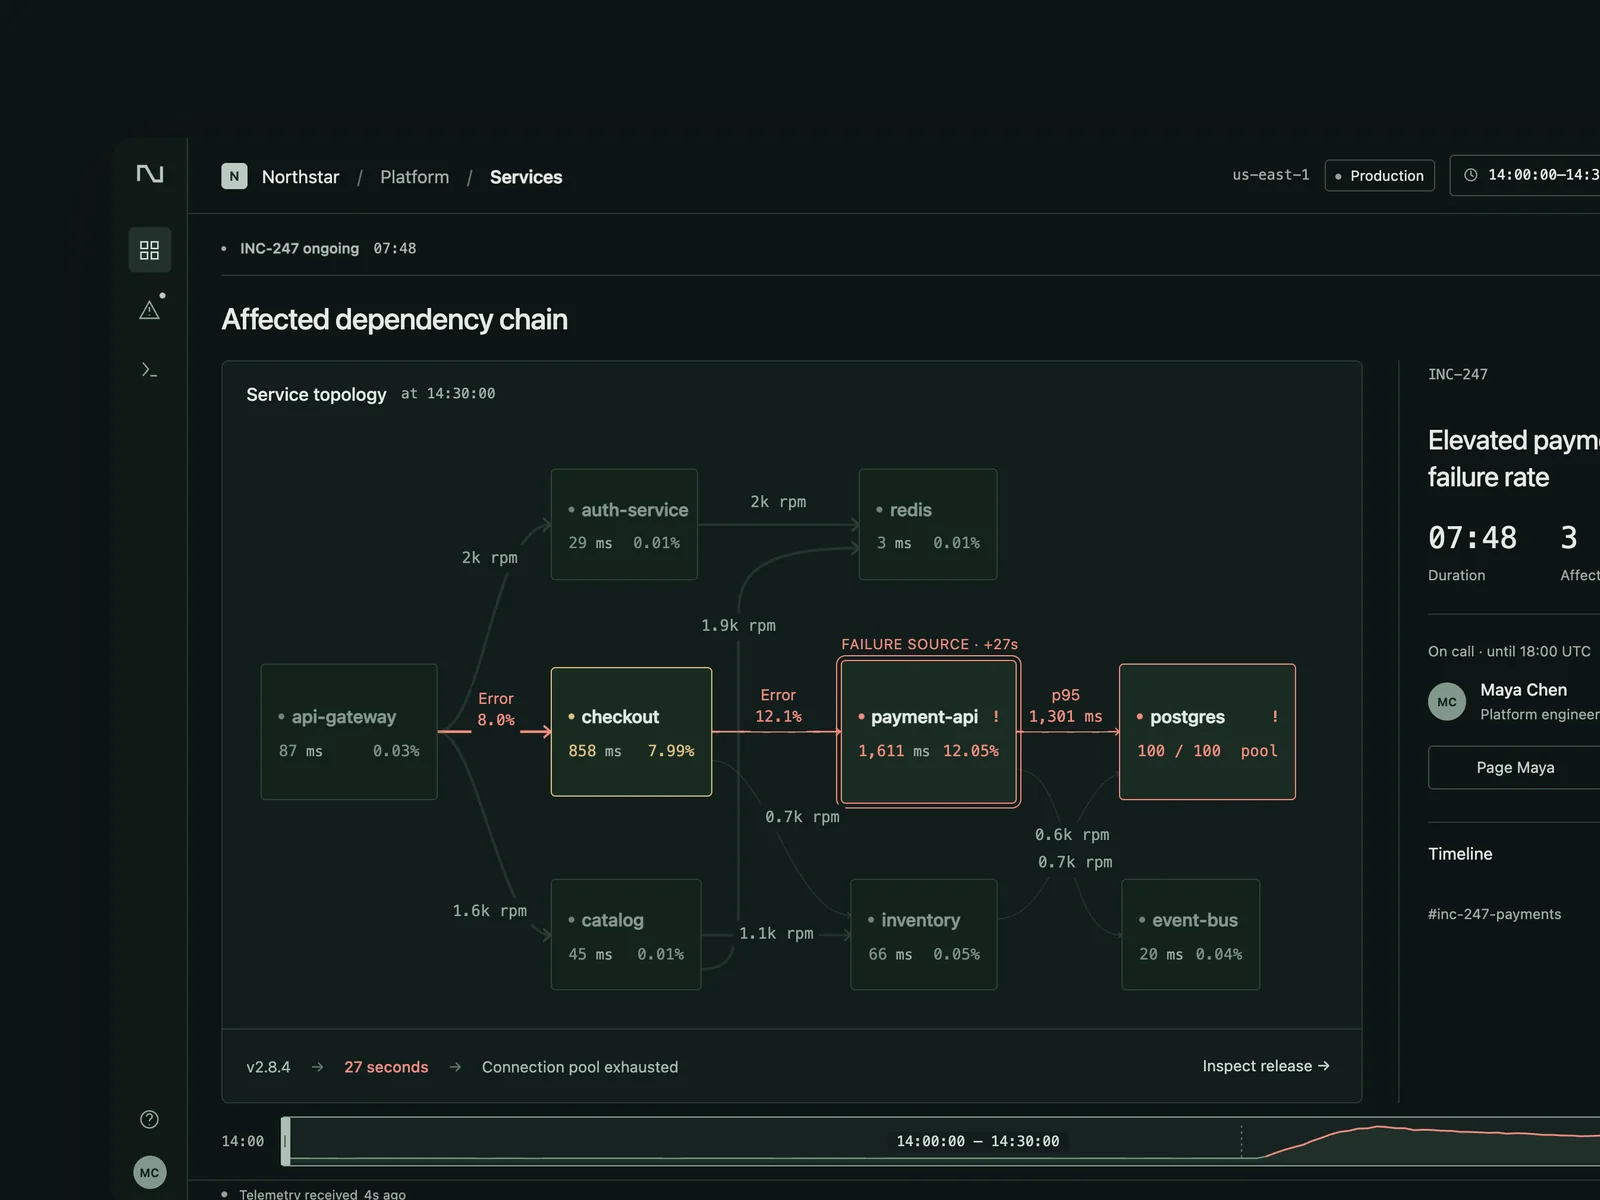
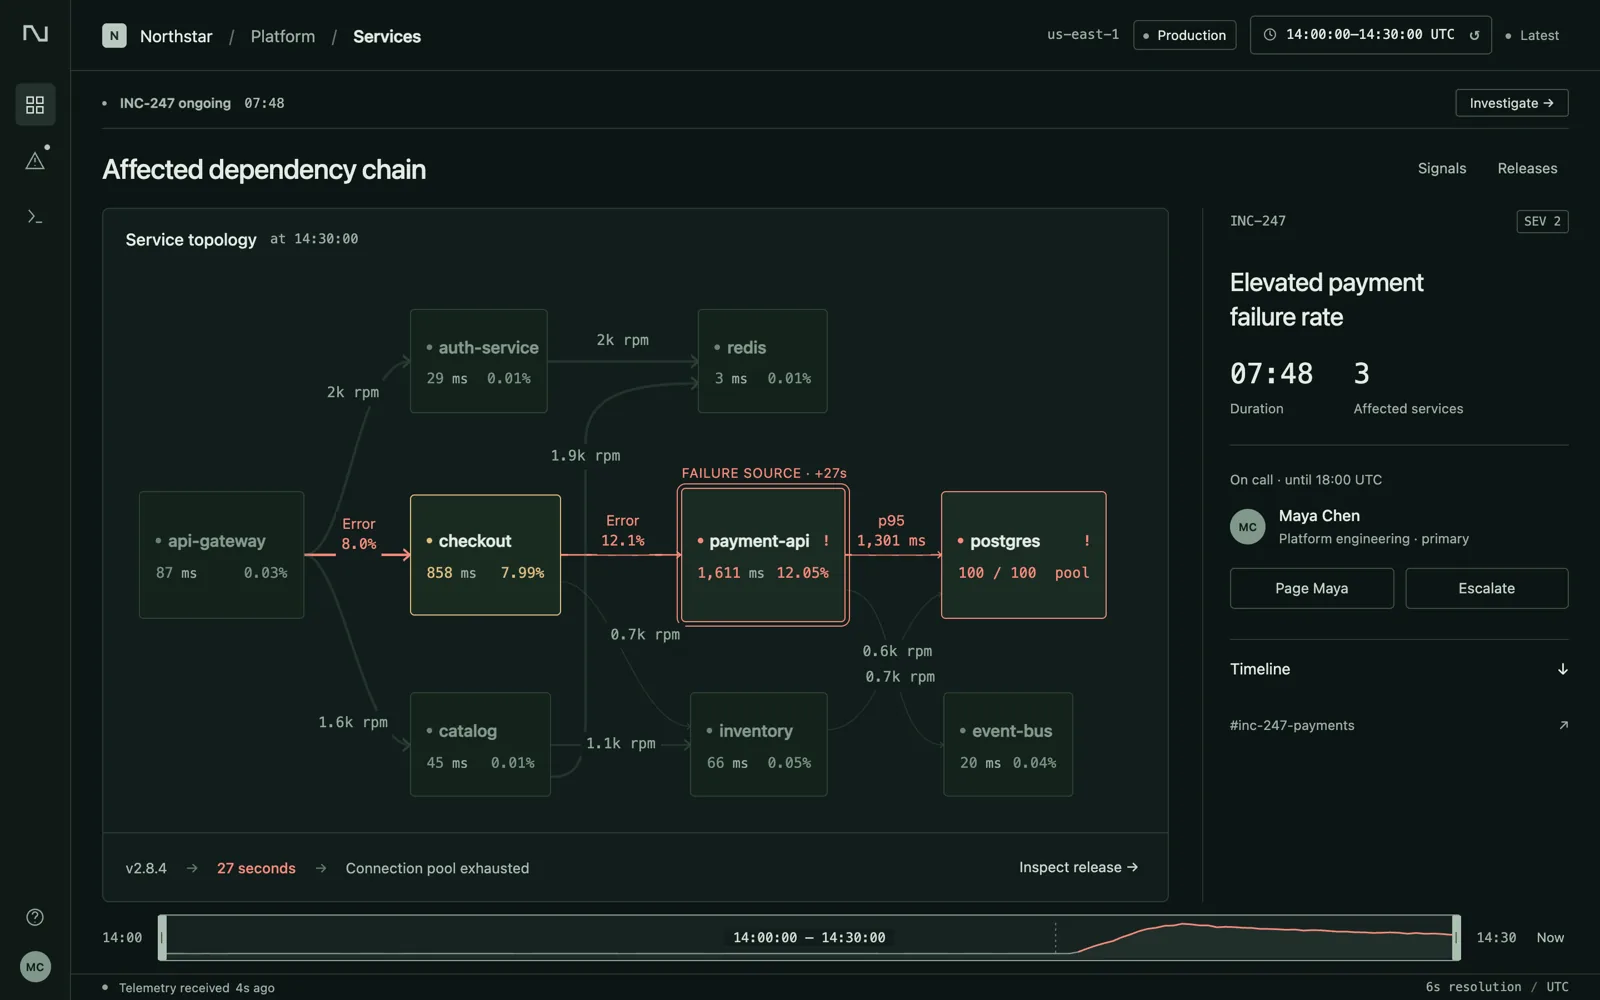
Nightwatch conecta la topología de servicios, un selector global de intervalo temporal, registros, trazas y un diff de versión en una sola ruta de investigación de incidentes. Las vistas saludable, de incidente y de investigación comparten telemetría local y siguen el pico de errores de payment-api hasta el agotamiento del grupo de conexiones 27 segundos después de v2.8.4.
Registro de verificación
VerificadoUna revisión independiente de fotogramas continuos confirmó que estrechar el intervalo hacia el pico de errores ya no produce saltos hacia atrás, y que el registro seleccionado, la solicitud 77d2c1a9, la traza y la inspección de versión conservan identidades y momentos coincidentes.
Límites de la verificaciónLa revisión independiente abarcó solo capturas y grabaciones, no intervalos arbitrarios, recuperación mediante URL ni gestión de fallos. La telemetría es local con datos semilla; Page y Escalate generan borradores copiables, no notificaciones externas.
Prompt
Una herramienta de supervisión y guardia para un equipo de plataforma de tamaño medio (1440×900), con interfaz en inglés: topología de servicios, gráficos de latencia, tasa de errores y tráfico, despliegues recientes, registros y trazas; durante un incidente, muestra alertas, la persona de guardia y una cronología del incidente.
El desarrollo de un incidente es el núcleo: el servicio que falla y los servicios descendentes afectados deben resultar evidentes en la topología. Al arrastrar el intervalo temporal, los gráficos, los marcadores de despliegue y los registros se alinean para que se pueda ver qué despliegue causó el problema.
Diseña tres estados: una visión general saludable; un incidente en curso con una alerta y la ruta afectada resaltada en la topología; y registros y trazas abiertos en el pico de errores para identificar el despliegue responsable.
Ver el prompt original en chino
一个给中等规模平台团队用的监控和值班工具(1440×900),界面用英文:服务拓扑,延迟、错误率、流量曲线,最近的发布,日志和调用链;出故障时有告警、当前值班人和事件时间线。
故障正在发生是这件作品的核心:拓扑上出问题的服务和受牵连的下游一眼能看到;拖动时间范围,曲线、发布标记和日志对齐,能看出是哪一次发布引起的。
设计三个状态:一切正常的总览、故障进行中(告警触发、拓扑标出受影响路径)、在错误峰值上展开日志和调用链并定位到那次发布。