Resumo do design
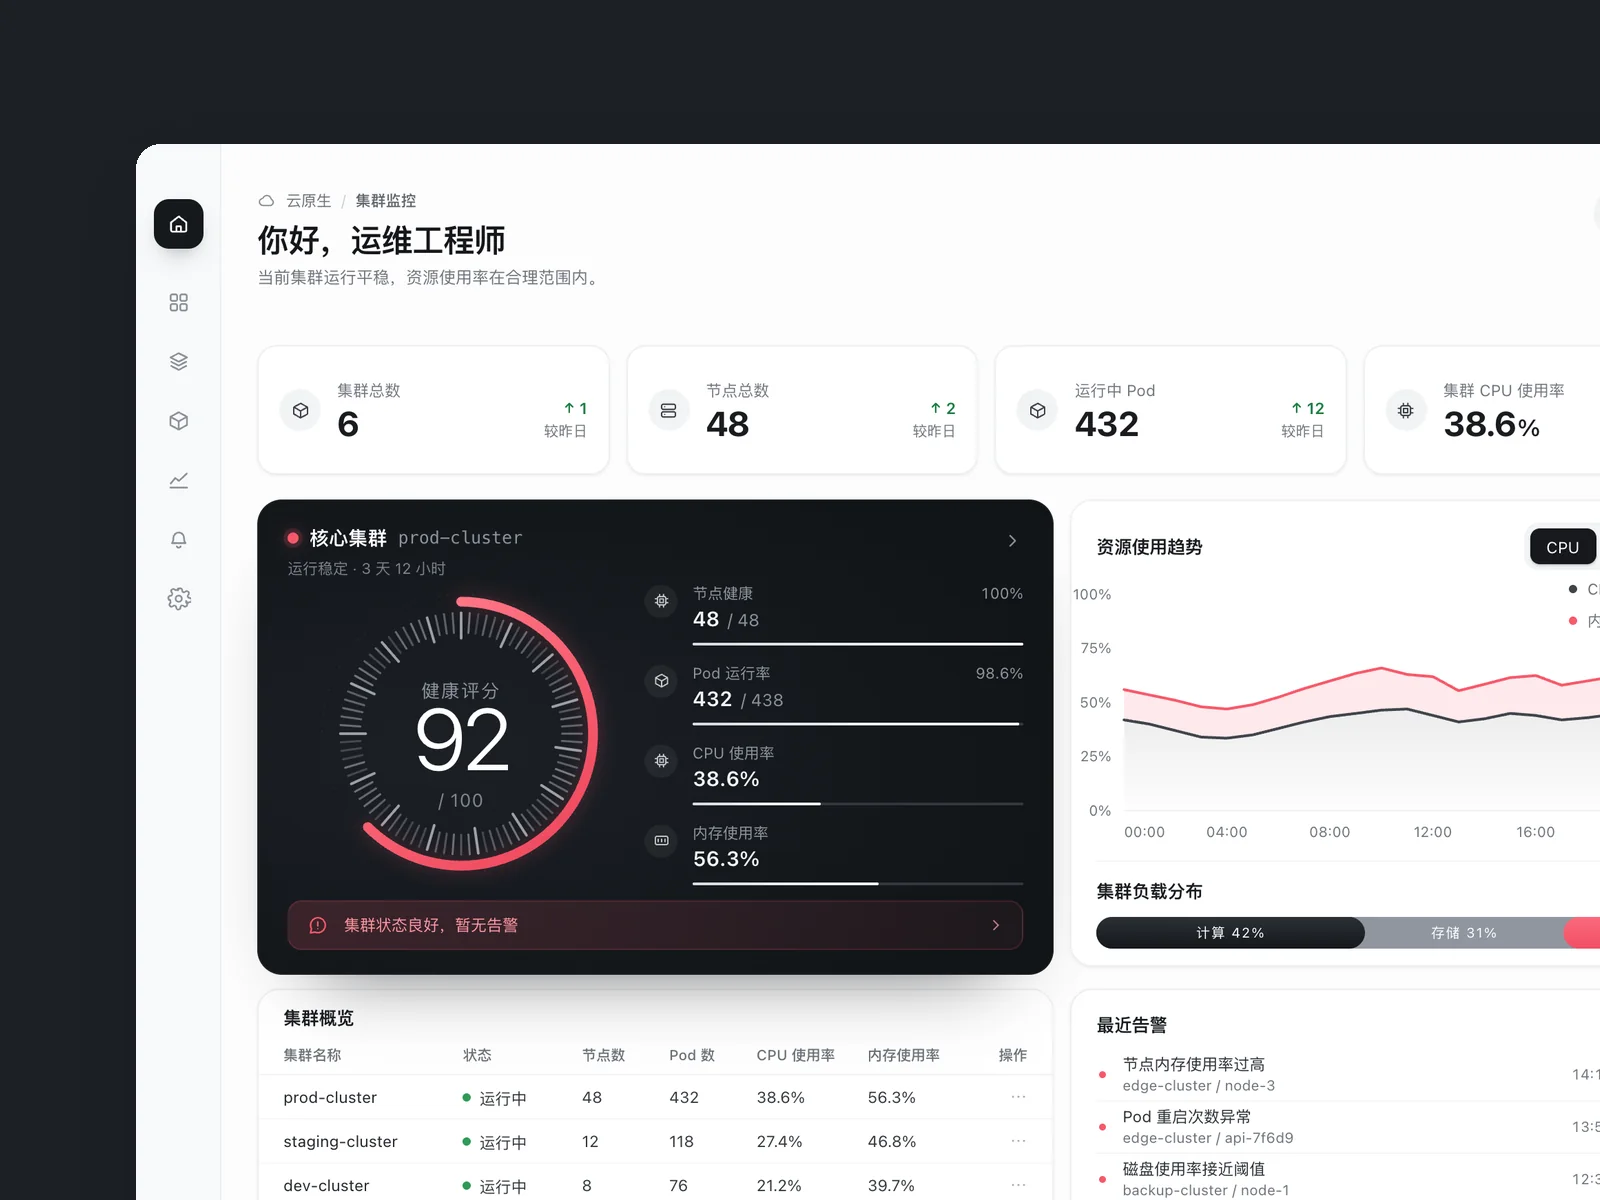
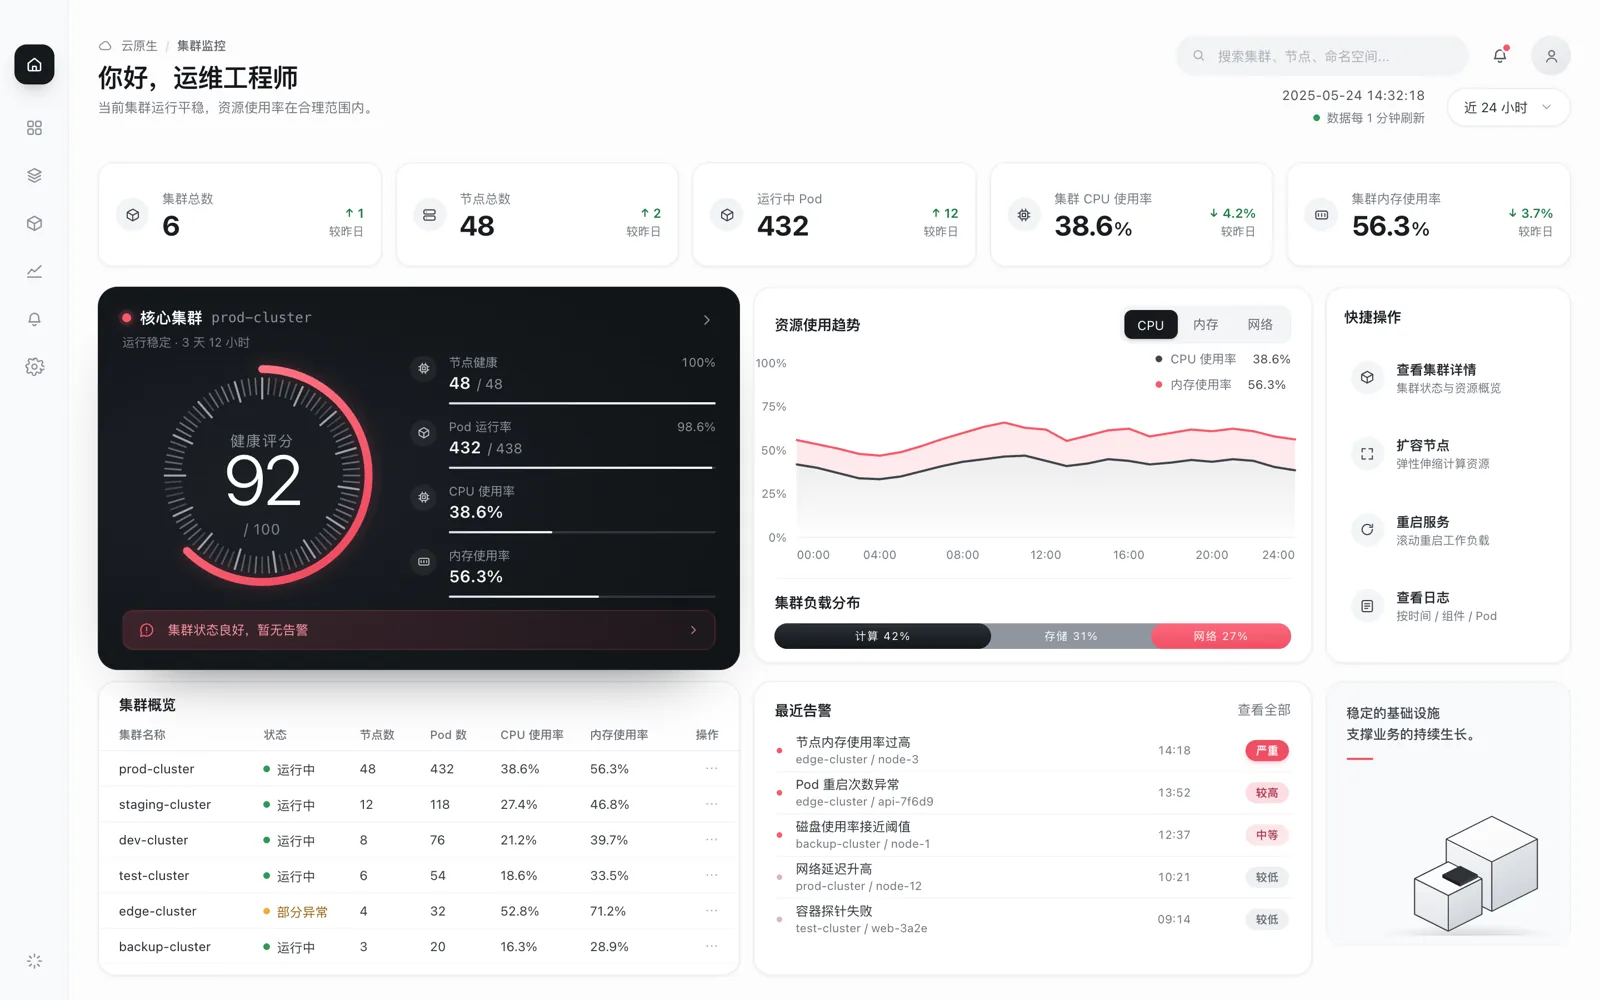
O workspace Cloud Native · Monitor de Clusters combina trilha compacta de ícones, canvas cinza-frio e mostrador de saúde obsidiana 'Core Cluster prod-cluster' (anel de pontuação 92/100 e quatro marcas d'água de recursos) em um console SRE de tela única. Apresenta cinco métricas de topo em 6 clusters, 48 nós e 432 Pods ativos, gráfico de séries duplas Resource Usage Trend em CPU/Memory/Network e três janelas de tempo, barra de carga Compute/Storage/Network, ações rápidas de escalonamento e reinício, tabela de seis clusters e alertas recentes.
Prompt
Projete e construa o workspace operacional 'Cloud Native · Cluster Monitor' (1440×900): trilha compacta de ícones à esquerda combinada a uma barra superior contendo busca global de cluster/nó/Pod, selo de status saudável e ação New Cluster. A linha superior alinha cinco métricas centrais: Total Clusters (6), Total Nodes (48), Running Pods (432), Cluster CPU Usage (38.6%) e Cluster Memory Usage (56.3%). A linha do meio posiciona um mostrador de saúde obsidiana 'Core Cluster prod-cluster' (anel de pontuação 92/100 além de marcas d'água de CPU, memória, disco e rede) à esquerda, um gráfico de séries duplas Resource Usage Trend (alternando entre CPU / Memory / Network e Last 24h / 7d / 30d) com barra segmentada Cluster Load Distribution (Compute 42%, Storage 31%, Network 27%) ao centro e três Quick Actions (Node Scaling, Rolling Restart, View Logs) à direita. A linha inferior combina uma tabela de seis clusters (prod / staging / dev / test / edge / backup-cluster), lista de Recent Alerts e cartão ilustrativo isométrico de status do cluster.
Alternância multimétrica de tendências, filtragem ao vivo de clusters e ações operacionais em ciclo fechado são o núcleo desta peça: alternar métricas e janelas de tempo redesenha a curva de séries duplas, o campo de busca filtra linhas de clusters em tempo real e clicar em New Cluster, Node Scaling, Rolling Restart, View Logs ou All Alerts abre o modal de ação correspondente.
Ver original em chinês
设计并实现「云原生 · 集群监控」运维工作台(1440×900):左侧采用紧凑图标导航栏,顶部提供集群/节点/Pod 全局搜索、运行正常状态徽章与新建集群入口。首屏顶部横向排列集群总数(6)、节点总数(48)、运行中 Pod(432)、集群 CPU 使用率(38.6%)与集群内存使用率(56.3%)五项核心指标;中区左侧为曜石黑「核心集群 prod-cluster」健康度表盘(92/100 评分环及 CPU、内存、磁盘、网络四维水位条),中区中央为支持 CPU/内存/网络与近 24 小时/近 7 天/近 30 天切换的资源使用趋势双线图及计算(42%)、存储(31%)、网络(27%)负载分布条,右侧为节点扩缩容、滚动重启与查看日志三项快捷操作;底部并置六套集群列表(prod / staging / dev / test / edge / backup-cluster)、最近告警列表与云原生集群状态插画卡。
多维监控趋势切换、集群检索与运维动作闭环是这件作品的核心:切换监控指标与时间跨度实时更新双序列曲线,搜索框实时过滤集群行,点击新建集群、扩缩容、滚动重启、查看日志或全部告警均可打开对应操作面板。