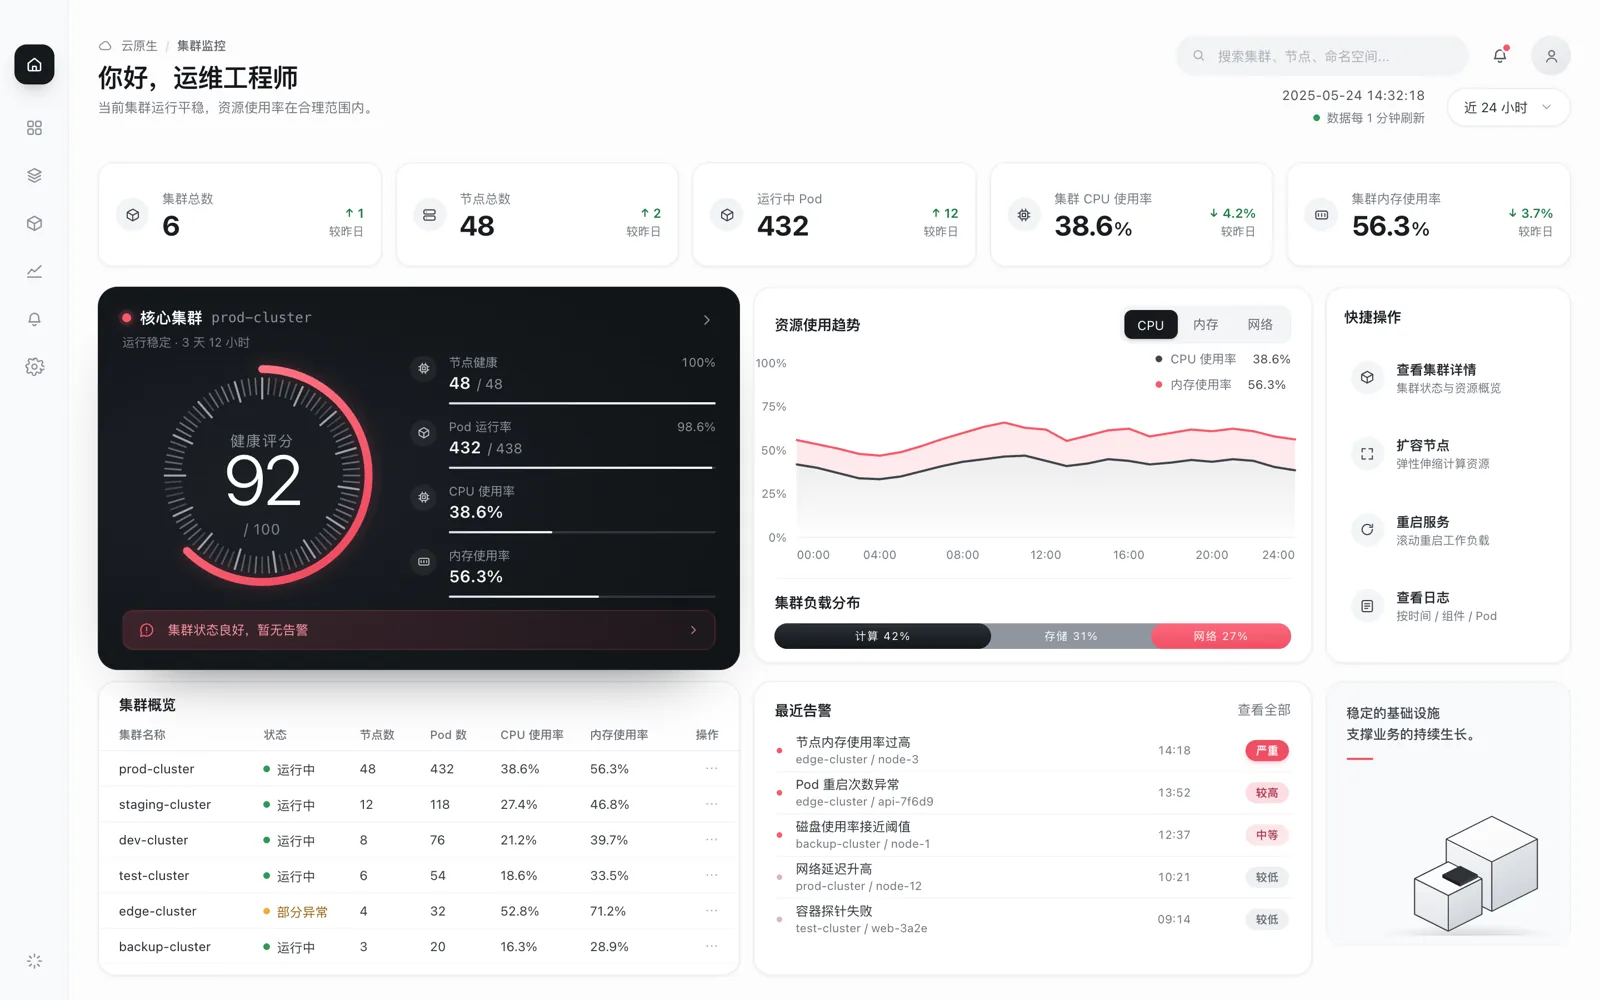
Résumé du design
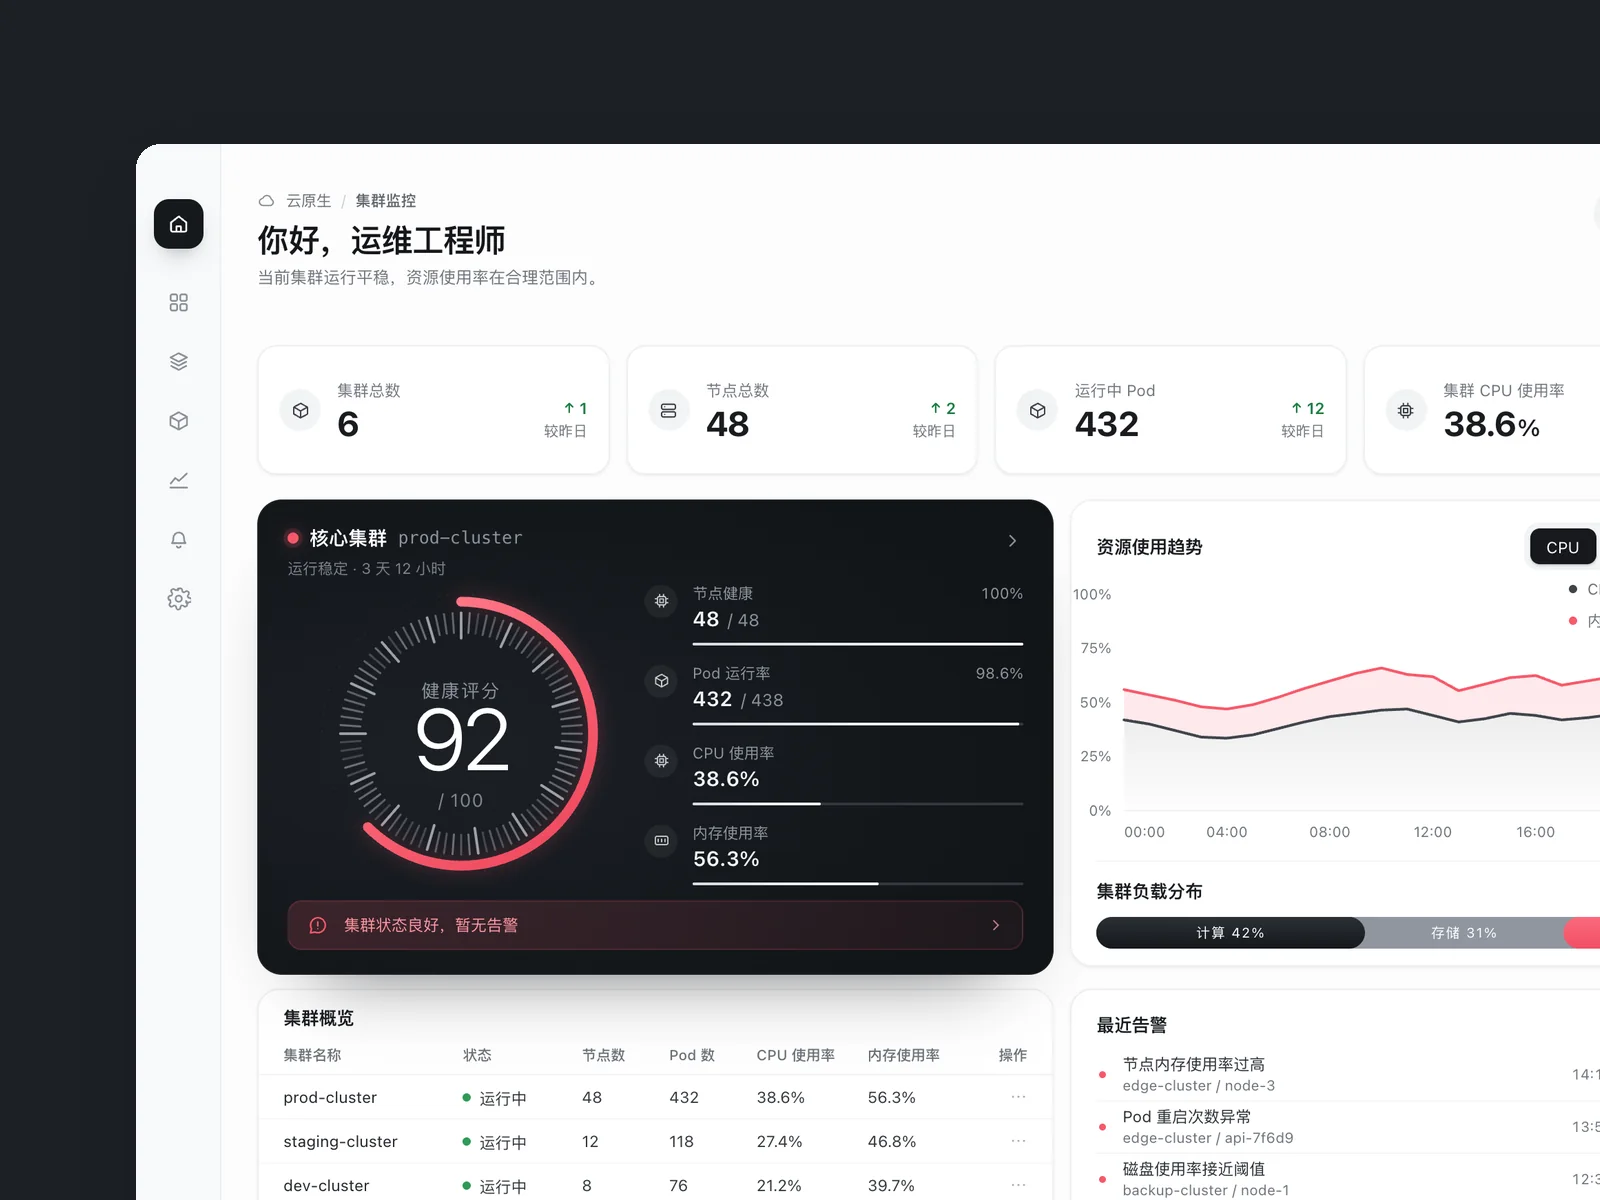
L'espace Cloud Native · Moniteur de clusters réunit rail d'icônes compact, canevas gris froid et cadran de santé obsidienne « Core Cluster prod-cluster » (anneau de score 92/100 et quatre repères de ressources) dans une console SRE sur un seul écran. Il présente cinq indicateurs supérieurs couvrant 6 clusters, 48 nœuds et 432 Pods actifs, un graphique double série Resource Usage Trend sur CPU/Memory/Network et trois fenêtres temporelles, une barre de charge Compute/Storage/Network, des actions rapides de mise à l'échelle et de redémarrage, un tableau à six clusters et les alertes récentes.
Prompt
Concevoir et bâtir l'espace opérationnel « Cloud Native · Cluster Monitor » (1440×900) : un rail compact d'icônes à gauche associé à une barre supérieure contenant recherche globale cluster/nœud/Pod, badge d'état sain et action New Cluster. La rangée supérieure aligne cinq indicateurs clés : Total Clusters (6), Total Nodes (48), Running Pods (432), Cluster CPU Usage (38.6%) et Cluster Memory Usage (56.3%). La rangée médiane place à gauche un cadran de santé obsidienne « Core Cluster prod-cluster » (anneau de score 92/100 plus jauges CPU, mémoire, disque et réseau), au centre un graphique à double série Resource Usage Trend (basculant entre CPU / Memory / Network et Last 24h / 7d / 30d) avec barre segmentée Cluster Load Distribution (Compute 42 %, Storage 31 %, Network 27 %), et à droite trois Quick Actions (Node Scaling, Rolling Restart, View Logs). La rangée inférieure combine un tableau de six clusters (prod / staging / dev / test / edge / backup-cluster), une liste Recent Alerts et une carte d'illustration isométrique d'état de cluster.
Le changement de courbes multi-métriques, le filtrage en direct des clusters et les actions d'exploitation en boucle fermée sont au cœur du projet : changer de métrique ou de fenêtre temporelle redessine la courbe à double série, le champ de recherche filtre les lignes de clusters en temps réel et cliquer sur New Cluster, Node Scaling, Rolling Restart, View Logs ou All Alerts ouvre la fenêtre d'action correspondante.
Voir l’original en chinois
设计并实现「云原生 · 集群监控」运维工作台(1440×900):左侧采用紧凑图标导航栏,顶部提供集群/节点/Pod 全局搜索、运行正常状态徽章与新建集群入口。首屏顶部横向排列集群总数(6)、节点总数(48)、运行中 Pod(432)、集群 CPU 使用率(38.6%)与集群内存使用率(56.3%)五项核心指标;中区左侧为曜石黑「核心集群 prod-cluster」健康度表盘(92/100 评分环及 CPU、内存、磁盘、网络四维水位条),中区中央为支持 CPU/内存/网络与近 24 小时/近 7 天/近 30 天切换的资源使用趋势双线图及计算(42%)、存储(31%)、网络(27%)负载分布条,右侧为节点扩缩容、滚动重启与查看日志三项快捷操作;底部并置六套集群列表(prod / staging / dev / test / edge / backup-cluster)、最近告警列表与云原生集群状态插画卡。
多维监控趋势切换、集群检索与运维动作闭环是这件作品的核心:切换监控指标与时间跨度实时更新双序列曲线,搜索框实时过滤集群行,点击新建集群、扩缩容、滚动重启、查看日志或全部告警均可打开对应操作面板。