Designüberblick
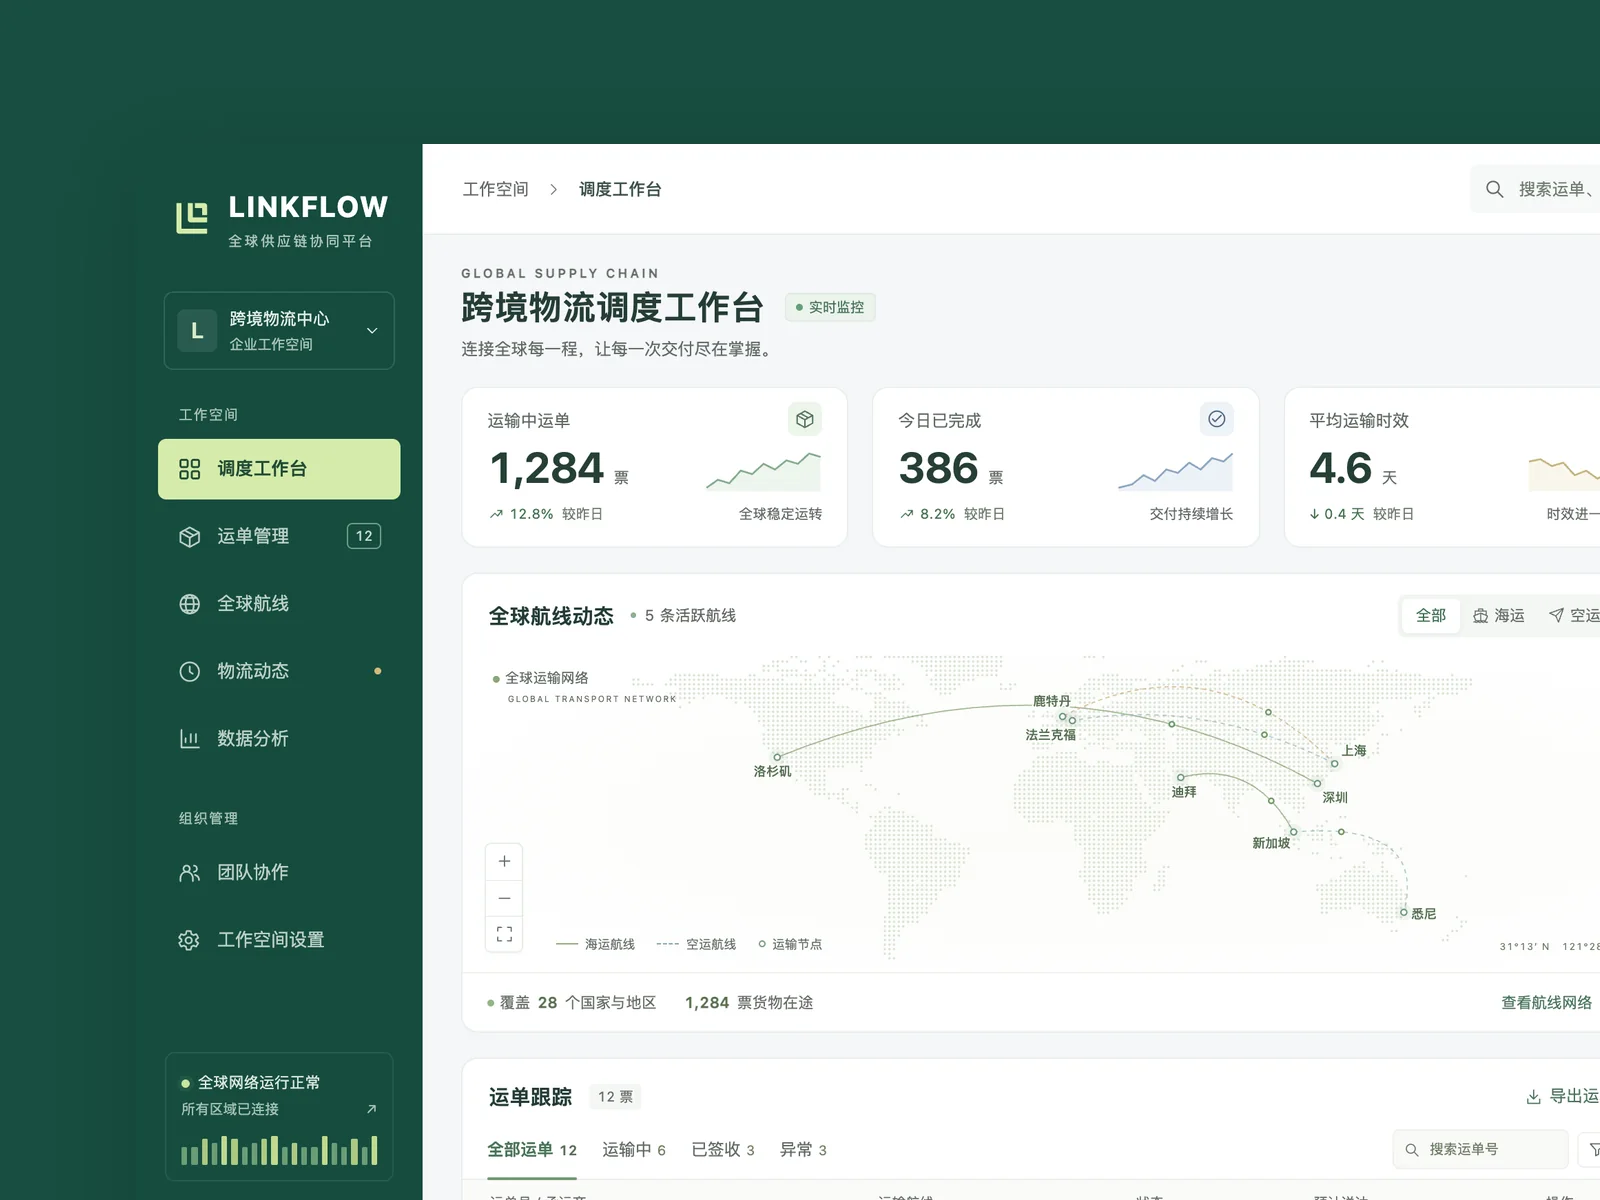
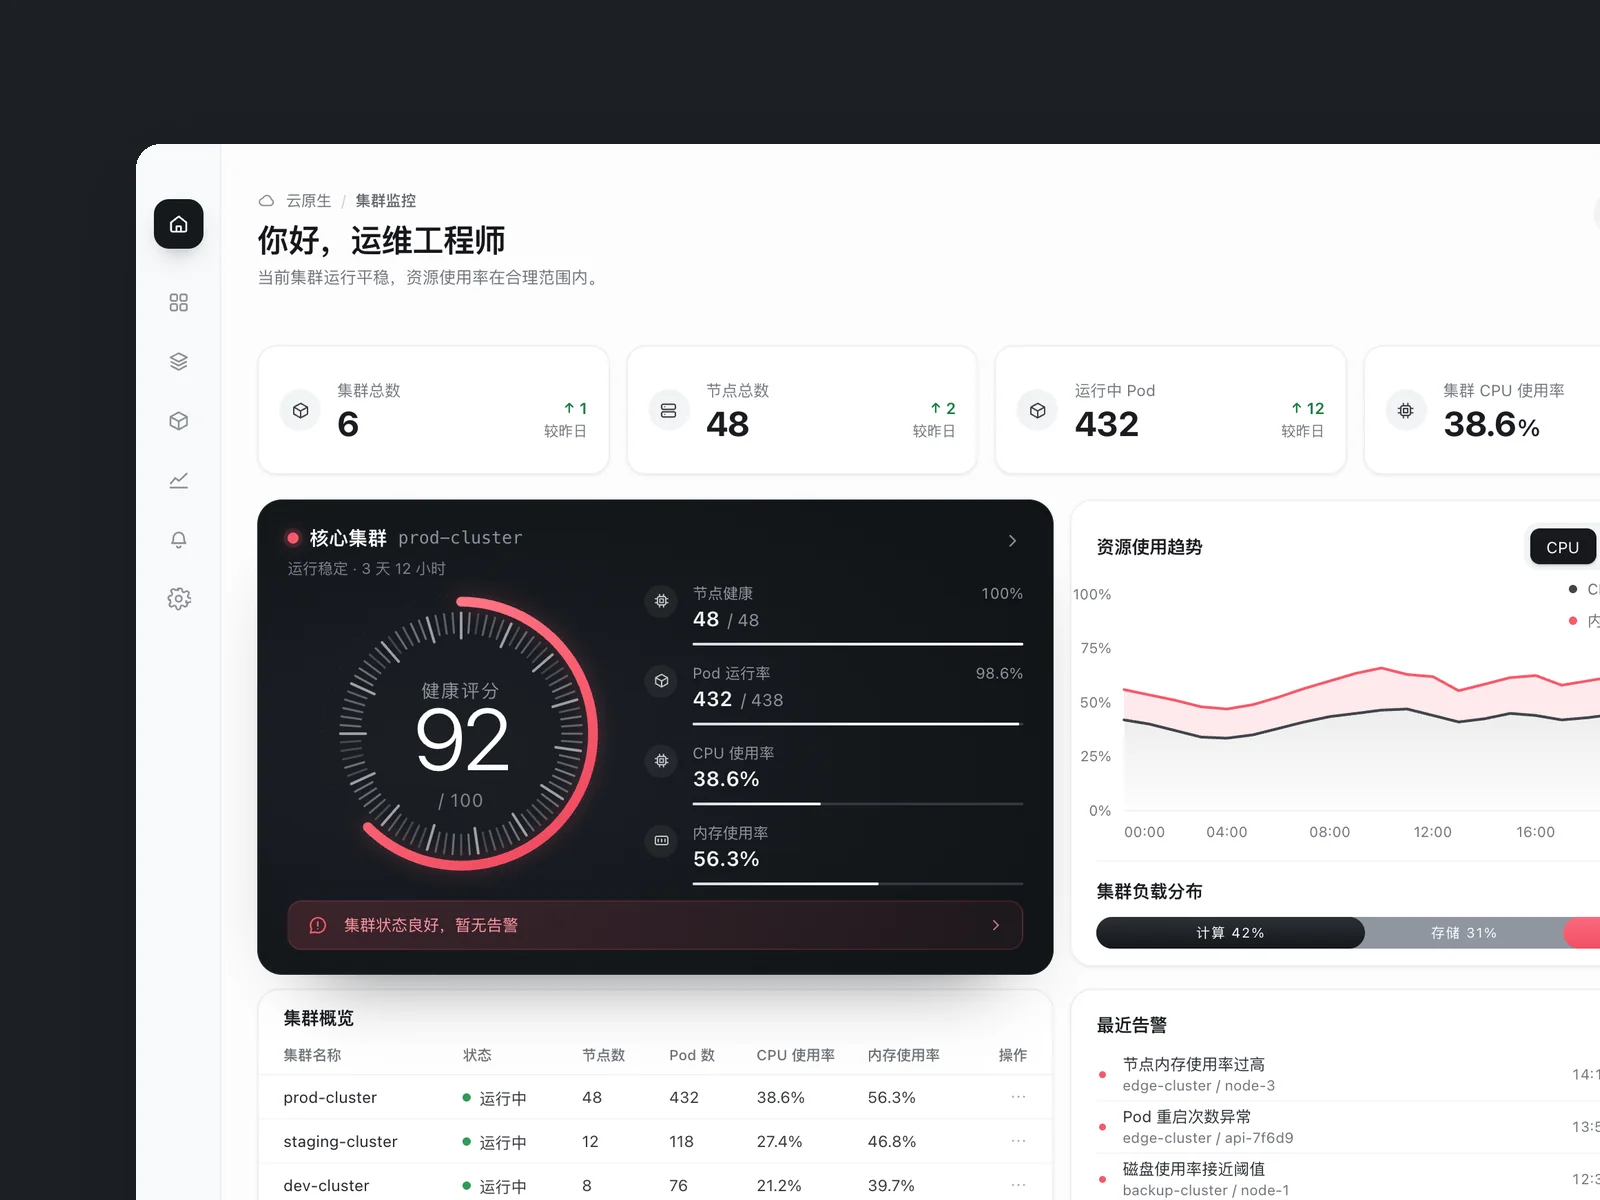
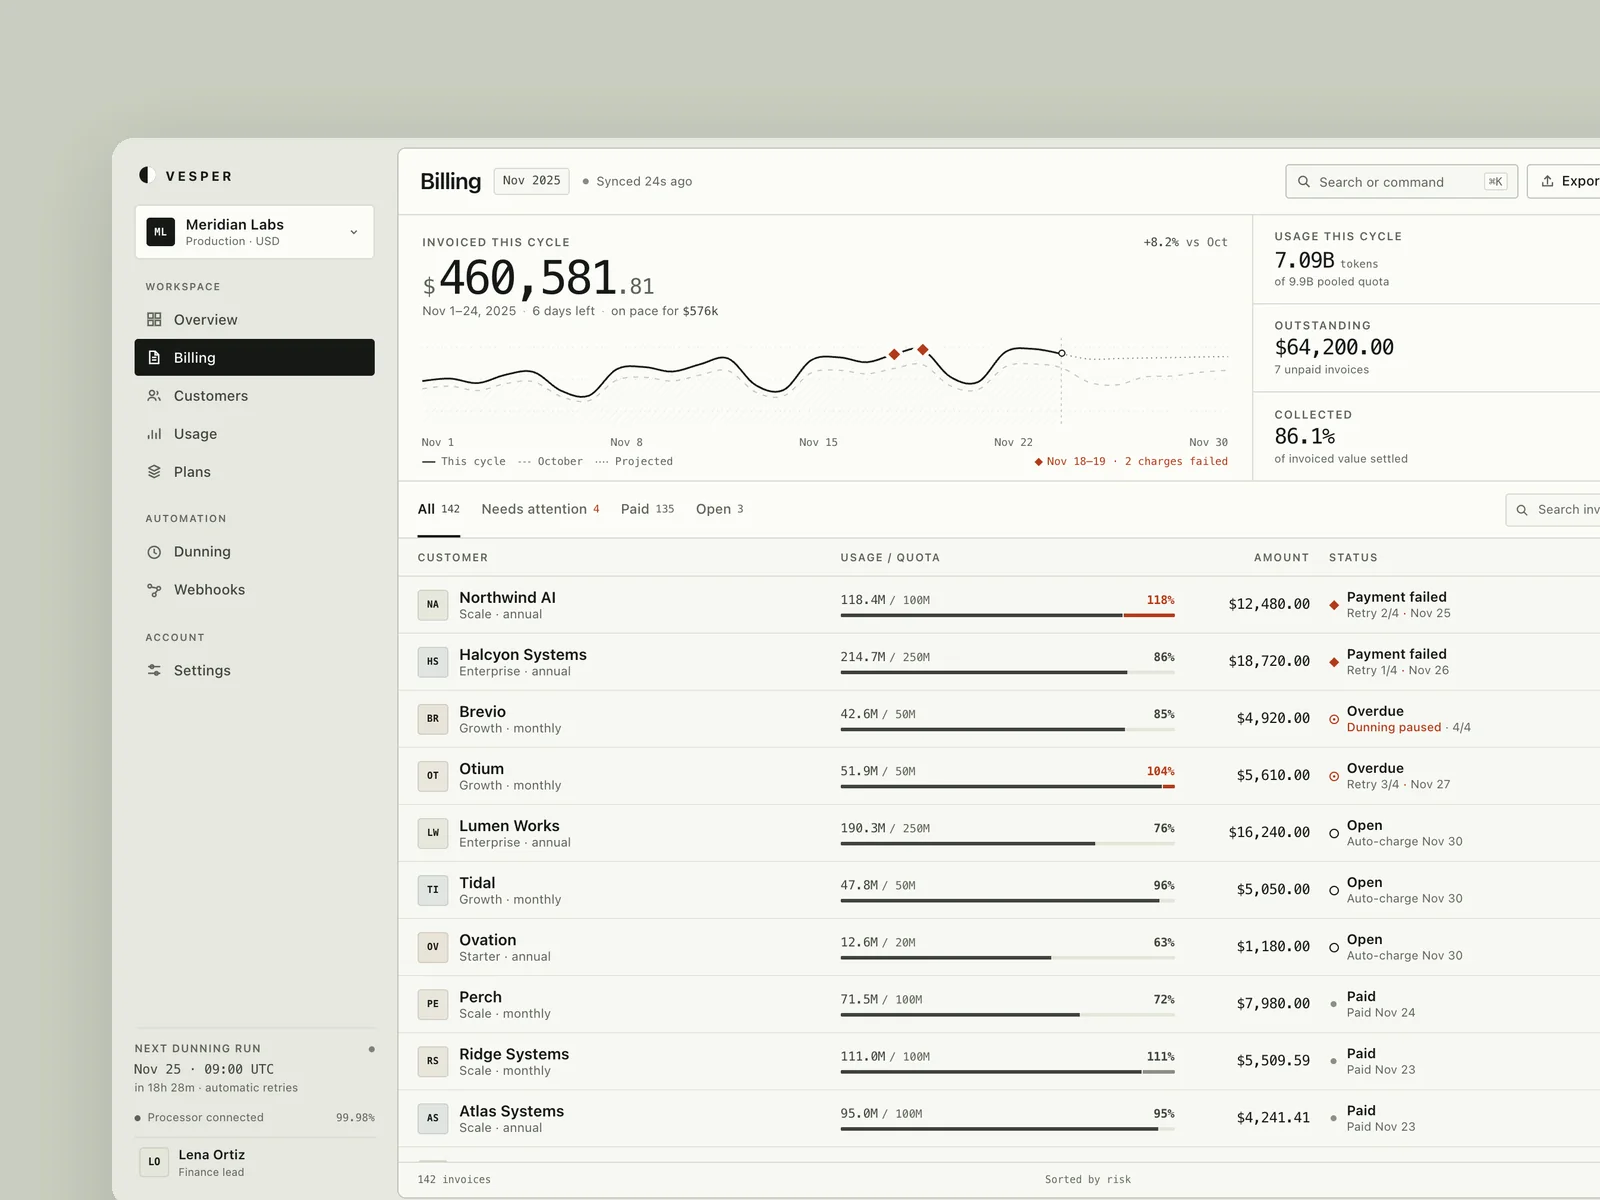
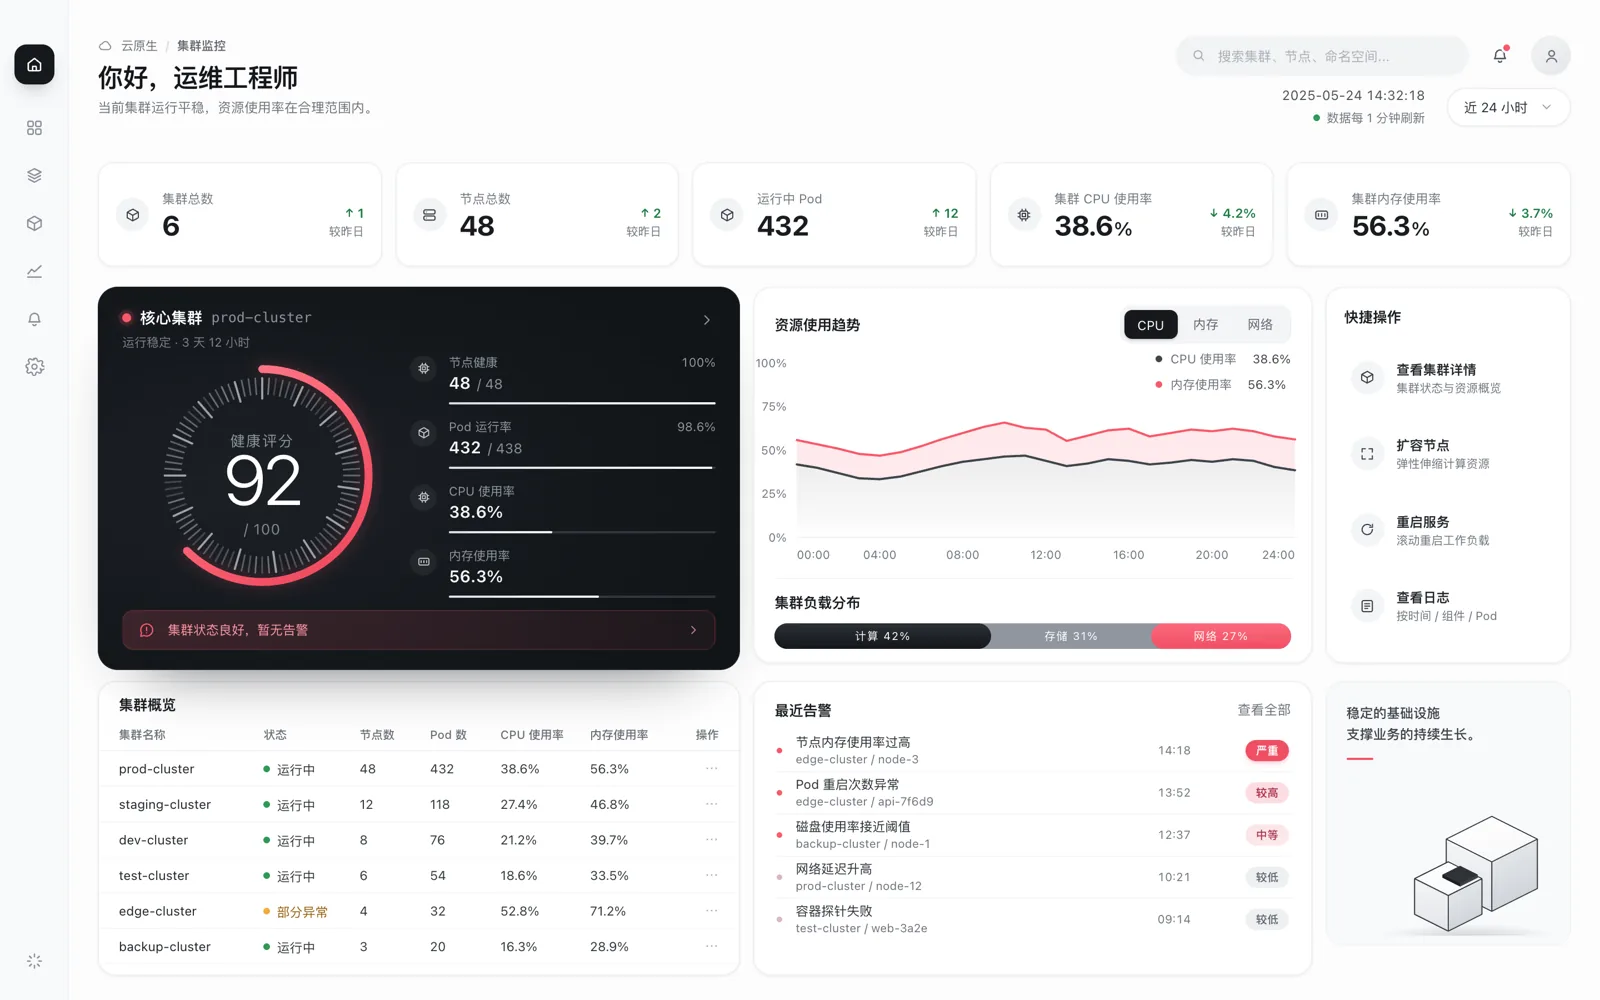
Der Arbeitsbereich „Cloud Native · Cluster-Monitoring“ vereint eine kompakte Icon-Leiste, eine kühlgraue Fläche und eine obsidianschwarze Gesundheitsanzeige für „Core Cluster prod-cluster“ (92/100-Ring und vier Ressourcenbalken) in einer einsichtigen SRE-Konsole. Er bietet fünf globale Kennzahlen über 6 Cluster, 48 Nodes und 432 laufende Pods, ein zweireihiges Ressourcentrend-Diagramm über CPU/Speicher/Netzwerk und drei Zeitfenster, einen Compute-/Storage-/Netzwerk-Lastbalken, Schnellaktionen für Skalierung und Neustart, eine Sechs-Cluster-Tabelle und aktuelle Warnmeldungen.
Prompt
Entwerfen und implementieren Sie den Betriebsarbeitsbereich „Cloud Native · Cluster-Monitoring“ (1440×900): links eine kompakte Icon-Seitenleiste, oben eine globale Cluster-/Node-/Pod-Suche, ein Statusabzeichen für Normalbetrieb und die Aktion „Neuer Cluster“. Die oberste Reihe zeigt fünf Kernmetriken: Cluster gesamt (6), Nodes gesamt (48), laufende Pods (432), Cluster-CPU-Auslastung (38.6%) und Cluster-Speicherauslastung (56.3%). In der mittleren Reihe stehen links eine obsidianschwarze Gesundheitsanzeige für „Core Cluster prod-cluster“ (92/100-Bewertungsring sowie CPU-, Speicher-, Festplatten- und Netzwerk-Füllstände), in der Mitte ein zweireihiges Ressourcentrend-Liniendiagramm (umschaltbar zwischen CPU / Speicher / Netzwerk und Letzte 24 Std. / 7 Tage / 30 Tage) samt Lastverteilungsbalken (Compute 42%, Storage 31%, Netzwerk 27%) und rechts drei Schnellaktionen (Node-Skalierung, Rolling Restart, Logs anzeigen). Unten sind eine Tabelle mit sechs Clustern (prod / staging / dev / test / edge / backup-cluster), aktuelle Warnmeldungen und eine isometrische Cluster-Statuskarte angeordnet.
Der Wechsel mehrdimensionaler Trendkurven, die Live-Clustersuche und geschlossene Betriebsaktionen bilden den Kern: Ein Wechsel von Metrik oder Zeitfenster zeichnet die Doppelkurve neu, das Suchfeld filtert Clusterzeilen in Echtzeit, und Klicks auf Neuer Cluster, Node-Skalierung, Rolling Restart, Logs anzeigen oder Alle Warnungen öffnen das jeweilige Aktionspanel.
Chinesischen Originalprompt ansehen
设计并实现「云原生 · 集群监控」运维工作台(1440×900):左侧采用紧凑图标导航栏,顶部提供集群/节点/Pod 全局搜索、运行正常状态徽章与新建集群入口。首屏顶部横向排列集群总数(6)、节点总数(48)、运行中 Pod(432)、集群 CPU 使用率(38.6%)与集群内存使用率(56.3%)五项核心指标;中区左侧为曜石黑「核心集群 prod-cluster」健康度表盘(92/100 评分环及 CPU、内存、磁盘、网络四维水位条),中区中央为支持 CPU/内存/网络与近 24 小时/近 7 天/近 30 天切换的资源使用趋势双线图及计算(42%)、存储(31%)、网络(27%)负载分布条,右侧为节点扩缩容、滚动重启与查看日志三项快捷操作;底部并置六套集群列表(prod / staging / dev / test / edge / backup-cluster)、最近告警列表与云原生集群状态插画卡。
多维监控趋势切换、集群检索与运维动作闭环是这件作品的核心:切换监控指标与时间跨度实时更新双序列曲线,搜索框实时过滤集群行,点击新建集群、扩缩容、滚动重启、查看日志或全部告警均可打开对应操作面板。